

摘要:SU2 是斯坦福大学发起的开源多物理场仿真与优化套件,其离散伴随求解器基于算子重载算法微分(AD),可在一次伴随求解中获得全部设计变量的梯度,是气动/多物理优化的核心能力。本文结合 AIAA Journal 原始论文、2025 年混合并行伴随研究与 NASA Ames 讲座资料,分析 SU2 正问题/伴随问题的负载差异,给出 UltraLAB 工作站分档选型。
适用读者:飞行器气动设计、叶轮机械与风能领域的研发工程师;开展伴随优化与不确定度量化研究的高校团队。
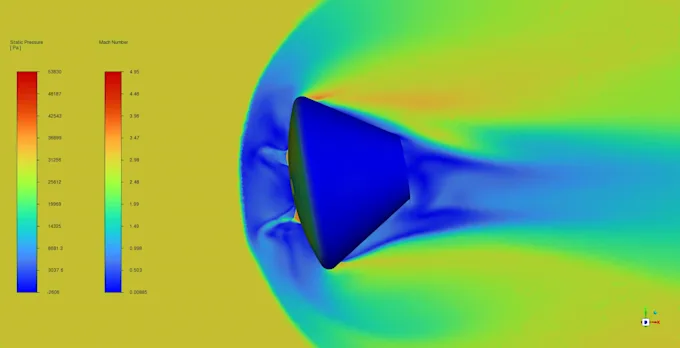
资料背景与核心观点
资料名称:Economon 等《SU2: An Open-Source Suite for Multiphysics Simulation and Design》(AIAA Journal 54(3), 2016, doi:10.2514/1.J053813);《Hybrid parallel discrete adjoints in SU2》(ScienceDirect);NASA Ames AMS 讲座《The Discrete Adjoint Solver in SU2 and its Application to Multiphysics Problems》(讲座页、幻灯 PDF)。
发布机构:SU2 基金会及斯坦福、代尔夫特、凯泽斯劳滕-兰道大学等合作团队。
核心观点:SU2 从 2012 年起发展为覆盖 CFD、湍流/转捩/非平衡模型、共轭传热(CHT)等多物理能力的开源套件,性能上采用 MPI/OpenMP 混合并行、向量化与算法微分快速求导。离散伴随通过算子重载 AD 生成导数代码并以不动点迭代求解;2025 年的研究进一步借助 OpDiLib 把 AD 扩展到 OpenMP 并行,使伴随求解也支持混合并行,并对 MPI 与混合模式在内存和运行时上的差异做了系统对比。伴随问题的内存与磁盘(流场历史存储)代价显著高于正问题,这是硬件规划的要点。
主要功能模块与核心算法
- 流动求解器:Euler/RANS 有限体积求解,SST 等湍流模型、转捩与非平衡流模型;非结构网格。
- 多物理耦合:CHT 共轭传热、滑移网格/叶轮机械接口、不可压流、弹性变形耦合(FEM 结构模块)。
- 离散伴随:算子重载 AD(CoDiPack 类型)生成导数;不动点迭代求解伴随方程;多学科问题中组合多个伴随求解器并处理耦合伴随数据(NASA 讲座重点)。
- 优化框架:FFD 自由变形参数化 + 梯度优化器(SLSQP 等),Python 驱动 shape_optimization.py 工作流。
- 混合并行:MPI 域分解 + OpenMP(正问题早已支持;伴随经 OpDiLib 扩展支持)。
- 场反演与机器学习(FIML):用实验/高保真数据反演湍流模型修正,多攻角 DIRECT 联合训练(社区教程)。
计算特点与性能瓶颈
- 正问题(CFD):典型有限体积非结构网格求解,内存带宽受限的稀疏计算;MPI 扩展到数十核效率良好,单机 32—64 核可用。
- 伴随问题内存显著放大:AD 需存储/重算正问题的中间状态(tape 或检查点),内存常为同网格正问题的数倍;磁盘上还需保存收敛流场历史。2025 年混合并行研究专门对比了 MPI 与混合模式在内存/运行时上的权衡——OpenMP 共享内存可减少 AD 中间量复制。
- 优化工作流是循环负载:每轮 = 正问题求解 + 伴随求解 + 网格变形,几十至上百轮;总耗时以天计,稳定性与检查点机制重要。
- GPU 角色有限:SU2 主线以 CPU 并行为主,GPU 加速不是官方主路径;选型以 CPU 核数、内存带宽和容量为核心。
- I/O:伴随与优化迭代产生大量中间文件(FIML 多攻角案例磁盘需求尤为突出),NVMe 数据盘必要。
典型应用场景
- 翼型/机翼气动外形优化:RANS + 离散伴随 + FFD,网格 10⁶—10⁷ 单元,单轮正/伴随求解在 32 核上数十分钟到数小时,完整优化 1—3 天。
- 叶轮机械多通道优化:滑移网格 + 周期性边界,伴随驱动叶型改进,内存需求随通道数倍增。
- 共轭传热多物理设计:NASA 讲座中的加热圆柱 CHT 优化类问题,多区耦合伴随,需大内存。
- FIML 数据同化:多工况 DIRECT/ADJOINT 联合反演,磁盘与内存均为高负载。
UltraLAB 硬件配置建议
SU2 优化工作流的负载公式 = 正问题(带宽受限)+ 伴随(内存放大)× 优化轮数,选型以多核 CPU、大内存、高内存带宽为主:
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 系统盘/数据盘 | 适用规模 |
|---|---|---|---|---|---|
| 入门档 | 8—16 核高主频 CPU | 64 GB | 不需要 | 1 TB NVMe + 2 TB 数据盘 | 二维翼型/小三维验证、学习伴随优化流程 |
| 主流档 | 16—32 核(高内存带宽平台) | 128—256 GB | 不需要 | 1 TB NVMe 系统盘 + 4 TB NVMe 数据盘 | 三维 RANS 优化、CHT 耦合伴随 |
| 高性能档 | 32—64 核,内存通道插满 | 256—512 GB | 不需要 | 2 TB NVMe + 8 TB NVMe 数据盘 | 千万级网格多学科优化、FIML 多工况反演 |
要点:伴随内存按正问题的 3—5 倍预留是稳健经验;混合并行(MPI×OpenMP)在大网格下可用更少进程降低 AD 中间量复制,配合 2025 年研究的结论做进程/线程配比实测。SU2 官方未提供 GPU 求解主线,不建议为其采购 GPU。优化迭代密集写盘,数据盘选高耐久 NVMe。
软件清单
| 类别 | 软件/工具 | 必需性 | 说明 |
|---|---|---|---|
| 求解器 | SU2(SU2_CFD / SU2_DEF / 伴随模式) | 必需 | 正/伴随/网格变形 |
| AD 组件 | CoDiPack、OpDiLib(混合并行伴随) | 必需 | 算法微分依赖 |
| 前处理 | Gmsh / Pointwise / CGNS 工具链 | 必需(其一) | 非结构网格生成 |
| 优化驱动 | Python(shape_optimization.py)、SciPy 优化器 | 必需 | 优化工作流编排 |
| 后处理 | ParaView、Tecplot | 可选 | 流场与灵敏度可视化 |
常见问题
Q1:离散伴随为什么比正问题吃内存?
AD 需要记录正问题迭代历史(tape/检查点)以反传导数,网格越大历史越长。可用检查点二分策略降低内存,代价是重算时间。
Q2:SU2 的伴随支持多物理耦合吗?
支持。NASA Ames 2024 讲座专门讨论多学科伴随求解器的组合与耦合伴随数据处理,CHT 类两区耦合是成熟示例。
Q3:MPI 和混合并行怎么选?
2025 年 CPC 论文系统对比了两者在内存与运行时上的权衡:MPI 进程多会复制 AD 中间结构、内存更高;混合并行共享内存更省但需 OpDiLib 支持。建议按网格规模实测两种配比。
Q4:SU2 需要 GPU 吗?
官方主线为 CPU 并行,不提供生产级 GPU 求解。把预算投入 CPU 核数、内存容量与带宽更有效。
Q5:完整一次气动优化要多久?
以 10⁷ 单元 RANS、32 核计,单轮正+伴随约 1—2 小时,50—100 轮优化需数天。采用自适应网格与较松的首轮收敛容差可显著缩短总时长。
总结与选型建议
SU2 伴随优化的硬件要点是"内存按正问题数倍预留、核数按单轮求解扩展、磁盘按迭代历史放大"。入门者 16 核 + 64 GB 可跑通二维到中小三维;正式三维优化建议 32 核 + 256 GB;多学科与 FIML 类高负载按 512 GB 内存与 8 TB NVMe 规划。SU2 不需要 GPU,这一条可在采购中直接省下一笔预算并转向内存带宽。
参考来源
- Economon T. D. et al. SU2: An Open-Source Suite for Multiphysics Simulation and Design. AIAA Journal, 54(3), 2016. https://arc.aiaa.org/doi/10.2514/1.J053813
- Burghardt O. The Discrete Adjoint Solver in SU2 and its Application to Multiphysics Problems. NASA Ames AMS Seminar, 2024. https://www.nas.nasa.gov/pubs/ams/2024/09-12-24.html
- Hybrid parallel discrete adjoints in SU2. Computer Physics Communications, 2025. https://www.sciencedirect.com/science/article/pii/S0045793024003591
- SU2 官方网站. https://su2code.github.io/
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800