






从 FDTD、HFSS 到 Icepak:用一套可验证的算力方法,打通光学 I/O、先进封装、SI/PI、热管理与本地 AI 知识库。
适用读者:PIC/硅光工程师、Optical Engine 研发工程师、光学 I/O 工程师、SI/PI 工程师、先进封装工程师、热设计工程师、系统架构师,以及 AI 数据中心与网络基础设施研发负责人。
30 秒看懂本文
CPO(Co-Packaged Optics,共封装光学)的研发难点,不是把光、电、热软件简单放在一起,而是让器件模型、封装寄生、电源完整性、温度场和链路指标形成可追溯的工程闭环。因此,硬件也不能只按“核心越多、GPU 越大”采购:
- FDTD 看网格、显存与带宽:三维网格加密会同时推高空间自由度和时间步数。
- HFSS/热仿真看内存容量、带宽与求解方式:高主频、多核和分布式扩展各有适用边界。
- 参数扫描看任务吞吐:多组独立任务常比盲目堆高单任务核心数更有效,但受许可约束。
- UltraLAB 选型要先做算力画像:软件版本、模型规模、峰值内存、并发数、GPU 兼容性和 HPC 许可缺一不可。
- 本地大模型适合做知识入口,不替代物理求解器:推荐采用“受控模型库+推理服务+RAG 知识库+权限审计”。
目录
- CPO 为什么需要光电热协同仿真
- 核心算法与计算特点
- 典型应用场景与交付指标
- UltraLAB 硬件配置怎么选
- 软件清单与流程组合
- 大模型本地如何部署
- 常见问题:硬件配置分析
- 采购前验收清单
- 参考资料
一、CPO 为什么需要“光电热协同”而不是单点仿真? { #title-sec-1}
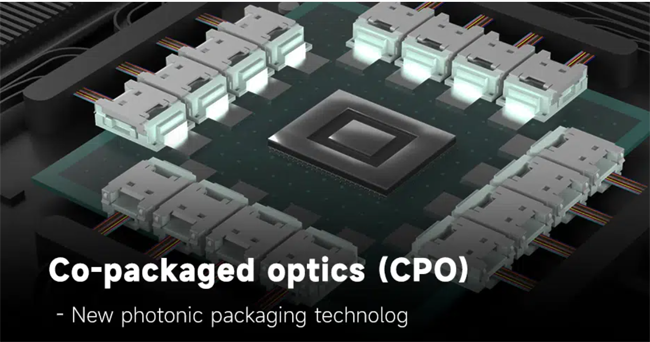
原文以“CPO 赋能 AI 数据中心:光电热协同全栈仿真”为主线,将技术议题划分为 SI/PI、封装散热、光学 I/O 多物理场分析,以及下一代 AI 互连系统平台四个层次。[1] 这反映出一个关键变化:CPO 设计对象已经从单个光子器件,扩展到光芯片、电芯片、先进封装、高速通道、供电网络和散热系统共同构成的多尺度系统。
Ansys 的 CPO 技术资料也给出了类似流程:以 HFSS 分析封装互连,以 AEDT 与 Lumerical INTERCONNECT 完成电—光—电链路协同,并以 RedHawk-SC Electrothermal 和 Icepak 分析多芯粒封装的热完整性。
1.1 三场耦合,实际上耦合的是设计决策
| 物理域 | 需要回答的问题 | 关键输入 | 典型输出 | 对其他域的影响 |
|---|---|---|---|---|
| 光 | 光如何低损耗地耦合、传输和调制? | 几何、材料色散、工艺偏差、温度 | 插损、回损、耦合效率、相位、消光比 | 温度改变折射率与谐振工作点;封装应力也可能引入偏差 |
| 电 | 高速信号和供电是否在封装内保持完整? | 叠层、BGA/TSV、走线、材料、端接 | S 参数、阻抗、串扰、眼图、PDN 阻抗 | 电损耗转化为热;通道响应进入光电链路 |
| 热 | 热源如何扩散,温度是否跨越可靠性与性能边界? | 功耗图、热导率、接触热阻、边界与冷却条件 | 温度场、热流、热阻、热串扰 | 温度映射回光子电路和电热模型,改变系统余量 |
1.2 推荐的全栈工作流
图 1:CPO 光电热协同仿真与算力选型的关系。图中为工程流程示意,不代表特定软件版本的固定接口或许可配置。- 器件级建模:完成波导、耦合器、调制器、探测器等模型,提取可用于系统仿真的紧凑模型。
- 封装与通道建模:提取关键互连的宽带 S 参数,检查阻抗、串扰、回波和供电网络。
- 热完整性分析:将电芯片、光芯片和封装损耗映射为热源,获得温度场与热串扰。
- 光电链路协同:将封装通道和温度映射带入光子电路/链路,评估眼图、BER、裕量与调谐需求。
- 鲁棒性与优化:通过 DOE、灵敏度、参数扫描、蒙特卡洛或伴随优化,寻找兼顾性能、功耗与制造偏差的设计窗口。
- 实测相关性:用测试数据校准材料、边界、损耗和紧凑模型,避免“高分辨率但低相关性”的仿真。
-
二、CPO 相关主题中的主要核心算法,以及计算特点 { #title-sec-2}
2.1 算法—瓶颈—硬件对照表
| 核心算法/方法 | 典型软件与用途 | 计算特点 | 主要硬件瓶颈 | 选型重点 |
|---|---|---|---|---|
| FDTD:有限差分时域 | Lumerical FDTD;耦合器、波导、微纳结构与宽带响应 | Yee 网格上显式推进麦克斯韦方程;一次时域计算可获得宽带结果;三维问题自由度大 | 显存/内存容量、内存或显存带宽、GPU 并行效率 | 优先匹配网格规模与 GPU 支持;大模型不能只看 TFLOPS |
| EME/本征模与 varFDTD | Lumerical MODE;导波器件、传播与模式分析 | 本征值/本征模求解和模式传播;长而均匀的导波结构可避免全三维 FDTD 成本 | 单任务并行收益、矩阵规模、参数扫描吞吐 | 高主频 CPU、适度核心数、充足内存;批量任务可采用多作业并行 |
| RCWA/STACK | Lumerical FDTD 集成环境;周期光栅、多层膜 | 傅里叶模态或多层光学求解;通常比同域全三维 FDTD 更有针对性 | 谐波/阶数、矩阵运算、批量扫描 | 高频 CPU、内存带宽;按实际求解器验证 GPU 是否受益 |
| 漂移扩散+泊松方程 | Lumerical CHARGE;电光调制器与载流子输运 | 非线性偏微分方程离散与迭代;常与热、光模型耦合 | 稀疏求解、内存、收敛迭代 | 高主频、多通道 ECC 内存;先优化网格和初始条件 |
| FEM:有限元全波电磁 | HFSS;BGA、TSV、连接器与三维封装互连 | 自适应网格、频域稀疏矩阵、频率扫描;大模型可采用域分解 | 内存容量与带宽、矩阵求解、频率/域并行、临时文件 I/O | 高主频与大内存并重;核心扩展须结合求解类型和 HPC 许可 |
| 2.5D/布局电磁与电路协同 | SIwave、HFSS 3D Layout、AEDT Circuit;封装/PCB SI/PI | 面向叠层和版图的电磁提取、S 参数与通道/PDN 分析 | 版图规模、频点数、宽带模型、项目读写 | 高频 CPU、大内存、独立 NVMe 项目盘 |
| CFD:有限体积与共轭传热 | Icepak;封装、板级和系统散热 | 压力基求解、流场与能量方程迭代,支持非结构网格;Icepak 使用 Fluent CFD 求解引擎。[8] | 网格量、内存带宽、迭代收敛、并行通信 | 均衡核心数与内存带宽;GPU 加速须逐项核对版本和物理模型 |
| 紧凑模型时域/频域仿真 | Lumerical INTERCONNECT;PIC、WDM 与电光链路 | 以器件紧凑模型替代全场计算;长瞬态、多通道和统计分析增加成本 | 单线程/少线程性能、长序列数据、采样点与 Monte Carlo 任务数 | 高主频 CPU;扫描任务重时增加作业并发和快速存储 |
| 伴随法与逆向设计 | FDTD+优化框架;器件性能与几何优化 | 每轮通常涉及前向与伴随场计算及梯度更新;迭代次数多 | GPU/CPU 吞吐、场数据存储、显存与任务调度 | 优先加速单轮求解,同时控制场监视器和检查点数据量 |
| DOE、代理模型、鲁棒性优化 | optiSLang 等;多物理参数搜索与制造偏差分析 | 大量独立或弱耦合仿真任务;代理模型降低后续评估成本 | 并发作业数、许可、队列调度、结果汇总 I/O | 以“每日完成的设计点数”衡量,而非只追求单机峰值核心数 |
2.2 为什么 FDTD 网格一加细,成本会快速上升?
Ansys 对三维 FDTD 的计算时间给出了近似标度关系:[3]
[ T \propto V\left(\frac{l}{\Delta x}\right)^4 ]
其中,(V) 为仿真体积,(\Delta x) 为空间网格尺寸。对固定尺寸的三维区域,若三个空间方向的网格尺寸都减半,空间网格数约增至 8 倍;时间步通常还需同步缩短,因此总计算量可近似增至 16 倍。这也是“先验证网格收敛,再追求更细网格”的直接原因。
2.3 为什么不能只用“CPU 核心数”评估 CPO 工作站?
- 串行阶段不会随核心数线性加速:几何处理、模型构建、部分前后处理和某些矩阵阶段更依赖高主频。
- 内存带宽可能成为瓶颈:FDTD、CFD 和大规模稀疏求解都需要持续搬运数据。
- 并行存在许可与算法边界:可用核心数不等于已授权核心数,也不等于当前求解器能有效利用的核心数。
- 任务并行与单任务并行不同:参数扫描可通过多个独立作业提高吞吐;单个超大模型则更依赖单节点内存、域分解和节点间通信。
三、应用场景:CPO 全栈仿真如何服务研发决策? { #title-sec-3}
| 应用场景 | 建议仿真组合 | 关键评价指标 | 算力特征 |
|---|---|---|---|
| 光纤—芯片耦合与光学 I/O | FDTD/MODE → 紧凑模型 → INTERCONNECT | 耦合效率、插损、回损、偏振与波长敏感性、工艺容差 | 网格和 GPU 显存敏感;扫描任务多 |
| 调制器与热调谐器件 | CHARGE/HEAT+FDTD/MODE → CML | 调制效率、带宽、消光比、谐振漂移、调谐功耗 | 非线性求解与多物理迭代,重视收敛和模型相关性 |
| CPO 先进封装高速互连 | HFSS/SIwave → AEDT Circuit | S 参数、阻抗、插损、回损、串扰、眼图 | 大内存、频率扫描与版图数据处理 |
| 多芯粒封装供电与电热 | RedHawk-SC ET/SIwave+Icepak | PDN 阻抗、压降、电流、功耗密度、温度热点 | 大规模数据、稀疏求解与多工具数据交换 |
| 封装与系统散热 | Icepak,必要时联动 Mechanical | 结温/壳温、热阻、热串扰、流阻、热应力风险 | CFD 网格与迭代敏感;多工况适合并行 |
| 端到端光电链路 | HFSS/SIwave+INTERCONNECT | 眼图、BER、TDECQ、链路裕量、温漂与均衡需求 | 长瞬态、多通道、统计扫描,重视 CPU 频率与任务吞吐 |
| 工艺偏差与良率 | optiSLang+INTERCONNECT/FDTD | 灵敏度、良率、鲁棒设计窗口、失效边界 | 大量独立任务,集群吞吐和许可调度优先 |
| 企业仿真知识库 | 本地 LLM+RAG+受控文档库 | 检索命中率、引用可追溯率、答案正确率、权限隔离 | 显存、上下文长度、并发与文档解析能力 |
边界提醒:CPO 并非对所有互连场景的统一替代方案。是否采用 CPO,应结合带宽密度、能效、可维护性、良率、测试、供应链与系统架构综合判断。
四、UltraLAB 硬件配置怎么选?先看工作负载,再谈参数 { #title-sec-4}
UltraLAB 公开的 AE450 系列侧重高主频与多核兼顾,公开平台支持 AMD EPYC 9005、最高 1.5 TB DDR5 ECC 和双 GPU 扩展;GR450P 系列则提供 Threadripper PRO 7000WX、最高 1 TB 内存及多 PCIe 扩展能力。[9][10] 这些平台能力为 CPO 多物理场计算提供了配置空间,但平台最大值不等于每个项目的推荐值,也不等同于 Ansys 官方认证配置。
4.1 四档参考配置
下表是基于算法特征形成的采购基线,不是固定 SKU、性能承诺或软件官方最低配置。GPU 型号、数量、驱动、操作系统、求解器和 HPC/GPU 许可必须在下单前联合核验。
| 档位与典型团队 | UltraLAB 平台建议 | CPU 建议 | 内存建议 | GPU 建议 | 存储建议 | 更适合的任务 |
|---|---|---|---|---|---|---|
| A:器件与链路研发 | AE450 高频工作站 | 24–32 核高频型号,如 EPYC 9275F/9375F 级别 | 256 GB ECC,预留升级 | 1×24–48 GB;仅选择当前版本支持的 GPU | 2 TB 系统盘+4 TB NVMe 项目/暂存盘+独立备份 | 中小规模 FDTD、MODE、INTERCONNECT、局部封装与热分析 |
| B:主流光电热协同 | AE450 高频大内存工作站 | 32–64 核,如 EPYC 9475F/9575F 级别 | 512 GB ECC;复杂模型可向 768 GB 以上扩展 | 1×48–96 GB 专业/计算 GPU,按 FDTD 或其他求解器兼容清单确定 | 2 TB 系统盘+8 TB 高性能 NVMe 暂存+项目存储与备份 | 多物理场协同、较大 FDTD、HFSS 频扫、Icepak、多参数扫描 |
| C:大型封装与逆向设计 | GR450P 大内存多扩展工作站 | 64–96 核,如 Threadripper PRO 7985WX/7995WX 级别 | 512 GB–1 TB ECC,按实测峰值配置 | 1–2×48–96 GB;多 GPU 是否加速必须按作业验证 | 系统、项目、暂存分层;8–16 TB NVMe+RAID 项目盘+异地/离线备份 | 大型电磁与热模型、伴随优化、多作业吞吐、局部团队共享 |
| D:团队级计算节点 | UltraLAB 定制计算节点/集群 | 以高频多核节点为主,不为追求总核心数牺牲单节点内存带宽 | 每节点 512 GB–1.5 TB,按模型和并发切分 | 按 GPU 求解作业池配置;避免为不支持 GPU 的流程堆卡 | 共享项目存储+本地 NVMe 暂存;25/100 GbE 或更低延迟互连按实测选择 | 多用户、DOE/Monte Carlo、分布式求解、统一排队与许可调度 |
4.2 内存:用峰值数据配置,而不是套用“每核多少 GB”
推荐采用下面的工程估算:
[ M_{配置} \ge M_{实测峰值} \times K_{模型增长} \times N_{并发} \times K_{余量} ]
- (M_{实测峰值}):同类型代表作业的峰值物理内存;
- (K_{模型增长}):未来网格、自由度和频点增长系数;
- (N_{并发}):同一节点真正同时运行的作业数;
- (K_{余量}):通常先取 1.2–1.3,再通过测试修正。
不要依赖交换分区挽救长期内存不足。交换可以让部分作业勉强继续,却不能把 NVMe 变成等效内存;频繁换页往往意味着吞吐量失控。对于全新模型,应先用小、中、大三组样例测量标度,再外推目标模型。
4.3 GPU:先回答“哪个求解器、哪个版本、哪种模型”
GPU 采购应依次通过四道门:
- 功能门:目标求解器和所需物理模型是否支持 GPU?
- 容量门:网格、场数据与中间量能否装入单卡或受支持的多卡域?
- 性能门:用同一模型、同一精度、同一收敛标准比较 CPU 与 GPU 的总耗时。
- 许可门:GPU 与多节点能力是否需要额外 HPC 许可?
多 GPU 的显存不能默认视为一个透明的大显存池;多卡也不会自动加速所有任务。对独立参数扫描,多卡可承担多作业吞吐;对单个大作业,则要看求解器是否支持相应分解和通信方式。
4.4 CPU:高主频与多核心如何取舍?
| 工作负载 | 更优先的方向 | 原因 |
|---|---|---|
| 前后处理、电路/紧凑模型、部分串行阶段 | 高主频、适度核心数 | 串行或低并行阶段占比高 |
| 单个大 HFSS/CFD 模型 | 高主频+均衡核心+大内存带宽 | 矩阵求解与迭代既吃计算,也吃数据供给 |
| 多个独立参数点/工况 | 更多可用核心或多节点 | 任务级并行更容易转化为日吞吐量 |
| 分布式超大模型 | 单节点内存+节点互连+软件扩展效率 | 通信和负载均衡会限制核心扩展 |
4.5 存储与网络:把暂存盘、项目盘和备份分开
- 系统盘:操作系统、软件和开发环境,建议独立 SSD。
- 暂存盘:矩阵临时文件、网格和检查点,优先高耐久、高持续写入的 NVMe,并监控剩余空间与写入寿命。
- 项目盘:模型、结果和版本数据,按团队容量与并发选择 RAID/共享存储。
- 备份:RAID 不是备份。重要项目采用至少“生产副本+独立备份+离线或异地副本”的策略。
- 网络:只有分布式求解或共享存储测试证明存在瓶颈后,才决定升级高速互连;不要仅凭端口速率推断求解速度。
五、CPO 软件清单:按流程组合,而不是按名称堆叠 { #title-sec-5}
| 流程层 | 软件/模块 | 主要任务 | 与其他模块的关键数据 |
|---|---|---|---|
| 光子器件 | Ansys Lumerical FDTD | 全波光子器件、光栅、耦合与宽带响应;集成 FDTD、RCWA、STACK。[4] | 场分布、S 参数、器件响应、紧凑模型输入 |
| 导波与模式 | Ansys Lumerical MODE | 模式、传播与导波器件分析 | 有效折射率、模式与传播响应 |
| 光电器件 | Ansys Lumerical CHARGE/HEAT | 载流子输运、电热与器件工作点 | 电光响应、温度相关材料与器件参数 |
| 紧凑模型 | Ansys Lumerical CML Compiler | 将仿真/测试数据组织为可复用紧凑模型库 | 器件模型、工艺角、温度依赖 |
| 光子电路与链路 | Ansys Lumerical INTERCONNECT | PIC、WDM、光电协同、时域/频域与统计分析。[5] | 紧凑模型、封装 S 参数、温度图、眼图/BER |
| 三维高频电磁 | Ansys HFSS | 封装互连、连接器、三维结构与 S 参数提取;支持 SI/PI 工作流。[6] | 宽带 S 参数、场与损耗数据 |
| 封装/PCB SI/PI | Ansys SIwave、HFSS 3D Layout、AEDT Circuit | 叠层版图、电源与信号完整性、通道协同 | S 参数、PDN、RLCG/电路模型、直流损耗 |
| 芯片级电热 | Ansys RedHawk-SC Electrothermal | 多芯粒功耗、电源与热完整性 | 芯片级热模型、功耗图、温度相关信息 |
| 电子散热 | Ansys Icepak | 封装、PCB、机箱与系统级热流分析。[8] | 温度图、热流、边界条件、热模型 |
| 结构可靠性 | Ansys Mechanical(按需) | 热变形、热应力与封装可靠性 | 温度场、位移、应变与应力 |
| 优化与鲁棒性 | Ansys optiSLang | DOE、灵敏度、代理模型、优化与统计分析 | 参数、响应、约束、设计点与鲁棒性指标 |
| 自动化 | PyLumerical、PyAnsys/PyAEDT、Python | 批量建模、求解提交、数据交换、结果与元数据管理 | 参数化模型、任务队列、结构化结果与报告 |
| 本地 AI | Ollama 或 vLLM+Open WebUI+向量检索 | 私有知识问答、规范检索、报告辅助与脚本辅助 | 带来源和版本的知识片段、权限与审计记录 |
许可与版本提示:上述清单用于说明能力地图,不表示每个项目都需要全部采购。具体产品归属、接口、GPU/HPC 能力和支持平台随版本与授权变化,应以 Ansys 官方文档、订单和实际测试为准。
六、大模型本地如何部署?为 CPO 团队建立可追溯的私有知识入口 { #title-sec-6}
本地大模型最适合承担规范检索、历史项目问答、仿真报告归纳、脚本辅助和故障知识导航,不应直接替代经过验证的物理求解器,也不应未经复核生成签核结论。
6.1 先算显存:权重只是起点
模型权重的理论容量可近似写为:
[ M_{权重}\approx\frac{P\times b}{8} ]
其中 (P) 为参数量,(b) 为每参数比特数。实际运行还需为 KV Cache、激活、运行时、上下文和并发预留空间。下表是初步筛选范围,不是对任意模型架构和上下文长度的保证。
| 模型规模与精度示例 | 仅权重的常见量级 | 建议起步显存 | 适用说明 |
|---|---|---|---|
| 7B–8B,4 bit 量化 | 约 4–6 GB | 12–16 GB | 单人知识问答、轻量脚本辅助 |
| 14B,4 bit 量化 | 约 8–10 GB | 16–24 GB | 更高质量问答,仍须控制长上下文与并发 |
| 30B–34B,4 bit 量化 | 约 18–24 GB | 32–48 GB | 专业知识库与代码辅助的常见验证档位 |
| 70B,4 bit 量化 | 约 40–48 GB | 64–96 GB 或受支持的多卡方案 | 更复杂推理;需重点测试 KV Cache 和吞吐 |
| 7B–8B,FP16/BF16 | 约 14–16 GB | 24 GB 以上 | 未量化推理或特定精度验证 |
长上下文会显著增加 KV Cache;MoE 模型还要区分总参数与激活参数。最终应以目标模型的真实权重、推理引擎日志和并发压测为准。
6.2 两种部署路径
| 路径 | 适合对象 | 优点 | 注意事项 |
|---|---|---|---|
| Ollama:单机快速验证 | 个人工程师、小团队 PoC | 安装和模型管理简洁,便于本地 API 验证 | 生产并发、权限、监控和版本治理仍需额外建设 |
| vLLM:团队推理服务 | 多用户、RAG、内部 API | 提供 OpenAI 兼容服务路径,适合容器化和服务化集成 | 需固定镜像版本、模型版本和驱动组合,并进行并发压测 |
6.3 路径 A:Ollama 快速启动
以下示例在受支持的 Linux+NVIDIA 环境中执行。安装前先阅读官方文档并核验脚本、驱动与模型许可;Ollama 官方提供 Linux 安装命令。[11]
# 1. 检查 GPU 与驱动
nvidia-smi

# 2. 安装 Ollama(生产环境应先审计安装脚本)
curl -fsSL https://ollama.com/install.sh | sh

# 3. 拉取并运行一个经许可核验的 8B 示例模型
ollama pull qwen3:8b
ollama run qwen3:8b

# 4. 查看运行中的模型及资源状态
ollama ps
调用本地 API:
curl http://127.0.0.1:11434/api/generate \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3:8b",
    "prompt": "请用表格总结FDTD仿真的主要硬件瓶颈,不要编造性能数据。",
    "stream": false
  }'
6.4 路径 B:vLLM 容器化服务
vLLM 官方提供 vllm/vllm-openai 容器镜像及 OpenAI 兼容服务方式。[12] 下面示例假设模型已离线下载到 /data/models/Qwen3-8B,并要求将 <PINNED_VERSION> 替换为经过验证的镜像版本,而不是直接使用浮动标签。
docker run --rm --gpus all --ipc=host \
  -p 127.0.0.1:8000:8000 \
  -v /data/models:/models:ro \
  -e HF_HUB_OFFLINE=1 \
  vllm/vllm-openai:<PINNED_VERSION> \
  --model /models/Qwen3-8B \
  --served-model-name cpo-assistant \
  --max-model-len 32768
验证接口:
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "cpo-assistant",
    "messages": [
      {"role": "system", "content": "你是CPO仿真知识助手,回答必须给出来源,不确定时明确说明。"},
      {"role": "user", "content": "HFSS与Lumerical FDTD在CPO流程中分别解决什么问题?"}
    ],
    "temperature": 0.2
  }'
6.5 建立 CPO RAG 知识库:五个必要步骤
- 文档治理:只纳入有权使用的 PDK、材料数据、仿真规范、报告和故障记录;按密级隔离。
- 结构化切分:按标题、表格、图号和版本切分,保留“来源文件—页码/章节—软件版本—项目—权限”元数据。
- 检索与重排:采用嵌入模型+向量索引,必要时增加关键词混合检索和重排;表格与公式应保留原始链接。
- 强制引用:回答必须返回可点击来源;无依据时拒答,不让模型补写材料参数、测试结果或许可条款。
- 建立评测集:至少覆盖规范事实、跨文档比较、版本差异、故障定位和权限越界五类问题,持续记录检索命中率与答案正确率。
6.6 安全上线清单
-
默认仅绑定
127.0.0.1;团队访问通过内网网关、TLS、身份认证和访问控制,不直接暴露推理端口。 - 模型、容器和依赖固定版本并记录哈希;离线环境关闭不必要的外联与遥测。
- 对提示词、检索文档、输出和用户权限保留审计,但避免日志重复记录敏感正文。
- 仿真签核、材料参数和对外技术结论必须由工程师复核。
- 以首 Token 延迟、输出速度、并发吞吐、显存峰值和检索正确率验收,而不是只验收“能否聊天”。
七、常见问题:CPO 仿真与本地 AI 的硬件配置分析 { #title-sec-7}
Q1:96 核一定比 32 核高频工作站更适合 CPO 吗?不一定。单个低并行任务可能更受益于高主频;多个独立参数点则更受益于多核心或多节点。应分别测试单任务耗时和每日任务吞吐,并计入 HPC 许可。
Q2:CPO 全栈仿真是否需要 1 TB 内存?不是所有项目都需要。内存应由代表模型峰值、增长系数和并发数决定。局部光学或链路仿真可能远低于 1 TB;大型全波、热模型或多作业并发则可能需要。先测峰值,再决定容量。
Q3:显卡显存越大,FDTD 就越快吗?不是。显存首先决定能否容纳作业,速度还受 GPU 计算与带宽、网格、内核效率、CPU 数据准备和软件版本影响。必须在相同精度与收敛条件下做 CPU/GPU 对比。
Q4:多 GPU 能否把显存自动合并,并让所有求解器提速?不能默认这样理解。多卡加速取决于求解器的分解、通信与软件支持;显存也不是天然透明的统一池。对独立参数扫描,多卡常表现为多作业吞吐;对单个大作业,需要专门验证。
Q5:仿真与大模型可以共用一台 UltraLAB 工作站吗?可以做验证和小规模共用,但生产环境建议资源隔离。FDTD 可能占满 GPU,大模型又会长期占用显存;同时运行容易互相挤占内存、显存和 I/O。可采用分卡、分时段、容器配额或独立推理节点。
Q6:为什么高速 NVMe 已配置,仿真仍然很慢?NVMe 主要改善项目读写、临时文件和结果落盘,无法弥补内存不足、低效网格、难收敛模型或不合理的核心分配。应同时查看 CPU 利用率、内存峰值、换页、暂存 I/O 和求解日志。
Q7:Windows 与 Linux 应如何选择?交互建模可按团队习惯选择;批量求解、容器化 AI、集群调度和自动化通常更偏向 Linux。最终必须以每个软件版本的官方支持矩阵为准,不要假设所有模块在两个平台具有相同能力。
Q8:本地大模型能否直接给出 CPO 仿真签核结论?不能。大模型可辅助检索、解释和生成初稿,但不能替代网格收敛、材料与边界校准、实测相关性、求解器验证和工程师签核。所有关键参数与结论都应追溯到受控来源。
Q9:消费级 GPU 能否用于生产仿真或本地大模型?需分别评估。消费级 GPU 可能在部分任务中具有成本优势,但显存容量、ECC、虚拟化、驱动支持、散热、保修与软件许可可能不同。生产采购应以软件支持、稳定性测试和总拥有成本为依据。
Q10:采购前最有价值的一项测试是什么?使用客户自己的代表模型做基准测试:固定模型、软件版本、精度与收敛标准,记录总耗时、峰值内存/显存、暂存 I/O、扩展效率和结果一致性。该测试通常比通用跑分更接近真实投资回报。
八、采购前验收清单:让 UltraLAB 配置对应真实研发指标 { #title-sec-8}
| 验收维度 | 需要提供的输入 | 应得到的证据 |
|---|---|---|
| 软件环境 | 产品、版本、操作系统、求解器、插件、许可类型 | 支持矩阵与许可核对结果 |
| 模型规模 | 网格/自由度、频点、时间步、工况、扫描点 | 代表模型清单与增长预测 |
| 资源峰值 | 内存、显存、暂存容量、I/O、作业日志 | 峰值曲线与瓶颈定位 |
| 性能目标 | 单作业时限、每日设计点、并发用户 | 同模型基准测试与吞吐报告 |
| 结果质量 | 精度、收敛、网格无关性、实测相关性 | 结果一致性与误差说明 |
| 可扩展性 | 未来模型增长、团队人数、节点与 GPU 扩展 | 升级路径与剩余扩展空间 |
| 可靠性 | 7×24 负载、散热、供电、ECC、备份与恢复 | 稳定性测试和恢复演练 |
| 本地 AI | 模型、量化、上下文、并发、知识库密级 | 显存压测、引用正确率与权限测试 |
结语:真正有效的算力,是缩短下一轮设计迭代
CPO 全栈仿真的价值,不在于把更多软件装进一台机器,而在于建立一条从物理模型到系统指标、从计算资源到研发节奏的可验证路径。真正值得投资的,也不是参数表上最大的数字,而是经过真实项目证明的有效吞吐、稳定性和扩展能力。
UltraLAB 建议从一份“CPO 算力画像”开始选型:提交软件版本、代表模型、网格规模、峰值资源、并发任务、许可条件与目标周期,再形成 CPU、内存、GPU、存储和网络的分档方案,并以同模型测试完成交付验收。这样,工作站才不是孤立的硬件采购,而是光电热协同研发流程的一部分。
说明与参考资料 { #sec-9}
内容说明:本文是基于所给链接主题创作的技术选型软文。工程建议用于采购前分析,不构成 Ansys 官方硬件认证、固定配置报价或性能保证。产品名称与商标归各自权利人所有;软件功能、接口与许可请以实际版本和合同为准。
- Ansys 微信公众号原文:虚拟会议|CPO 赋能 AI 数据中心:光电热协同全栈仿真,访问日期:2026-10-30。
- Ansys:Thermal and Signal Integrity Analysis of Multi-Die Packages for CPO,CPO 封装、SI 与热完整性工作流。
- Ansys:What is Finite-Difference Time-Domain (FDTD)?,FDTD 原理、应用、挑战与计算标度。
- Ansys Lumerical FDTD 产品页,FDTD、RCWA、STACK、HPC/GPU 与多物理场能力。
- Ansys Lumerical INTERCONNECT 产品页,PIC、紧凑模型、时域/频域和统计仿真。
- Ansys HFSS 产品页,三维全波电磁、SI/PI、HPC 与多物理场流程。
- Ansys HFSS Technical Notes,FEM、S 参数与域分解技术说明。
- Ansys Icepak 文档:What is Ansys Icepak?,Fluent CFD 求解引擎、非结构网格、压力基与多重网格算法。
- UltraLAB:AE450 电磁仿真全能高频工作站,平台公开扩展规格。
- UltraLAB:GR450P 电子系统仿真超频工作站,平台公开扩展规格。
- Ollama 官方 Linux 文档,安装、服务、驱动与日志。
- vLLM 官方 Docker 部署文档,官方镜像、OpenAI 兼容服务与容器示例;生产使用时应查阅对应安装版本文档。
结构化摘要:CPO 仿真硬件选型的核心顺序是“软件与算法 → 模型规模 → 内存/显存 → 并发与许可 → 真实模型测试”;本地大模型用于可追溯知识检索,不替代物理仿真与工程签核。
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



