

摘要:OpenROAD 以"24 小时无人干预 RTL-to-GDS"为目标,把综合后端到签核前的全部步骤建在共享内存数据库(OpenDB)之上。本文梳理其布局、时钟树、布线与静态时序的算法构成,分析物理设计"大内存图算法 + 有限多线程 + 设计点批量"的负载特征,给出 UltraLAB 工作站分档选型。
适用读者:集成电路方向高校师生、开源芯片(RISC-V 等)设计团队、创业公司前端/后端工程师。
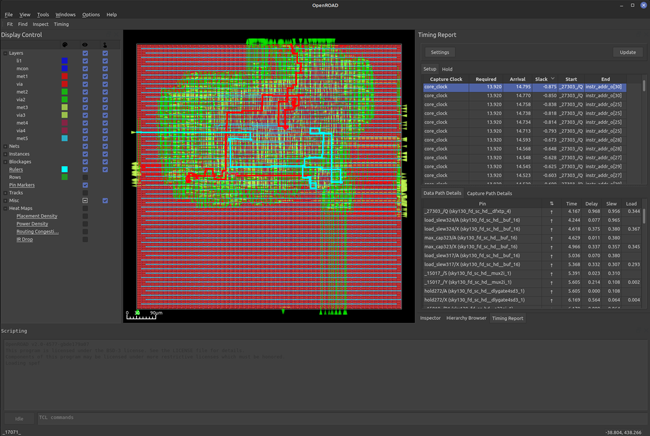
资料背景与核心观点
资料名称:The OpenROAD Project 官方组织与文档(github.com/The-OpenROAD-Project、openroad.readthedocs.io);OpenROAD Flow Scripts 用户指南(openroad-flow-scripts.readthedocs.io);OpenROAD Project 综述(Wikipedia)。
发布机构:The OpenROAD Project(源于 DARPA IDEA/POSH 计划,UCSD 等主导)。
核心观点:OpenROAD 的两大基石是"开放"与"自主":所有引擎共享 OpenDB 内存数据模型,经 LEF/DEF 标准格式衔接;流程为 Yosys(逻辑综合)→ OpenROAD(Floorplan→布局→CTS→布线)→ KLayout(GDS 合并与 DRC/LVS)。详细布线器 TritonRoute 采用引脚接入、轨道分配与迭代 search-and-repair 的迷宫布线,内置 DRC 引擎保证布线即合规。项目支持 SkyWater130、GF180 等开放 PDK 及 ASAP7 预测性 7nm PDK,并以 AutoTuner 做 PPA 超参搜索——后者把单次流片运行放大为批量负载。
主要功能模块与核心算法
- 逻辑综合:Yosys 读 Verilog + Liberty,生成门级网表载入 OpenDB。
- Floorplan 与布局:全局/详细布局引擎处理标准单元与宏模块,含拥塞与时序驱动。
- 时钟树综合(CTS)与优化:建立/保持时间修复、缓冲插入。
- 布线:全局布线 + TritonRoute 详细布线(A*/Lee 变体的 search-and-repair,布线中内嵌 DRC 检查)。
- 静态时序与寄生:OpenSTA 时序分析、OpenRCX 寄生提取。
- 签核衔接:导出 DEF/GDS,外部 KLayout/Magic/Netgen 做 DRC/LVS。
- AutoTuner:基于 METRICS2.1 的超参搜索框架,用 TensorBoard 追踪 PPA,把单设计点扩展为数十上百次流程运行。
计算特点与性能瓶颈
- 大内存图算法:网表与布线图常驻 OpenDB,百万实例级设计内存可达数十到上百 GB;访问模式不规则,缓存与内存延迟敏感。
- 多线程有限:各引擎支持多线程但扩展性因阶段而异(布局/全局布线较好,详细布线与 STA 次之),单机 16—32 核是甜区;EDA 工具普遍不是"核越多越好"。
- 单核性能敏感:STA、时序驱动优化等路径有大量串行图遍历,高主频直接缩短迭代周期。
- 批量维度:AutoTuner 与多设计点/多 PDK 探索把负载变为任务级并行,核心数转化为并发流程数。
- I/O 与 GUI:LEF/DEF/GDS 读写与中间结果存档需要较快磁盘;GUI 查看版图需一块普通显卡即可,不需要计算卡。
典型应用场景
- 教学与流片实践:sky130/ibex 等官方教程设计,单流程 30 分钟级,8—16 核入门档即可(官方示例即此量级)。
- RISC-V SoC 物理设计研究:百万实例级,16—32 核 + 128 GB 内存保障详细布线与 STA 迭代。
- PPA 探索与 AutoTuner:数十设计点并发,32—64 核按"每流程 4—8 核"切分,吞吐近线性。
- EDA 算法研究:新布局/布线算法在 OpenDB 上原型验证,需要大内存与快速构建工具链。
UltraLAB 硬件配置建议
OpenROAD 的负载 = 单流程(大内存 + 中高主频 + 有限线程)× 批量并发(AutoTuner/多设计点):
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 系统盘/数据盘 | 适用规模 |
|---|---|---|---|---|---|
| 入门档 | 8—16 核高主频 CPU | 64 GB | 不需要(GUI 用普通显卡) | 1 TB NVMe | sky130/gf180 教学设计、官方教程 |
| 主流档 | 16—32 核高主频 | 128—256 GB | 不需要 | 1 TB NVMe 系统盘 + 2—4 TB NVMe 数据盘 | 百万实例级 SoC 后端、多设计点探索 |
| 高性能档 | 32—64 核(按并发流程切分) | 256—512 GB | 不需要 | 2 TB NVMe + 4—8 TB NVMe(设计存档) | AutoTuner 大规模 PPA 搜索、多团队共享 |
注意:OpenROAD 不需要 GPU(社区在探索 ML 辅助调参与个别加速研究,但主流程为 CPU);内存宁多勿少——详细布线峰值常超预估。AutoTuner 并发数按"总内存 ÷ 单流程峰值内存"估算,而非按核数。商业签核(PrimeTime/Calibre 类)若并存,其许可证通常限线程数,核心规划应同时核对 EDA 许可证条款。
软件清单
| 类别 | 软件/工具 | 必需性 | 说明 |
|---|---|---|---|
| 综合 | Yosys | 必需 | RTL 到门级网表 |
| 后端引擎 | OpenROAD(OpenDB、布局/CTS/布线) | 必需 | 物理设计核心 |
| 时序/寄生 | OpenSTA、OpenRCX | 必需 | 签核前分析 |
| 版图与验证 | KLayout、Magic、Netgen | 必需(其一组合) | GDS 查看、DRC/LVS |
| 调参 | AutoTuner + TensorBoard | 可选 | PPA 超参搜索 |
| PDK | SkyWater130 / GF180 / ASAP7 | 必需(至少其一) | 工艺设计包 |
常见问题
Q1:OpenROAD 支持多大设计?
官方目标是无人干预的全流程,社区已在 ASAP7 上跑 RISC-V 核级设计;百万实例级在 128—256 GB 内存工作站上可行,更大设计建议拆分层级或上服务器级内存。
Q2:为什么 32 核以上加速不明显?
物理设计各阶段含大量串行图算法与全局耦合,线程扩展有限是 EDA 共性。把多余核心用于并发跑多个设计点或 AutoTuner 试验更划算。
Q3:需要专业显卡吗?
不需要。版图 GUI 是常规 2D/轻 3D 渲染,入门显卡即可;OpenROAD 主流程无 GPU 加速路径。
Q4:和商业工具(Innovus/ICC2)比,硬件需求有何不同?
量级相近(大内存 + 中高主频 + 有限线程),但商业工具按许可证限线程/任务数,采购核心数前应核对 license;OpenROAD 无此限制,适合把并发打满。
Q5:AutoTuner 一次搜索要多少资源?
数十到上百次完整流程运行。按单流程 4—8 核、30 分钟—数小时估算,32 核工作站可同时开 4—8 个试验,一轮搜索以天计——这是高性能档的主要驱动力。
总结与选型建议
OpenROAD 选型三原则:主频优先、内存富余、核数换成并发。教学与开源 PDK 实践 16 核 + 64 GB 即可;SoC 级后端研究 32 核 + 256 GB 是稳妥配置;AutoTuner 类批量探索按并发数线性扩展核数与内存。全流程不需要 GPU,把预算留给内存与 NVMe 存档盘。商用签核工具并存时,先核对许可证的线程与任务限制再定核心数。
参考来源
- The OpenROAD Project(GitHub 组织). https://github.com/The-OpenROAD-Project
- OpenROAD Flow 用户指南. https://openroad-flow-scripts.readthedocs.io/en/latest/user/UserGuide.html
- OpenROAD Project(架构与流程综述). https://en.wikipedia.org/wiki/OpenROAD_Project
- Ajayi T. et al. Toward an open-source digital flow: First learnings from the OpenROAD project. DAC 2019(引用信息见官方仓库). https://github.com/The-OpenROAD-Project/OpenROAD-flow-scripts
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800