






摘要与适用读者
工业 CT 与显微 CT 的体素规模正快速迈向 2048³—4096³ 甚至更大,传统解析重建(FBP/FDK)虽快,但在低剂量、少视角、金属伪影等场景下精度不足,迭代重建(SIRT、CGLS、TV 正则化等)成为科研与高端检测的标配——代价是计算量数十倍于解析法。本文依据 TIGRE 工具箱“多 GPU 任意大规模迭代重建”论文与荷兰 CWI 的 ASTRA kernelkit 技术资料,提炼工具链能力边界与硬件需求,为工业无损检测、同步辐射/显微 CT 用户提供 UltraLAB 分档选型方案。
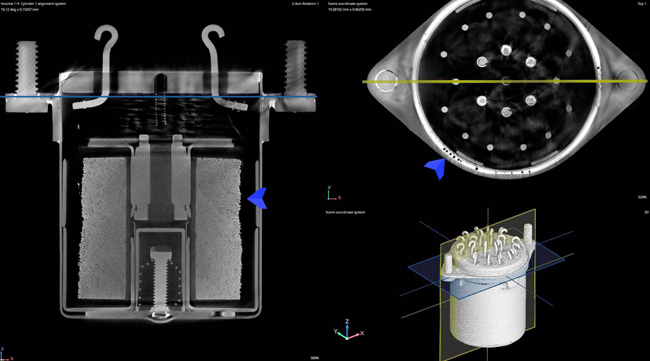
资料背景与核心观点
- 资料一:Arbitrarily large iterative tomographic reconstruction on multiple GPUs using the TIGRE toolbox(arXiv:1905.03748)
- 资料二:ASTRA kernelkit: GPU-accelerated projectors for computed tomography(荷兰 CWI 研究所技术报告)
- 原文链接:https://arxiv.org/abs/1905.03748;https://ir.cwi.nl/pub/34711/34711.pdf
TIGRE 论文的核心观点:迭代重建的精度优势已被公认,但“体积太大放不进单张 GPU 显存”是实用化的最大障碍;TIGRE 通过在多 GPU 间自动分块(volume splitting)与流水线调度,实现了不受单卡显存限制的任意大规模迭代重建。ASTRA kernelkit 资料则显示:ASTRA 的投影/反投影算子(FP/BP)基于 NVIDIA CUDA 内核实现,用户通过 Python-Cython 接口调用 FBP、FDK、CGLS、SIRT 等算法,3D 数据直接进入 CUDA 投影器并行计算——FP/BP 是迭代重建每轮迭代的绝对耗时主体。
主要功能模块或核心算法
- 投影/反投影算子(FP/BP):基于 CUDA 的光线驱动/体素驱动投影内核,匹配平行束、扇形束、锥形束几何。
- 解析重建:FBP(平行/扇形束)、FDK(锥形束),单遍计算,速度快。
- 迭代代数重建:SIRT、SART、CGLS 等,每轮迭代含一次 FP+一次 BP。
- 正则化迭代与先进算法:TIGRE 提供 TV-POCS、OS-SART 等全变差正则化与有序子集加速算法。
- 多 GPU 体积分块调度(TIGRE):将重建体自动切块分配到多卡,突破单卡显存墙。
计算特点与性能瓶颈
- FP/BP 为耗时主体:迭代法每轮两次全投影计算,锥形束 3D 投影是计算与访存双重密集,GPU 加速效果显著(相对 CPU 常有数量级提升)。
- 显存是规模硬约束:单卡需同时容纳体数据与正弦图;2048³ 体素单精度即占约 34 GB,4096³ 超过 270 GB,必须多卡分块或选择 TIGRE 的显存外调度。
- CPU 与 I/O:投影数据预处理(暗场/平场校正、射束硬化校正、对数变换)在 CPU 端;投影原始数据常为数百 GB—TB 级,磁盘吞吐影响流水线效率。
- 并行方式:单卡内 CUDA 线程级并行;多卡按体积分块或投影角度分块;跨节点少见,单机多卡为主流。
- 迭代次数敏感:正则化迭代常需数十—数百轮,总耗时 = 迭代数 ×(FP+BP),算法选择与 GPU 数量共同决定交付时间。
典型应用场景
- 工业铸件/焊缝/增材件缺陷检测:1024³—2048³ 常规规模,FBP 为主、迭代法处理高致密金属件伪影。
- 电池极片、复合材料显微 CT:2048³—4096³,少视角或局部重建需迭代法+多 GPU。
- 同步辐射/实验室显微 CT 科研:大体积、多批次,重建参数扫描与算法对比实验。
- 流程:原始投影校正(CPU)→ 几何标定 → 解析重建快速预览 → 迭代重建精修(多 GPU)→ 体渲染与缺陷分割(可 GPU)。
UltraLAB 硬件配置建议
CT 重建选型核心:单卡显存决定“能不能算”,卡数决定“算多快”,CPU 与磁盘决定流水线是否畅通。分档建议(为选型思路,具体以 UltraLAB 官方方案为准):
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 系统盘/项目盘/数据盘 | 散热/电源/扩展性 | 适用场景 |
|---|---|---|---|---|---|---|
| 入门 | 16—24 核高主频处理器 | 128 GB | 1× 24 GB 级 GPU | 1 TB NVMe+4 TB NVMe 数据盘 | 塔式,≥1200 W | ≤1024³ 解析重建与教学科研 |
| 主流 | 24—32 核工作站处理器 | 256—512 GB | 2× 24—48 GB 级 GPU | 2 TB NVMe+8 TB NVMe(RAID 可选) | 水冷,2000 W 级,4 插槽 | 2048³ 迭代重建、多算法对比 |
| 高性能 | 64 核以上平台 | 1 TB ECC | 4× 48 GB 级或 2× 80 GB 级 GPU | 2 TB NVMe+16 TB 高速盘组+NAS/阵列接口 | 机架式冗余电源,万兆上联 | 4096³ 级多 GPU 分块迭代重建与批量检测产线 |
升级方向:先保证单卡显存容纳常用体规模(或采用 TIGRE 分块方案降低门槛),再按迭代重建占比增加 GPU;预处理与归档环节同步扩展内存与磁盘。
提示:ASTRA 与 TIGRE 均为开源工具(Python/MATLAB 接口),无专业卡认证要求;商用 CT 随机软件(VGStudio、Avizo 等)对显卡的要求需按厂商清单核实。TIGRE 的 MATLAB 版本与 Python 版本在依赖上略有差异。软件清单
| 类别 | 软件 | 必需/可选 | 说明 |
|---|---|---|---|
| 重建核心 | ASTRA Toolbox(含 kernelkit 投影器) | 必需 | GPU FP/BP 与 FBP/SIRT/CGLS |
| 重建核心 | TIGRE(Tomographic Iterative GPU-based Reconstruction) | 必需 | 多 GPU 大体积迭代与正则化算法 |
| 运行环境 | CUDA、Python(或 MATLAB) | 必需 | 工具链运行基础 |
| 预处理 | NumPy、SciPy、scikit-image、OpenCV | 必需 | 平场/暗场校正与滤波 |
| 数据接口 | DXchange、TomoPy(数据 IO 部分)、tifffile、h5py | 可选 | 投影数据读写 |
| 可视化 | ParaView、ITK-SNAP、Dragonfly(商用) | 可选 | 体渲染与缺陷分析 |
常见问题(FAQ)
Q1:2048³ 的体积迭代重建要多大显存?
单精度体数据约 34 GB,加上正弦图与工作区,单卡需 48 GB 级显存;使用 TIGRE 的多 GPU 分块,2×24 GB 或 4×16 GB 也可完成,但通信开销上升。
Q2:FBP 已经很快了,为什么还要迭代法?
金属伪影、少视角、低剂量、局部 ROI 重建等场景解析法误差大;迭代法可嵌入正则化与物理模型,精度优势明显,代价是数十倍计算量——这正是多 GPU 的价值所在。
Q3:CPU 重建是否可行?
小体积可行,但 FP/BP 在 GPU 上有数量级加速;2048³ 以上的迭代重建在纯 CPU 上通常需要数天,工程上不可接受。
Q4:多 GPU 如何分工?
ASTRA 支持按角度或体块分配多卡;TIGRE 自动做体积分块与流水线调度。单机 4 卡以内扩展效率较好。
Q5:重建工作站还需要强 CPU 吗?
需要。投影校正、几何标定、数据格式转换均为 CPU 负载,且往往是检测流水线的实际瓶颈;建议 24 核以上并配足内存。
总结与选型建议
工业 CT 迭代重建的选型公式:目标体素规模 → 估算体数据与正弦图显存 → 确定单卡容量与卡数 → 按迭代法使用频率决定 GPU 档次 → CPU/内存/磁盘按“预处理不拖后腿”原则配置。常规 1024³—2048³ 检测任务建议 UltraLAB 主流档双卡配置;4096³ 级科研或批量产线任务上高性能档,并优先利用 TIGRE 的多 GPU 分块能力降低对单卡显存的依赖。
参考来源
- Biguri A., Dosanjh M., Hancock S., Soleimani M. Arbitrarily large iterative tomographic reconstruction on multiple GPUs using the TIGRE toolbox. arXiv:1905.03748。https://arxiv.org/abs/1905.03748
- ASTRA kernelkit: GPU-accelerated projectors for computed tomography(CWI 技术报告)。https://ir.cwi.nl/pub/34711/34711.pdf
- ASTRA Toolbox 官方网站。https://astra-toolbox.com/
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



