






摘要:YOLO(You Only Look Once)系列是工业检测、机器人视觉、视频分析中应用最广泛的单阶段目标检测框架。本文梳理 YOLOv8/YOLO11 的模型分级(n/s/m/l/x)、训练与推理的显存差异、数据增强对 CPU 与存储的要求,推导从单摄像头实时推理到多模型训练工作站的分档配置。
适用读者:从事工业缺陷检测、智慧安防、机器人视觉、遥感目标识别的算法工程师;需要搭建本地训练环境的实验室与中小企业技术负责人。
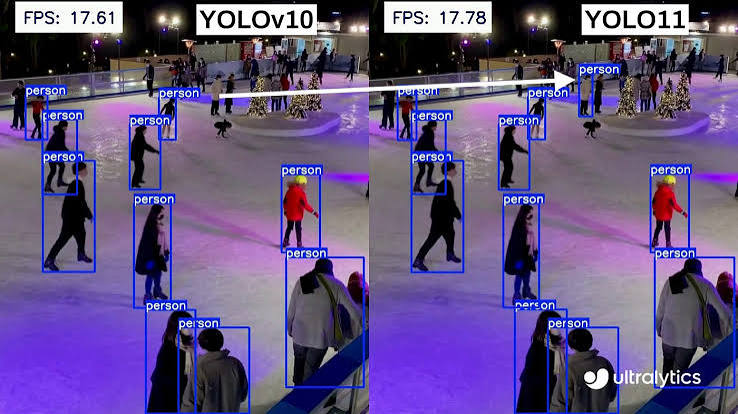
资料背景与核心观点
本文参考以下公开资料:
-
Ultralytics 官方文档(docs.ultralytics.com)。Ultralytics YOLO(含 YOLOv8、YOLO11)提供 detect/segment/classify/pose/obb 多任务模型,每个任务按 n(nano)、s(small)、m(medium)、l(large)、x(xlarge)分级,参数量与计算量逐级递增;训练通过统一 CLI/Python API(
model.train(data=..., imgsz=..., batch=..., epochs=...))完成,内置 Mosaic、MixUp、HSV 等数据增强。 - 《YOLOv8 to YOLO11: A Comprehensive Architecture In-depth Comparative Review》(2025 年综述)。系统拆解了 YOLOv8 到 YOLO11 的骨干、颈部与检测头演进(C2f 模块、C3k2、无锚框解耦头等),指出 YOLO 已成为机器人、自动驾驶、视频监控中事实上的实时检测基线。
- GigaGPU 的 YOLOv8 显存实测汇总(2026 年)。给出工程经验值:单摄像头实时推理任何入门独显即可(YOLOv8n 在 RTX 3050 上 640×640 可达 400+ FPS);训练显存需求约为推理的 3—5 倍;训练 XLarge 模型建议 24GB 以上显存。
核心观点:
- YOLO 是"GPU 效率极高"的负载:推理门槛低,训练才是硬件选型的分水岭。
- 显存需求随模型规模与输入分辨率双重增长:imgsz 从 640 提到 1280,激活值近似按平方增长;训练显存还要叠加梯度与优化器状态。
- 数据加载是真正的隐性瓶颈: mosaic 增强、图像解码与随机变换由 CPU + DataLoader 承担,机械硬盘和弱 CPU 会让高端 GPU 空转。
主要功能模块与核心算法
网络结构
- 骨干网络(Backbone):CSPDarknet 衍生结构 + C2f 模块,提取多尺度特征;卷积+SiLU 激活为主,计算密集、高度规则,充分吃满 GPU Tensor Core。
- 颈部(Neck):PAN-FPN 多尺度特征融合,上采样与拼接操作带来较高的显存带宽压力。
- 检测头(Head):无锚框(anchor-free)解耦头,分别回归框坐标与类别;YOLO11 进一步用 C3k2 等模块压缩参数量。
训练流程
前向传播(FP16/AMP 混合精度)→ 损失计算(CIoU/DIoU + BCE/DFL)→ 反向传播 → SGD/AdamW 更新。数据增强在 CPU 侧完成:Mosaic(四图拼接)、Copy-Paste、随机透视、HSV 变换。
推理与导出
推理经 NMS(非极大值抑制)后输出框;可导出 ONNX、TensorRT、OpenVINO、CoreML 等格式部署。TensorRT FP16/INT8 量化是边缘与服务器端提速的主要手段。
计算特点与性能瓶颈
计算/内存密集特征
- 训练为 GPU 计算密集负载,AMP 混合精度下 Tensor Core 利用充分;显存占用 = 模型权重 + 激活值(随 imgsz² 与 batch 线性增长)+ 梯度 + 优化器状态(AdamW 约为权重的 2 倍)。
- 工程经验值:推理显存 1—6GB 可覆盖 n→x 全系列;训练显存约为推理的 3—5 倍,x 级模型 + 大 batch + 高分辨率轻松突破 16GB。
串并行特征
- 单 GPU 训练为常规路径;多 GPU 走 PyTorch DDP,2—4 卡扩展效率较好。
- CPU 侧 DataLoader 进程(workers 参数)并行完成图像解码与增强,8—16 线程是甜点区间;过多 worker 反而争抢内存。
I/O 与多任务特点
- 数据集通常为数十万张小图(JPEG),随机读取压力大;NVMe SSD 相对 HDD 可显著缩短每个 epoch 的加载等待。
- 训练+验证+TensorBoard 监控+数据预处理多任务并发,系统内存 32GB 起步更稳。
瓶颈排序
训练:GPU 显存/算力 > 数据加载(CPU+SSD)> 内存。推理:GPU 算力(延迟)> 视频解码(CPU/NVDEC)。
典型应用场景
- 工业质检:缺陷检测数据集(数千至数万张),s/m 级模型 + imgsz 640—1280 微调,单卡训练数小时级。
- 视频多路分析:4—8 路 1080P 实时检测,推理为主,中等 GPU + 高效视频解码。
- 遥感/无人机目标检测:大幅面影像切片(数千张小图),数据量大,训练周期以天计,重视吞吐与存储。
- 算法预研:COCO 级公开数据集全量训练 baseline(l/x 模型、300+ epoch),24GB 级显存与长时间满载稳定性是刚需。
UltraLAB 硬件配置建议
分档配置表
| 项目 | 入门配置(推理+小模型微调) | 主流配置(单卡训练主力) | 高性能配置(多卡训练/全量预研) |
|---|---|---|---|
| CPU 选型思路 | 8 核以上桌面级(i7/锐龙 7),主频优先,保障 DataLoader | 12—16 核桌面级/入门工作站 CPU | 24—32 核工作站 CPU(至强 W / Threadripper PRO),提供多卡 PCIe 通道与 16+ DataLoader 线程 |
| 内存 | 32GB | 64GB | 128GB ECC(多卡训练+大数据集缓存) |
| GPU 与显存 | 1× NVIDIA RTX 4060 / RTX 3060 12GB(推理+n/s 模型微调) | 1× NVIDIA RTX 3090/4090 24GB 级(训练主力,x 模型+AMP 余量充足) | 2—4× RTX 4090 24GB 或 RTX A6000 48GB 专业卡;7×24 满载建议专业卡 |
| 系统盘 | 512GB—1TB NVMe SSD | 1TB NVMe SSD | 1—2TB NVMe SSD |
| 项目盘 | 1—2TB NVMe SSD(数据集+权重) | 2TB NVMe SSD | 4TB NVMe SSD 高速项目空间 |
| 数据盘 | 4TB HDD | 8TB HDD | 16TB+ HDD/RAID 或 NAS 归档 |
| 散热/电源/扩展 | 风冷,650—750W | 风冷/水冷,1000W,预留双卡位 | 工作站风道/水冷,1600W,多 PCIe x16 插槽,长时间满载稳定设计 |
| 适用场景 | 算法验证、边缘部署前测试、单路实时推理 | 工业项目主流训练、多路视频推理 | COCO 级全量训练、多模型并行迭代、训练+推理混合机位 |
推荐理由与升级方向
- 训练机先保显存:24GB 是当前单卡训练的舒适线,覆盖 l/x 模型与较大 batch;12GB 卡训练大模型需降 batch/分辨率,延长迭代周期。
- CPU 与存储是被低估的短板:DataLoader 线程不足或数据集放在 HDD 上,会让 GPU 利用率掉到 50% 以下。16 核 CPU + NVMe 数据集盘是训练机的"隐形标配"。
- 升级路径:入门→主流的升级重点是 GPU;主流→高性能的重点是多卡 PCIe 拓扑与电源散热,采购时应一次性确认主板插槽与供电冗余。
软件清单
| 类别 | 软件 | 作用 | 必需性 |
|---|---|---|---|
| 训练框架 | Ultralytics YOLO(pip 包,基于 PyTorch) | 训练/验证/推理/导出一体 | 必需 |
| 运行环境 | Python 3.9+、PyTorch + CUDA 12.x、NVIDIA 驱动 | 运行时 | 必需 |
| 数据标注 | LabelImg / CVAT / Roboflow | 标注与格式转换(YOLO txt) | 必需(数据集生产) |
| 可视化 | TensorBoard / Ultralytics 内置 plots | 训练曲线与混淆矩阵 | 推荐 |
| 部署加速 | ONNX Runtime、TensorRT | 推理加速与边缘部署 | 可选 |
| 实验管理 | ClearML / W&B / Comet(Ultralytics 集成) | 超参与实验追踪 | 可选 |
| 编程工具 | VS Code / PyCharm、Git、Docker | 开发环境 | 推荐 |
常见问题(FAQ)
Q1:推理服务器需要训练级 GPU 吗?
不需要。YOLO 推理极高效,RTX 4060 级即可多路 1080P 实时;预算紧张时"训练用 24GB 大卡、推理用入门卡"分开配置更经济。
Q2:batch size 越大越好吗?
在显存允许范围内增大 batch 通常提高 GPU 利用率与吞吐,但需同步调整学习率;Ultralytics 默认 batch=16 配合自动学习率缩放已较稳健。显存不够时优先降 batch 而非降 imgsz(分辨率对检测精度影响更直接)。
Q3:训练时 GPU 利用率只有一半,瓶颈在哪?
最常见原因是数据加载:检查 workers 数量、数据集是否在 NVMe SSD 上、图像解码是否成为热点。其次才是模型过小(n 级模型在大卡上喂不满)。
Q4:多卡训练比单卡快多少?
DDP 下 2 卡通常可达 1.7—1.9 倍吞吐,4 卡约 3—3.5 倍,受数据加载与通信开销影响;单卡能放下的模型没必要为多卡而多卡。
Q5:专业卡与游戏卡怎么选?
7×24 连续满载、多卡密集部署、需要 ECC 显存与长质保的场景建议专业卡(如 RTX A6000/5880 Ada 级);研发迭代型负载游戏卡性价比更高。
总结与选型建议
YOLO 工作站的选型公式:推理看算力、训练看显存、整体看数据管道。推理节点用 8—12GB 入门卡即可;单卡训练主力建议 24GB 显存 + 16 核 CPU + 64GB 内存 + NVMe 数据集盘;多卡训练机则需工作站级平台保障供电、散热与 PCIe 拓扑。采购前建议用自有数据集在候选配置上实测一个 epoch 的吞吐与峰值显存,避免纸面选型失误。
边界与核实事项
- 文中显存数值为公开工程经验值,实际需求随 imgsz、batch、模型版本与 AMP 设置变化,请以实测为准。
- Ultralytics 提供 AGPL-3.0 与企业许可两种模式,商用部署需核实许可条款。
- TensorRT 加速效果与 GPU 架构相关,部署前需在目标硬件上验证。
参考来源
- Ultralytics 官方文档 — https://docs.ultralytics.com/
- 《YOLOv8 to YOLO11: A Comprehensive Architecture In-depth Comparative Review》— https://www.researchgate.net/publication/388354012_YOLOv8_to_YOLO11_A_Comprehensive_Architecture_In-depth_Comparative_Review
- GigaGPU:《YOLOv8 VRAM Requirements (All Model Sizes)》— https://gigagpu.com/yolov8-vram-requirements/
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



