

摘要:OpenROAD 把芯片数字后端从昂贵的商业工具链中解放出来:从综合后的网表一路走到 GDSII。但 EDA 工具的负载画像与 HPC 截然不同——大量分支密集的图算法、对单核主频与缓存极度敏感、动辄上百 GB 内存。本文基于 OpenROAD 官方文档与 Flow 教程,讲清全流程各环节的算力特征,并给出适合高校与初创团队的 UltraLAB 工作站分档配置。
关键词:OpenROAD、EDA、芯片设计、RTL到GDSII、物理实现、布局布线、时序分析、OpenSTA、集成电路、UltraLAB工作站
- 摘要与适用读者
- 资料背景与核心观点
- 主要功能模块与核心算法
- 计算特点与性能瓶颈
- 典型应用场景
- UltraLAB 硬件配置建议
- 软件清单
- 常见问题(FAQ)
- 可执行总结
一、摘要与适用读者
1.1 这篇资料解决了什么问题
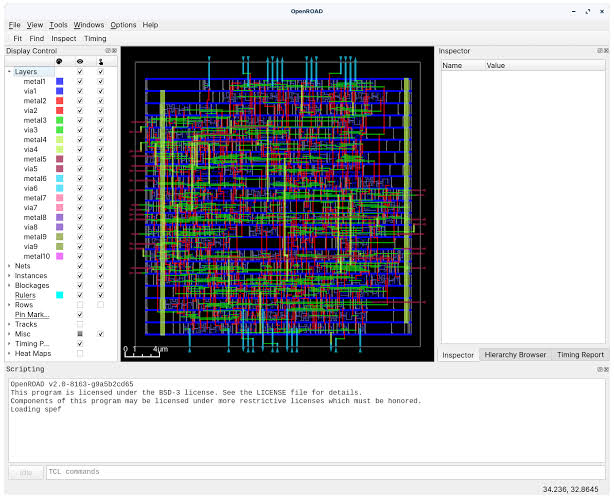
OpenROAD 项目提供了一套开源的数字芯片物理实现工具链,配合 OpenROAD-flow-scripts(ORFS)可以完成从 RTL 综合、Floorplan、布局、时钟树综合、布线到最终时序与物理验证的完整 RTL-to-GDSII 流程。官方文档详细定义了每一步的输入输出与工具模块。
EDA 工作负载与渲染、深度学习完全不同:它由图划分、组合优化与时序传播等分支密集型算法构成,多核并行度有限,极度依赖单核主频、缓存容量与内存带宽。本文据此给出不同于“堆核数”思路的选型建议。
1.2 适用读者
- 高校集成电路方向师生,需要低成本搭建可教学的完整数字后端流程;
- 初创芯片团队,用开源工具做架构探索、PPA 评估与小规模 tape-out 准备;
- 为 EDA 部门采购工作站、需要理解“为什么 EDA 机器要高主频而不是多核”的 IT 与技术负责人。
二、资料背景与核心观点
2.1 资料来源
| 资料 | 类型 | 机构/出处 | 链接 |
|---|---|---|---|
| OpenROAD 官方文档(ReadTheDocs) | 官方文档 | The OpenROAD Project | https://openroad.readthedocs.io/ |
| OpenROAD-flow-scripts Flow Tutorial | 官方教程 | OpenROAD 项目(GitHub) | https://github.com/The-OpenROAD-Project/OpenROAD-flow-scripts/blob/master/docs/tutorials/FlowTutorial.md |
| Open-source semiconductor chip design tool celebrates success | 科研机构报道 | UC San Diego | https://today.ucsd.edu/story/open-source-semiconductor-chip-design-tool-celebrates-success |
2.2 核心观点
- OpenROAD 的目标是提供自主可控、无许可证限制的开源 RTL-to-GDSII 工具链,UCSD 的报道确认其已在研究与教学流片中得到广泛应用;
- 官方流程的主要环节包括:综合(Yosys)→ Floorplanning → Global Placement(RePlAce 思想)→ Detailed Placement → Clock Tree Synthesis → Global/Detailed Routing → Parasitic Extraction → Final Timing Verification(OpenSTA);
- 各环节算法以图与组合优化为主,多线程加速有限,官方文档对不同模块的并行能力说明不一,部署时应按“高主频优先、核数适度、内存充足”的原则配置;
- ORFS 用 Makefile 串联全流程并支持多设计、多 PDK 批量跑图——批量 PPA 探索时“多实例并发”比“单实例多线程”更能吃满硬件。
三、主要功能模块与核心算法
3.1 Floorplanning 与 Global Placement
Floorplan 阶段确定芯片面积、宏单元摆放与电源网络;Global Placement 用解析式方法(RePlAce 系列的静电密度模型 + Nesterov 优化)把数十万到上千万标准单元摊开,是内存消耗大户之一,目标函数求值以大规模稀疏矩阵与线长计算为核心。
3.2 Detailed Placement 与 CTS
详细布局在合法位置上做局部交换与优化,属于典型的组合优化;时钟树综合(TritonCTS)构建低偏斜时钟网络,涉及大量图遍历与几何计算。两者都以单核性能为主导,缓存命中率对速度影响显著。
3.3 Global/Detailed Routing
全局布线在粗粒度网格上规划走线资源,详细布线(TritonRoute 系列的 drt)在轨道级完成连接并处理设计规则。详细布线是流程中最耗时的环节之一,大数据结构 + 不规则内存访问,对内存容量与延迟都敏感。
3.4 寄生提取与时序签核
OpenRCX 提取互连寄生 RC,OpenSTA 做静态时序分析与最终签核。多 corner 多 mode(MMMC)场景下,时序分析按视角并行实例化,是“多实例并发吃满多核”的典型环节——核数在这里终于能用满。
四、计算特点与性能瓶颈
4.1 计算负载画像
EDA 后端是“高主频 + 大缓存 + 大内存”的负载:单线程性能决定单环节耗时,内存容量决定能否吃下大规模设计,缓存大小影响图算法的实际吞吐。GPU 在主线 OpenROAD 流程中几乎无用武之地。MMMC 分析与多设计批量跑图是少数能线性扩展多核的场景,此时核数与内存容量需要同步放大。
4.2 硬件瓶颈分析
| 环节 | 主要瓶颈 | 配置含义 |
|---|---|---|
| 综合与 Floorplan | 单核主频 | 高主频 CPU 直接缩短迭代周期 |
| Global Placement | 内存容量、单核性能 | 大规模设计内存可超 64GB,主频决定优化迭代速度 |
| Detailed Routing | 内存容量与延迟 | 百万级以上设计建议 128GB 起步 |
| MMMC 时序分析 | 核数 × 内存(并发视角) | 按视角数配置核数与内存 |
| 多设计批量 flow | 核数、NVMe I/O | 多实例并发跑图,吞吐优先 |
五、典型应用场景
- 教学实验:SkyWater 130nm / ASAP7 等开放 PDK 上跑通完整流程,单人单设计;
- 架构探索:同一 RTL 在不同约束、不同 PDK 下批量评估 PPA,多实例并发;
- 小规模流片准备:研究级 SoC/加速器设计的后端实现与签核前验证;
- EDA 算法研究:以 OpenROAD 为基座开发新的布局、布线、时序算法。
六、UltraLAB 硬件配置建议
6.1 分档配置与公开参考价
以下配置与价格依据《UltraLAB图形工作站基准配置表2026v3》(2026年9月),为公开基准报价,实际以厂商确认为准。
| 档位 | 机型 | CPU / 内存 | GPU | 存储 | 公开参考价 | 适配场景 |
|---|---|---|---|---|---|---|
| 教学入门型 | A350 14832-MBX | Intel Ultra-245K 14核4.8GHz / 32GB DDR5 | RTX 5060 8GB | 2TB NVMe + 8TB SATA | ¥25,500 | 开放 PDK 教学流程、小模块设计 |
| 高频主流型 | AR350 148192-MCT | AMD 锐龙 9950X3D 16核5.7GHz / 192GB DDR5 | RTX 4090 48GB(水冷) | 4TB NVMe + 8TB SATA | ¥99,990 | 中大规模设计全流程,3D V-Cache 大缓存利好图算法 |
| 多并发旗舰型 | GR450P 148192-MCC | AMD 撕裂者 7980X 64核5.0GHz / 192GB DDR5 | RTX 4000 Ada 20GB | 4TB NVMe + 8TB SATA | ¥145,000 | 多设计批量 flow、MMMC 大规模签核、团队共享 |
6.2 选型说明与边界
- OpenROAD 官方未发布强制硬件清单;上表按 EDA 负载的通用规律条件化配置:单流程环节优先高主频与大缓存,批量与 MMMC 场景再堆核数与内存;
- 9950X3D 的大容量 3D V-Cache 对布局布线类缓存敏感型算法是差异化优势,但具体收益因设计与版本而异,建议实测;
- GPU 在 OpenROAD 主线流程中不参与计算,配置中的显卡仅用于显示与通用图形,不应期待 GPU 加速布线;
- 若后续接入商业工具( Innovus/PrimeTime 等),还需按厂商推荐另行核对许可证与平台认证。
七、软件清单
| 软件 | 角色 | 许可 | 获取方式 |
|---|---|---|---|
| OpenROAD | 物理实现核心工具 | 开源(BSD-3-Clause) | https://github.com/The-OpenROAD-Project/OpenROAD |
| OpenROAD-flow-scripts(ORFS) | 全流程脚本框架 | 开源 | https://github.com/The-OpenROAD-Project/OpenROAD-flow-scripts |
| Yosys | 逻辑综合 | 开源(ISC) | https://github.com/YosysHQ/yosys |
| OpenSTA | 静态时序分析 | 开源 | https://github.com/The-OpenROAD-Project/OpenSTA |
| KLayout | 版图查看与验证 | 开源(GPL) | https://www.klayout.de |
| Magic / Netgen | DRC 与 LVS | 开源 | http://opencircuitdesign.com/magic/ |
八、常见问题(FAQ)
8.1 跑 OpenROAD 需要多少内存?
取决于设计规模与 PDK。教学级设计 32GB 可跑通;百万门级设计在全局布局与详细布线阶段内存可超过 64GB,建议 128GB 起步;多实例并发跑图按“单实例峰值 × 并发数”估算,192GB 是团队级稳妥配置。
8.2 为什么 EDA 工作站强调高主频而不是多核?
布局、布线、时序传播等核心算法多线程并行度有限,单环节耗时主要由单核性能决定;高主频(5GHz 级)能直接缩短每次迭代。多核的价值体现在 MMMC 多视角分析与多设计批量并发。
8.3 OpenROAD 支持 GPU 加速吗?
主线流程为 CPU 计算,官方文档未承诺 GPU 加速;学界有 GPU 加速布局布线的研究项目,但不属于 OpenROAD 默认路径。选型时 GPU 按显示需求配置即可。
8.4 开源流程能用于真实流片吗?
可以,且已有基于开放 PDK 的成功流片案例;但先进节点 PDK 的获取与商业签核工具仍有其必要性。开源流程适合教学、架构探索与成熟节点的研究型流片,量产项目建议与代工厂要求对齐。
九、可执行总结
- 先用 ORFS 的 gcd/nangate45 示例跑通全流程,建立基线耗时,再上自有设计;
- 个人教学与小模块选 A350 14832-MBX;主流设计选 9950X3D 的 AR350 148192-MCT;
- 多设计批量与 MMMC 签核选 64 核撕裂者的 GR450P 148192-MCC,内存按并发数放大;
- 把 PDK、工具版本与运行脚本纳入版本管理,保证流片前结果可复现。
附:EDA 环境搭建注意事项
- 优先使用 ORFS 官方 Docker 镜像,避免依赖地狱;
- PDK 与工具的版本组合强烈影响结果,锁定版本再谈 PPA 对比;
- 大设计的临时文件增长很快,NVMe 预留充足空间并定期清理 ORFS 中间产物。
参考资料
- OpenROAD 官方文档:https://openroad.readthedocs.io/
- OpenROAD-flow-scripts Flow Tutorial:https://github.com/The-OpenROAD-Project/OpenROAD-flow-scripts/blob/master/docs/tutorials/FlowTutorial.md
- UC San Diego:Open-source semiconductor chip design tool celebrates success:https://today.ucsd.edu/story/open-source-semiconductor-chip-design-tool-celebrates-success
- UltraLAB图形工作站基准配置表2026v3(用户提供):#
免责声明:本文所引用的论文、文档与厂商资料均来自公开渠道,链接以撰稿时可访问的版本为准;文中 UltraLAB 机型配置与价格依据《UltraLAB图形工作站基准配置表2026v3》(2026年9月),为公开基准报价,实际成交配置、价格、库存与交货周期请以厂商最新确认为准。软件版本、GPU 加速支持范围与许可证条款可能随版本更新发生变化,部署前请核对官方最新文档。