

摘要:nf-core/sarek 是当前应用最广的开源胚系/体细胞变异检测流程之一,用 Nextflow 把 BWA、GATK、DeepVariant 等几十个工具串成可复现的流水线。它不是单一软件,而是“几十到几百个进程的编排系统”——核数、内存与存储 I/O 的配比决定吞吐。本文依据官方文档与流程论文,给出本地部署的分档硬件方案。
关键词:nf-core、sarek、变异检测、GATK、Nextflow、BWA-mem2、DeepVariant、全基因组、生信分析、UltraLAB工作站
- 一、摘要与适用读者
- 二、资料背景与核心观点
- 三、主要功能模块与核心算法
- 四、计算特点与性能瓶颈
- 五、典型应用场景
- 六、UltraLAB 硬件配置建议
- 七、软件清单
- 八、常见问题(FAQ)
- 九、可执行总结
一、摘要与适用读者
1.1 这篇资料解决了什么问题
nf-core/sarek 官方文档定义了一条从 FASTQ 到注释 VCF 的完整路径:质控与接头修剪、BWA-mem/BWA-mem2/DragMap 比对、GATK MarkDuplicates 与 BQSR 预处理、多种变异检测器(HaplotypeCaller、Mutect2、Strelka2、DeepVariant、Manta 等)、snpEff/VEP 注释与 MultiQC 汇总,全部用容器封装保证可复现。
对实验室而言,关键问题是本地部署的资源画像:流程以样本与区间为维度高度并行,单任务内存从几 GB 到几十 GB 不等,存储既要吞吐又要容量。本文据此给出按样本通量分档的配置。
1.2 适用读者
- 肿瘤基因组、遗传病研究与队列项目中的生信工程师与 PI;
- 医院与第三方检验所,需要在院内本地化部署变异检测流程的团队;
- 为测序平台配套计算资源的实验室管理员。
二、资料背景与核心观点
2.1 资料来源
| 资料 | 类型 | 机构/出处 | 链接 |
|---|---|---|---|
| nf-core/sarek 官方文档(用法与输出) | 官方文档 | nf-core 社区 | https://nf-co.re/sarek/ |
| sarek docs/usage.md(GitHub) | 官方文档 | nf-core/sarek 仓库 | https://github.com/nf-core/sarek/blob/master/docs/usage.md |
| nf-core/sarek paper(社区博客) | 社区技术文章 | nf-core | https://nf-co.re/blog/2024/sarek_paper |
2.2 核心观点
- sarek 面向全基因组(WGS)、全外显子(WES)与靶向测序,支持单样本、肿瘤-正常配对与多复发样本,设计上物种无关(有参考基因组即可);
- 流程用 Nextflow DSL2 实现、每进程一个容器,可按样本与基因组区间自动并行拆分——资源需求呈“多任务并发”形态,而不是单一大任务;
- 官方文档支持 GPU 加速选项:Parabricks 比对与变异检测可作为实验特性接入(--aligner parabricks),但不支持 conda 环境,需 NVIDIA GPU 与相应许可;
- 2024 年流程论文对应的更新强调降本:BwaMem2/DragMap 更快比对、CRAM 替代 BAM 使工作目录存储显著下降,这直接改变本地存储规划。
三、主要功能模块与核心算法
3.1 比对与预处理
短序列比对用 BWA-mem/BWA-mem2/DragMap 将 reads 定位到参考基因组,随后 GATK MarkDuplicates 标记 PCR 重复、BaseRecalibrator + ApplyBQSR 做碱基质量校正。比对是 CPU 多线程友好型任务,单样本可吃 8–16 线程;MarkDuplicates 的排序与去重则是内存与磁盘 I/O 密集型。
3.2 变异检测
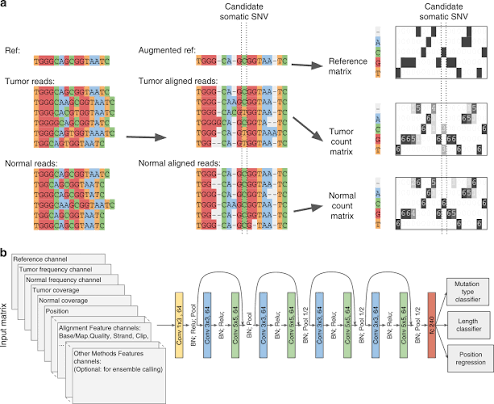
胚系检测以 GATK HaplotypeCaller 的局部单倍型组装为核心;体细胞检测用 Mutect2(肿瘤-正常配对或 panel-of-normals)、Strelka2 等;DeepVariant 用深度学习从 pileup 图像判型。流程按染色体区间切分并行,最后合并——区间划分让万核级并发成为可能,也让单机多核的利用率很高。
3.3 结构变异、CNV 与注释
Manta/TIDDIT 检结构变异,ASCAT/Control-FREEC/CNVkit 做拷贝数分析,MSIsensor-pro 评估微卫星不稳定;snpEff 与 Ensembl VEP 完成基因层面注释,MultiQC 汇总全流程质控。这些环节多为单线程或轻多线程,靠流程层并发吃满核数。
3.4 Nextflow 调度与断点续跑
Nextflow 按资源声明(cpus/memory)把任务装箱到可用核数上,失败可从断点 -resume。本地部署时 executor 用 local,资源上限通过配置文件与机型匹配——这决定了“声明的资源画像”要和真实硬件对齐,否则要么排队要么超卖。
四、计算特点与性能瓶颈
4.1 计算负载画像
生信流程是典型的“高并发、混合型”负载:比对吃多线程与内存,去重/排序吃磁盘 I/O,变异检测吃单核性能与区间并发,全程伴随海量小文件读写。单样本 WGS(30×)从 FASTQ 到 VCF 在 32–96 核机器上通常以小时计;通量瓶颈随样本量增长从 CPU 转向存储。GPU 仅在接入 Parabricks 时有价值。
4.2 硬件瓶颈分析
| 环节 | 主要瓶颈 | 配置含义 |
|---|---|---|
| BWA-mem2 比对 | CPU 线程数、内存 | 单样本 8–16 线程,参考基因组索引常驻内存 |
| MarkDuplicates/BQSR | 磁盘 I/O、内存 | NVMe 工作目录是刚需 |
| HaplotypeCaller/Mutect2 | 单核性能 × 区间并发 | 核数决定并发区间数,高主频缩短单区间耗时 |
| 多样本批量 | 核数、内存、存储并发 | 按“样本数 × 单样本资源”规划总资源 |
| 中间文件管理 | 存储容量与吞吐 | CRAM 输出 + NVMe scratch + 大容量归档 |
五、典型应用场景
- 肿瘤-正常配对 WES/WGS:体细胞突变、CNV、MSI 一体化检测;
- 遗传病家系分析:胚系 joint calling 与注释;
- 队列项目:数十到数百样本批量流程化产出;
- 院内本地化:数据不出院的合规分析与报告生成。
六、UltraLAB 硬件配置建议
6.1 分档配置与公开参考价
以下配置与价格依据《UltraLAB图形工作站基准配置表2026v3》(2026年9月),为公开基准报价,实际以厂商确认为准。
| 档位 | 机型 | CPU / 内存 | GPU | 存储 | 公开参考价 | 适配场景 |
|---|---|---|---|---|---|---|
| 小通量入门型 | AE430 131128-MBX | AMD 霄龙 7573X 32核 / 128GB DDR4 | RTX 5060Ti 16GB | 2TB NVMe + 8TB SATA | ¥59,990 | 每周数个 WES/WGS 样本,研究与教学 |
| 中通量主流型 | AE450 135128-MCX | AMD 霄龙 9654 96核 / 128GB DDR5 | RTX 5070Ti 16GB | 4TB NVMe + 8TB SATA | ¥99,990 | 多样本并行、WGS 日常分析 |
| 高通量旗舰型 | AE450 135256-MCX | AMD 霄龙 9755 128核 / 256GB DDR5 | RTX 5080 16GB | 4TB NVMe + 8TB SATA | ¥165,000 | 队列级批量、多人并发、7×24 连续运行 |
6.2 选型说明与边界
- nf-core 官方给出的是每进程资源声明而非整机清单;上表按“单样本资源 × 并发样本数”的常见经验条件化配置,实际请在目标机型上用 -profile test 与真实样本标定;
- Parabricks GPU 加速为实验特性且有独立许可与硬件要求,是否需要请在采购前与软件许可方确认;未启用 GPU 路径时,显卡仅服务显示;
- 存储建议分层:NVMe 作为 Nextflow work 目录,SATA 大容量盘存放参考基因组、结果与归档;
- 测序仪数据落地速率决定日吞吐上限,批量项目请按“日样本数 × 单样本机时”反推核数。
七、软件清单
| 软件 | 角色 | 许可 | 获取方式 |
|---|---|---|---|
| Nextflow | 流程编排引擎 | 开源(Apache-2.0) | https://www.nextflow.io |
| nf-core/sarek | 变异检测流程 | 开源(MIT) | https://nf-co.re/sarek |
| Docker / Singularity(Apptainer) | 容器运行时 | 开源 | https://www.docker.com |
| BWA-mem2 / DragMap | 序列比对(随流程容器) | 开源 | 随 sarek 容器分发 |
| GATK4 / DeepVariant / Manta 等 | 变异检测(随流程容器) | 开源/学术许可 | 随 sarek 容器分发 |
| igv.js / IGV | 结果人工审阅 | 开源 | https://igv.org |
八、常见问题(FAQ)
8.1 跑 sarek 必须要 GPU 吗?
不是。默认路径(BWA + GATK + 各类 caller)全部跑在 CPU 上;GPU 仅在启用 Parabricks 实验特性时有用,且官方文档注明它不支持 conda 环境、需另行满足许可要求。预算优先给 CPU、内存与 NVMe。
8.2 32 核和 96 核的实际差别有多大?
单样本分析中,比对阶段 32 核已接近饱和;差别体现在多样本并发与区间级并行上:96 核可同时跑更多样本与区间,队列项目的日吞吐近似按核数比例提升。
8.3 存储要怎么规划?
三个层次:参考基因组与数据库(只读、数百 GB)、Nextflow work 目录(高速 NVMe、随项目滚动增长)、最终结果与归档(大容量 SATA)。2024 版流程默认 CRAM 输出,官方博客指出可显著节省工作空间,但 scratch 盘仍需预留数倍于原始数据的余量。
8.4 断点续跑和版本固定怎么做?
Nextflow 原生支持 -resume 断点续跑;生产环境务必用 -r 固定流程版本并锁定容器标签,同一项目的全部样本用同一版本跑出可对比结果。
九、可执行总结
- 先用 -profile test,docker 跑通官方测试数据,再用 1–2 个真实样本标定本机吞吐;
- 小通量选 32 核的 AE430 131128-MBX;常规 WGS 选 96 核的 AE450 135128-MCX;
- 队列级项目选 128 核 256GB 的 AE450 135256-MCX,并把 NVMe work 盘配到 4TB;
- 生产流程锁定版本与容器,建立样本质控准入与报告复核 SOP。
附:生信平台运维注意事项
- 容器镜像首次拉取量大,建议预置本地镜像仓库;
- Nextflow work 目录要定期清理策略化,否则 NVMe 会被中间文件占满;
- 医疗场景注意数据合规:分析机与外网隔离、访问审计与备份策略先行。
参考资料
- nf-core/sarek 官方文档:https://nf-co.re/sarek/
- nf-core/sarek 用法文档(GitHub):https://github.com/nf-core/sarek/blob/master/docs/usage.md
- nf-core/sarek 论文发布博客:https://nf-co.re/blog/2024/sarek_paper
- UltraLAB图形工作站基准配置表2026v3(用户提供):#
免责声明:本文所引用的论文、文档与厂商资料均来自公开渠道,链接以撰稿时可访问的版本为准;文中 UltraLAB 机型配置与价格依据《UltraLAB图形工作站基准配置表2026v3》(2026年9月),为公开基准报价,实际成交配置、价格、库存与交货周期请以厂商最新确认为准。软件版本、GPU 加速支持范围与许可证条款可能随版本更新发生变化,部署前请核对官方最新文档。