






摘要:GDEM(Geotechnical Discrete Element Method)是由北京极道成然科技有限公司与中国科学院力学研究所联合研发的连续-非连续单元方法(CDEM)力学分析系统。本文系统梳理其算法内核、软件版本矩阵、典型应用场景,并结合 UltraLAB 2026 全系工作站产品,提供从入门教学到千万级自由度超大规模计算的硬件配置方案,同时涵盖 AI 大模型本地部署的融合算力规划。
一、GDEM 核心算法特点
图1:CDEM 方法有限元-离散元耦合计算架构1.1 连续-非连续单元方法(CDEM)
GDEM 以 CDEM(Continuum-Discontinuum Element Method) 为理论基石,实现了有限元(FEM)与离散元(DEM)的深度耦合:
| 计算域 | 方法 | 物理意义 | 优势 |
|---|---|---|---|
| 块体内部 | 有限元(FEM) | 连续介质变形 | 精确描述应力-应变关系 |
| 块体边界 | 离散元(DEM) | 接触、滑移、分离 | 自然模拟裂纹萌生、扩展与贯通 |
| 断裂过程 | 显式裂纹模型 | 连续→非连续转化 | 真实再现材料渐进破坏全过程 |
1.2 GPU 异构并行加速
GDEM 采用 CUDA 架构 对核心求解器进行 GPU 并行化重构,相比传统 CPU 串行/多核方案实现:
- 计算速度提升两个数量级
- 计算规模提升一个数量级(支持千万量级自由度)
- 显存容量直接决定可求解模型规模上限
1.3 显式迭代效率指标
基于当前主流 NVIDIA GPU(GeForce GTX 860 及以上),GDEM-DAS 的基准迭代性能如下:
| 单元类型 | 连续系统(秒/万单元·万步) | 全离散系统(秒/万单元·万步) |
|---|---|---|
| 六面体 | < 2.0 | < 8.0 |
| 五面体 | < 2.0 | < 8.0 |
| 四面体 | < 2.0 | < 8.0 |
| 混合单元 | < 3.0 | < 10.0 |
工程换算:百万六面体网格、10 万迭代步的非连续问题,在 RTX 4090 级别 GPU 上约需 20~30 小时;若采用 RTX 5090/Pro 6000 级新一代卡,耗时压缩至 10~15 小时。
二、GDEM-DAS 软件版本清单
GDEM-DAS 采用模块化版本策略,覆盖从基础教学到高端科研的全谱系需求:
| 版本大类 | 子版本 | 核心模型/功能 | 适用对象 |
|---|---|---|---|
| 工程版 | 静力学版·基础版 | 线弹性模型、Drucker-Prager 理想弹塑性模型(内角点外接/外角点外接/等面积)、开挖模型 | 本科教学、常规边坡稳定分析 |
| 静力学版·专业版 | 基础版全部功能 + 破裂模型(裂纹模型、断裂模型) | 科研院所、工程咨询单位 | |
| 动力学版 | 动力学版·基础版 | 静力学基础版功能 + 动力学基础包(动力学载荷、无反射边界条件) | 地震工程、爆破效应初评 |
| 动力学版·专业版 | 静力学专业版功能 + 动力学基础包 | 高端科研、复杂动力破坏全过程模拟 |
2.1 功能扩展模块
- 材料本构库:线弹性、理想弹塑性、应变软化、节理单元
- 边界条件:固定约束、位移加载、应力边界、无反射人工边界(动力学)
- 断裂判据:最大拉应力、莫尔-库仑、能量释放率
- 后处理:应力/位移云图、裂纹网络提取、时程曲线、动画输出
三、典型应用场景
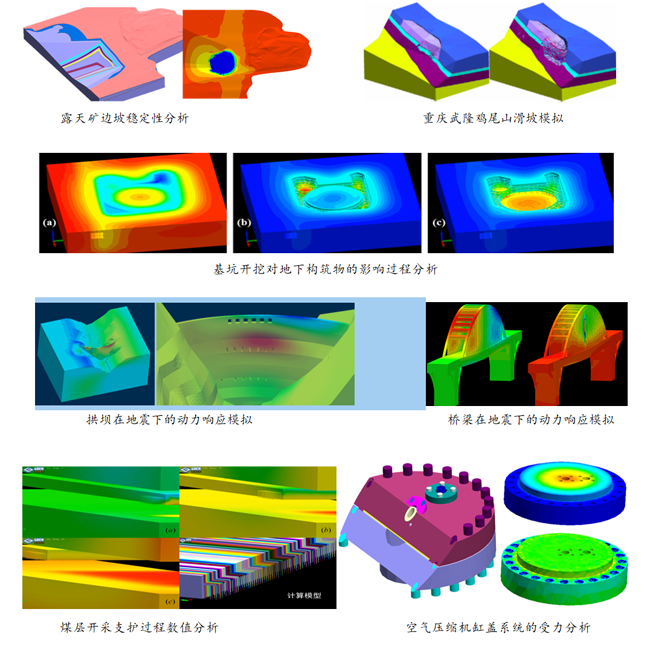
 图2:GDEM-DAS 典型工程应用案例集锦
3.1 岩土与地质工程
| 场景 | 分析目标 | 典型模型规模 |
|---|---|---|
| 高边坡稳定性评价 | 潜在滑面搜索、支护效应评估 | 50~200 万单元 |
| 滑坡灾害链模拟 | 启动-运动-堆积全过程 | 100~500 万单元 |
| 隧道围岩-支护相互作用 | 挤压大变形、衬砌开裂 | 30~100 万单元 |
3.2 采矿与爆破工程
| 场景 | 分析目标 | 关键技术 |
|---|---|---|
| 露天矿台阶爆破 | 爆破裂纹网络、块度预测 | 动力学版 + 无反射边界 |
| 煤层开采覆岩运动 | 导水裂隙带发育、地表沉陷 | 静力学专业版 + 断裂模型 |
| 地下采场矿柱稳定性 | 渐进破坏、能量释放 | 连续→非连续转化 |
3.3 水利与结构工程
| 场景 | 分析目标 | 典型输出 |
|---|---|---|
| 拱坝-地基系统地震响应 | 坝体裂缝、坝肩失稳 | 时程位移、损伤云图 |
| 基坑开挖对邻近构筑物影响 | 支护变形、地表沉降槽 | 三维变形场、沉降曲线 |
| 桥梁结构抗震 | 墩柱塑性铰、支座滑移 | 滞回曲线、残余位移 |
四、UltraLAB 硬件配置推荐(2026)
GDEM 的算力需求呈 "GPU 显存容量决定模型规模上限,GPU CUDA 核心数决定求解速度,内存容量决定前后处理流畅度" 的倒三角结构。结合 UltraLAB 2026 全系产品线,按计算规模分级推荐如下:
4.1 入门级:教学演示与中小规模验证(≤ 30 万单元)
| 组件 | 推荐型号 | UltraLAB 对应机型 |
|---|---|---|
| CPU | Intel Ultra 9 285K(24核,P核 5.6GHz) |
A350153128-MCT 高速图像处理工作站 |
| 内存 | 128 GB DDR5 5600MHz | |
| GPU | NVIDIA RTX 5090D 32GB | |
| 系统盘 | 4TB NVMe Gen4(读 14GB/s) | |
| 显示 | 27" 4K 专业图显 | |
| 参考报价 | ¥61,000 |
适用场景:本科教学、硕士论文常规算例、小型边坡/基坑快速评估。RTX 5090D 32GB 显存可轻松承载 50 万级四面体网格。
4.2 专业级:常规工程与科研主力(30~150 万单元)
| 组件 | 推荐型号 | UltraLAB 对应机型 |
|---|---|---|
| CPU | AMD Ryzen TR PRO 7975WX(32核 5.0GHz) |
GR450P150128-MCX 多用途 GPU 超算工作站 |
| 内存 | 128 GB DDR5 ECC | |
| GPU | NVIDIA RTX 5080 16GB 或 RTX 4000 Ada 20GB | |
| 系统盘 | 4TB NVMe SSD | |
| 显示 | 27" 2K 图显 | |
| 参考报价 | ¥132,000 |
适用场景:设计院常规生产、科研团队主力机。32 核 CPU 保障复杂几何前处理与千万网格渲染流畅度。
4.3 高端级:大规模非连续破坏与多场耦合(150~500 万单元)
| 组件 | 推荐型号 | UltraLAB 对应机型 |
|---|---|---|
| CPU | AMD EPYC 9475F(48核 4.4GHz) |
EA660 230384-MCB 电磁仿真全能高频工作站 |
| 内存 | 256 GB DDR5 ECC | |
| GPU | NVIDIA RTX 5080 16GB ×2(NVLink 桥接) | |
| 系统盘 | 4TB NVMe Gen5 + 8TB NVMe 数据盘 | |
| 显示 | 27" 4K 图显 | |
| 参考报价 | ¥279,990 |
适用场景:大型露天矿全生命周期破坏模拟、高坝抗震安全评价、深部开采动力灾害预测。256GB 内存可完整加载 500 万单元模型的前后处理数据。
4.4 超算级:千万级自由度与多 GPU 并行(≥ 500 万单元)
| 组件 | 推荐型号 | UltraLAB 对应机型 |
|---|---|---|
| CPU | AMD EPYC 9755(128核 4.1GHz,512MB 缓存) |
AlphaPro660 241768-MDA 大型多用途仿真计算平台 |
| 内存 | 768 GB DDR5 ECC | |
| GPU | NVIDIA RTX Pro 6000 96GB 或 A100 80GB ×2 | |
| 存储 | 8TB NVMe(读 14GB/s)+ 20TB SATA 归档 | |
| 显示 | 27" 4K 图显 | |
| 参考报价 | ¥515,000 ~ ¥670,000 |
适用场景:国家级重点实验室、大型工程集团技术中心。96GB 显存可单卡承载千万级四面体网格;双卡配置可通过任务队列实现 7×24h 不间断批量计算。
4.5 集群级:团队共享与云端化部署
| 角色 | 配置要点 | UltraLAB 对应方案 |
|---|---|---|
| 计算节点 | 2×AMD EPYC 9684X(192核 3.5GHz)/ 512GB DDR5 / RTX 5090 32GB / 8TB NVMe | AlphaPro660 234512-MDT |
| 管理/登录节点 | 64核 / 256GB / RTX A1000 / 100G EDR 网络 | 分布式多机集群 8.1 |
| 存储节点 | 128TB 并行存储 / 100G EDR | 分布式多机集群 8.1 |
| 网络 | 100G EDR Infiniband / 双 100G 以太网 | — |
| 参考总价 | ¥1,118,600(5 计算节点 + 1 管理节点 + 存储) | |
五、AI 大模型本地部署融合方案
在现代工程数值分析 workflow 中,GDEM 力学计算 + 本地 AI 大模型 的融合架构正成为提升效率的新范式:
5.1 部署架构
┌─────────────────────────────────────────────────────────────┐
│                    UltraLAB 融合算力平台                     │
├──────────────────────┬──────────────────────────────────────┤
│   GPU-0(主卡)      │   GPU-1(副卡/多卡)                 │
│   RTX Pro 6000 96GB  │   RTX Pro 6000 96GB / A100 80GB      │
│   ├── GDEM 三维渲染  │   ├── GDEM CUDA 求解器               │
│   ├── CIM 可视化     │   ├── DeepSeek-R1 32B/70B 推理       │
│   └── 三联屏输出     │   ├── 岩土规范知识库 RAG             │
│                      │   └── 裂纹识别 AI 推理               │
├──────────────────────┴──────────────────────────────────────┤
│   CPU:128核 EPYC 9755  /  内存:768GB DDR5 ECC             │
│   存储:8TB NVMe + 20TB SATA(模型库+计算结果库)            │
└─────────────────────────────────────────────────────────────┘
5.2 大模型选型与显存占用
| 模型 | 参数量 | INT4 量化显存 | FP16 显存 | 适用场景 |
|---|---|---|---|---|
| DeepSeek-R1-Distill-Qwen | 14B | 8 GB | 28 GB | 岩土报告初稿生成、规范问答 |
| DeepSeek-R1-Distill-Llama | 70B | 40 GB | 140 GB | 复杂工程决策支持、多文档综述 |
| Qwen2.5-72B-Instruct | 72B | 42 GB | 144 GB | 中文规范理解、报告润色 |
| Llama-3.1-70B | 70B | 40 GB | 140 GB | 英文论文辅助、国际规范对照 |
部署建议:在 96GB 显存的 RTX Pro 6000 上,可同时运行 GDEM 中小规模计算(显存占用 < 40GB)与 DeepSeek-R1 70B INT4 量化模型(显存占用 ~40GB),实现 "算完即写、写完即审" 的闭环。
5.3 典型融合 Workflow
- 前处理阶段:大模型辅助生成 Python/MATLAB 网格参数化脚本,自动匹配地质勘察报告中的岩土参数;
- 计算阶段:GDEM GPU 求解器全速运行,大模型进入待机/轻量推理模式;
- 后处理阶段:大模型读取计算结果 JSON,自动生成《边坡稳定性评价报告》初稿,并依据《建筑边坡工程技术规范》进行合规性检查;
- 可视化阶段:GDEM 三维裂纹网络与 CIM 平台联动,大模型实时解答交互式查询。
六、常见问题与硬件配置深度分析
Q1:GDEM 是否支持多 GPU 并行计算?
答:GDEM-DAS 当前版本以 单 GPU 计算 为主流架构。其千万级自由度求解器在单卡显存内完成全部迭代,多 GPU 主要通过 任务级并行(同时提交多个算例)提升团队吞吐。因此,单卡显存容量比卡数更重要。若预算有限,优先选择一张 RTX 5090D 32GB,而非两张 RTX 5080 16GB。
Q2:游戏卡(GeForce)与专业卡(RTX Pro/Quadro)如何选择?
| 对比维度 | GeForce RTX 5090D | RTX Pro 6000 Ada |
|---|---|---|
| 显存容量 | 32 GB | 96 GB |
| 显存带宽 | 1.8 TB/s | 2.0 TB/s |
| ECC 纠错 | 无 | 有 |
| 驱动稳定性 | 游戏优化,偶发 TDR | ISV 认证,7×24h 稳定 |
| 价格 | ¥15,000~20,000 | ¥80,000+ |
| GDEM 适用性 | 性价比首选 | 超大规模/生产环境必选 |
结论:科研教学选 GeForce;企业级生产、千万级网格、长期满载计算选 RTX Pro/A 系列。
Q3:内存 64GB 是否足够?
答:分场景:
- 仅运行 GDEM 求解器:64GB 可支撑 200 万单元模型的计算;
- 前后处理 + 多软件联动:CloudCompare 点云(>10GB)、ContextCapture 三维重建(>20GB)、GDEM 后处理(>30GB)同时开启时,128GB 是安全底线;
- 融合 AI 大模型:本地部署 70B 参数模型需额外 40~60GB 内存缓存,256GB 推荐。
Q4:为什么 NVMe SSD 是必须的?
GDEM 在迭代过程中每时间步输出位移、应力、损伤场数据,百万级网格的单个结果文件可达 2~5GB。若使用机械硬盘:
- 写盘等待时间占总耗时 15~30%;
- NVMe Gen4(7GB/s)可将写盘等待压缩至 < 3%;
- NVMe Gen5(14GB/s)可实现 "算完即存、无感切换"。
Q5:便携工作站能否运行 GDEM?
答:可以,但需满足:
- 单槽/双槽 NVIDIA GPU(功耗 ≤ 300W);
- 涡轮版(Blower)散热,避免便携机箱积热降频;
- 电源 ≥ 850W,留足余量;
- 显存 ≥ 16GB,否则模型规模受限严重。
UltraLAB 便携系列(如 A350 改装方案)可搭载 RTX 5090D 32GB,适合 野外地质调查现场的快速验证计算。
Q6:GDEM 与 ABAQUS/ANSYS 的硬件需求差异?
| 维度 | GDEM | 传统 FEM(ABAQUS/ANSYS) |
|---|---|---|
| 核心加速 | GPU CUDA(必需 N 卡) | CPU 多核(MPI/OpenMP) |
| 显存敏感度 | 极高(显存=模型规模) | 中等(显存影响后处理) |
| 内存需求 | 大(前后处理占主导) | 极大(直接求解器吃内存) |
| 存储带宽 | 高(时步数据频繁写盘) | 中(结果文件相对少) |
| 最优配置 | 高频 CPU + 大显存 GPU + 大内存 | 超多核 CPU + 大内存 + 高速互联 |
七、配置选型速查表
| 用户画像 | 推荐 UltraLAB 机型 | 核心配置 | 预算区间 |
|---|---|---|---|
| 高校教学/个人科研 | A350153128-MCT | U9 285K / 128GB / RTX 5090D 32GB | ¥60,000~70,000 |
| 设计院生产主力 | GR450P150128-MCX | TR PRO 7975WX / 128GB / RTX 5080 | ¥130,000~150,000 |
| 大型工程/高端科研 | EA660 230384-MCB | EPYC 9475F / 256GB / RTX 5080×2 | ¥280,000~320,000 |
| 超大规模/AI 融合 | AlphaPro660 241768-MDA | EPYC 9755 / 768GB / RTX Pro 6000 96GB | ¥500,000~700,000 |
| 团队共享/云端化 | 分布式多机集群 8.1 | 5×计算节点 + 存储节点 / 100G 网络 | ¥1,100,000+ |
关于北京极道成然科技有限公司:专注于地质灾害数值模拟软件研发,以 CDEM 方法为核心,结合 GPU 并行加速技术,为岩土、采矿、水利、结构工程领域提供自主可控的力学分析解决方案。
关于 UltraLAB:国内高端图形工作站与异构计算平台领先品牌,提供从单机超频工作站到分布式 GPU 集群的全谱系算力设备,支持远程测试与定制化配置。
本文档基于 GDEM-DAS 公开技术资料与 UltraLAB 2026v1 基准报价表整理,具体配置请以厂商最新报价为准。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


