






COMSOL Multiphysics 多物理场耦合全解析:模块功能、AI 大模型部署与 UltraLAB 工作站硬件配置推荐
摘要:COMSOL Multiphysics 是全球领先的通用多物理场仿真平台,以"任意物理场自由耦合"著称,覆盖电磁、结构力学、声学、流体、传热、化工六大领域 30 余个专业模块。6.4 版本(2025 年 11 月发布)引入 NVIDIA cuDSS GPU 加速求解器、颗粒流模块(DEM)、显式结构动力学,并原生支持接入 GPT-5、DeepSeek 等大语言模型辅助仿真。本文系统梳理 COMSOL 各模块主要功能与应用场景,分析 AI 大模型(含本地私有化 DeepSeek)与 COMSOL 的协同部署方案,并给出 UltraLAB 图形工作站分档硬件配置推荐与常见硬件问题解答。
关键词:COMSOL Multiphysics、多物理场耦合仿真、AC/DC 模块、RF 模块、CFD 模块、cuDSS GPU 加速、显式动力学、DNN 代理模型、DeepSeek 本地部署、UltraLAB 图形工作站、仿真硬件配置
一、COMSOL Multiphysics 是什么
COMSOL Multiphysics 是基于有限元方法(FEM)的通用仿真平台,核心思想是:任何物理场都可以用偏微分方程描述,任何偏微分方程都可以自由耦合。基础平台包含模型开发器、App 开发器、模型管理器,在此之上按领域叠加专业模块。1
截至 2026 年 8 月,最新版本为 COMSOL Multiphysics 6.4(2025 年 11 月 18 日发布,已更新至 6.4 Update 3),四大里程碑更新:23
- NVIDIA cuDSS GPU 加速求解器——GPU 加速从声学/DNN 扩展到所有单物理场与多物理场仿真,支持单机多 GPU 与 GPU 集群,带来数倍求解提速;
- 颗粒流模块(全新)——基于离散元法(DEM)模拟颗粒与粉末流动;
- 结构显式动力学——支持撞击、爆炸、跌落测试等高速非线性事件分析;
- LLM 智能助手增强——原生接入 GPT-5、DeepSeek、Gemini 及自托管 OpenAI API 兼容服务,可基于官方文档与实时仿真数据提供建模指导。4
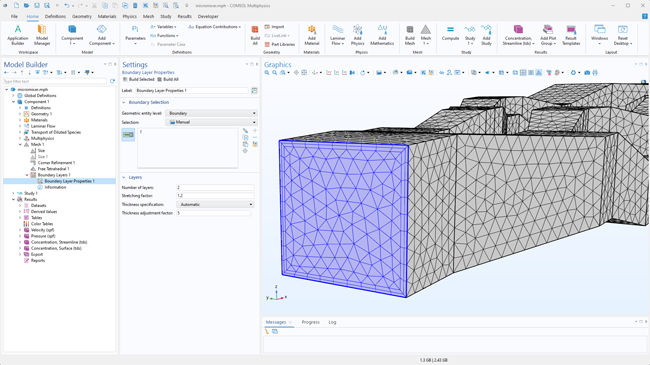
 图 1:COMSOL 6.4 的 GPU 加速已覆盖通用多物理场仿真(示意图,图片路径请替换为实际素材)
二、各模块主要功能与应用场景
2.1 基础平台与部署工具
| 模块 | 主要功能 | 应用场景 | 计算特征 |
|---|---|---|---|
| COMSOL Multiphysics(基础平台) | 模型开发器、App 开发器、模型管理器;智能助手(LLM 建模问答) | 全部仿真工作的入口;仿真 App 开发与数据管理 | 交互建模吃单核主频 |
| COMSOL Server | 仿真 App 网络分发与集中部署 | 企业内向设计/生产部门分发仿真 App | 服务器端并发负载 |
| COMSOL Compiler | 将模型编译为独立可执行 App | 对外交付免许可证仿真工具 | 编译型轻负载 |
2.2 电磁模块群
| 模块 | 主要功能 | 应用场景 | 计算特征 |
|---|---|---|---|
| AC/DC 模块 | 静电、静磁、低频电磁场、电路耦合 | 电机、变压器、感应加热、电磁阀、绝缘设计 | 隐式 FEM:吃主频+内存,cuDSS 可 GPU 加速 |
| RF 模块 | 高频电磁波、传输线、天线 | 天线设计、微波器件、5G/6G 射频前端、EMC | 频域 FEM 内存极敏感;时域显式可 GPU |
| 波动光学模块 | 全波电磁光学仿真 | 光子晶体、光波导、光纤器件、超表面 | 大内存频域 FEM |
| 射线光学模块 | 几何光学射线追踪 | 镜头系统、激光光路、照明设计 | 轻量~中等 |
| 半导体模块 | 半导体器件物理 | 二极管/晶体管/IGBT 器件仿真、忆阻器 | 强非线性隐式求解 |
| 等离子体模块 | 低温等离子体仿真 | 半导体刻蚀/沉积工艺、放电、开关电弧 | 多物理场强耦合,CPU 密集 |
2.3 结构力学与声学模块群
| 模块 | 主要功能 | 应用场景 | 计算特征 |
|---|---|---|---|
| 结构力学模块 | 固体力学、壳/梁/桁架、热应力 | 机械强度校核、热变形分析、压力容器 | 隐式 FEM 主力负载,cuDSS GPU 提速 2 倍+(RTX 5000 Ada 实测)5 |
| 非线性结构材料模块 | 超弹、塑性、蠕变、粘弹性 | 橡胶密封、金属成形、聚合物力学 | 强非线性,CPU 密集 |
| 疲劳模块 | 高低周疲劳、随机振动疲劳 | 结构寿命评估 | 后处理型负载 |
| 多体动力学模块 | 刚体/柔体混合机构运动 | 机械臂、传动机构、关节装配 | 中等 CPU |
| 转子动力学模块 | 旋转机械临界转速与稳定性 | 涡轮机、电机转子、压缩机 | 特征值求解,内存敏感 |
| 复合材料模块 | 层合板/多层壳分析 | 航空复材结构、风电叶片 | 多自由度模型 |
| 声学模块 | 压力声学、热粘性声、气动声、声-结构耦合 | 扬声器/麦克风、消声器、室内声学、NVH | 时域显式声学 GPU 加速标杆:3 亿自由度模型单卡 H100 数小时完成;多 GPU 及集群支持(6.4)67 |
| 岩土力学模块 | 土体、岩石非线性力学 | 边坡稳定、隧道、地基沉降 | 隐式 FEM |
| 金属加工模块 | 轧制、锻造、挤压工艺仿真 | 金属成形制造 | 强非线性 CPU 密集 |
| 显式动力学(6.4 新增) | 高速瞬态非线性事件 | 跌落测试、撞击、爆炸、侵彻 | 显式时间步进,多核并行效率高 |
2.4 流体与传热模块群
| 模块 | 主要功能 | 应用场景 | 计算特征 |
|---|---|---|---|
| CFD 模块 | 层流/湍流(RANS/LES/SAS)、多相流、旋转机械 | 泵阀、风机、搅拌设备、空气动力学 | 内存带宽敏感,大模型吃内存+核数 |
| 传热模块 | 传导/对流/辐射、参与介质辐射 | 电子散热、热管理系统、感应淬火 | 常与电磁/流体耦合 |
| 微流体模块 | 微尺度流、稀薄气体、电动流 | 微流控芯片、喷墨打印、Lab-on-Chip | 中小模型为主 |
| 多孔介质流模块 | 达西流/Brinkman/裂隙流 | 过滤器、催化剂载体、燃料电池 GDL | 中等负载 |
| 地下水流模块 | 孔隙-裂隙渗流与溶质运移 | 地下水污染、地热开采、CO2 封存 | 大区域模型吃内存 |
| 管道流模块 | 管网一维流与三维耦合 | 冷却水系统、液压管路 | 轻量 |
| 分子流模块 | 高真空稀薄气体 | 真空镀膜、质谱仪 | 中等 |
| 聚合物流动模块 | 粘弹性流体 | 注塑、挤出、纺丝 | 强非线性 |
| 搅拌器模块 | 旋转机械流场专用工具 | 反应釜、混合器放大 | 大模型瞬态 |
| 颗粒流模块(6.4 全新) | 离散元法(DEM)颗粒/粉末流 | 输送、混合、增材制造铺粉、料仓卸料 | 颗粒数决定负载,多核并行 |
2.5 化工与电化学模块群
| 模块 | 主要功能 | 应用场景 | 计算特征 |
|---|---|---|---|
| 化学反应工程模块 | 反应动力学、理想反应器、空间相关反应器 | 反应器设计、催化转化、CVD | 中等负载 |
| 电池模块 | 锂离子电池、铅酸、全电芯-热耦合 | 动力电池电化学-热-膨胀仿真、方形电池各向异性热 | 多物理场耦合主力负载 |
| 电化学模块 | 一次/二次电流分布、电分析 | 传感器、电解、伏安分析 | 中等 |
| 电镀模块 | 镀层厚度与形貌预测 | PCB 电镀、装饰镀、电铸 | 移动网格中等负载 |
| 腐蚀模块 | 电偶腐蚀、阴极保护 | 管道、船体、储罐防腐设计 | 中等 |
2.6 多用途与接口模块
| 模块 | 主要功能 | 应用场景 | 计算特征 |
|---|---|---|---|
| 优化模块 | 参数/形状/拓扑优化 | 结构轻量化、器件参数寻优 | 批量重求解,吃集群 |
| 不确定性量化模块 | 灵敏度分析、不确定性传播、可靠性 | 鲁棒设计、容差分析 | 批量采样任务 |
| 粒子追踪模块 | 带电/中性粒子场中运动 | 质谱、粒子加速器、离子光学 | 中等 |
| 材料库 | 数千种材料属性数据 | 全模块通用 | — |
| CAD 导入/设计模块 | CAD 文件导入、修复、参数化几何 | 与 SolidWorks/NX/Creo 等协同(支持 SOLIDWORKS 2026 等最新格式)3 | 轻量 |
| LiveLink 接口(MATLAB/Simulink/Excel/各 CAD) | 双向实时链接 | 脚本化建模、协同仿真、数据同步 | 视耦合方式 |
三、AI 大模型部署与 COMSOL 协同应用场景
COMSOL 是所有主流仿真软件中对大语言模型支持最开放的平台:6.4 版本的智能助手(Chatbot)原生支持 GPT-5、DeepSeek、Gemini 以及任意 OpenAI API 兼容的自托管服务——这意味着企业可以用本地私有化大模型驱动 COMSOL 建模助手,数据不出内网。4
3.1 三类 AI 与 COMSOL 的协同方式
| AI 类型 | 代表方案 | 与 COMSOL 的协同场景 | 算力需求 |
|---|---|---|---|
| 本地大语言模型(私有化) | DeepSeek V4 Flash(284B/激活 13B,1M 上下文)+ vLLM(OpenAI 兼容 API) | 直接接入 COMSOL 智能助手窗口:建模问答、物理场接口选择建议、Java API 代码生成、报错诊断;另可做仿真报告自动生成、历史模型知识库(RAG)检索 | 4-bit 量化版 24GB 显存可跑;原生权重约 160GB,推荐 2×96GB(192GB)显存 |
| DNN 代理模型(COMSOL 内置) | 深度神经网络代理模型(6.3+ 支持 GPU 训练) | 用批量仿真数据训练代理模型 → 仿真 App/数字孪生中毫秒级实时预测,替代单次分钟级~小时级的全阶求解 | GPU 训练(支持 CUDA 加速),24–48GB 显存覆盖多数场景;数据生产建议集群62 |
| 降阶模型(ROM) | 模态降阶、POD 降阶(COMSOL 内置) | 大模型压缩为轻量 ROM,嵌入系统仿真与实时控制 | CPU 为主,配合 GPU 代理模型 |
3.2 典型一体化工作流(企业实战)
DeepSeek V4 Flash 本地部署(vLLM,OpenAI 兼容 API)
        ↓ 接入
COMSOL 智能助手:建模指导 + API 代码生成 + 报错诊断
        ↓
参数化扫描/集群计算(批量生成训练数据)
        ↓
DNN 代理模型训练(GPU 加速)
        ↓
仿真 App(COMSOL Compiler/Server 分发)→ 设计部门毫秒级调用
        ↓
DeepSeek V4 Flash:仿真报告自动生成 + 模型知识库问答
3.3 部署要点
- GPU 加速的三大入口与条件:① cuDSS 通用直接求解器(6.4,全物理场);② 时域显式声学(dG 求解器,6.3 起,6.4 支持多 GPU 与集群);③ DNN 代理模型训练。三者均需 NVIDIA GPU + CUDA Toolkit(6.4 Update 1 起为 CUDA 12.9.1,已适配 Blackwell 架构)。356
- 多 GPU 需要网络浮动许可证:单 GPU 时域显式声学所有许可证类型可用;多 GPU(单机或集群)要求网络浮动许可证(FNL)。7
- 智能助手目前仅 Windows 版 COMSOL Desktop 提供;但自托管 LLM 服务(vLLM)应部署在 Linux GPU 服务器上,Windows 客户端通过局域网 API 调用——这是"Windows 建模终端 + Linux AI 服务器"的标准拓扑。4
- 数据安全分级:涉密研发单位选择"自托管 DeepSeek + 内网 vLLM"路径,COMSOL 官方对接口兼容,无需改造。
四、UltraLAB 硬件配置推荐(分档方案)
COMSOL 的硬件画像一句话概括:隐式 FEM 吃"高主频 + 大内存 + 内存带宽",6.4 起 GPU 加速进入通用时代(cuDSS 多卡),参数化扫描/优化吃集群节点数。基于 UltraLAB 2026 基准配置表推荐五档:
 图 2:UltraLAB 高频多核平台 + NVIDIA GPU 是 COMSOL 6.4 的理想载体(示意图,图片路径请替换为实际素材)
4.1 配置总表
| 档位 | 推荐机型 | 核心配置 | 适用场景 | 参考报价 |
|---|---|---|---|---|
| ① 入门教学/中小模型 | A350 153128-MCT | Intel Ultra9 265K 超频(20 核,8 性能核 5.3GHz)/ 128GB DDR5 / RTX 5090 v2 24GB / 4TB NVMe(14GB/s) | 通用多物理场入门、百万级 DOF 隐式模型、单 GPU 时域显式声学与 DNN 训练入门 | ¥61,000 |
| ② 主力设计仿真型 | GR450P 148256-MCB | 锐龙线程撕裂者 PRO 7985WX 超频(64 核 4.8GHz)/ 256GB DDR5 / 4TB NVMe | 结构静力、电磁仿真、流热耦合等大内存隐式 FEM 主力负载(报价表官方定位"有限元分析~设计与仿真异构计算型") | ¥210,000 |
| ③ 大内存+GPU 加速型 | EX660 230512-MDT | 2×Xeon 铂金 8570(112 核 3.0GHz)/ 512GB DDR5 / RTX 5090 32GB / 8TB NVMe Gen5 | 数百万 DOF 直接求解器、cuDSS GPU 加速、大规模 CFD 与声-结构耦合 | ¥320,000 |
| ④ 多 GPU 全能旗舰 | GX660M 232512-MD4F | 2×Xeon 铂金 8568Y+(96 核)/ 640GB DDR5 / 4×RTX Pro 6000 96GB(共 384GB 显存,ECC) / 8TB NVMe + 20TB SATA | cuDSS 多 GPU 并行(大模型容量突破)、时域显式声学多卡、DNN 代理模型批量训练 + **DeepSeek V4 Flash 原生权重本地部署(192GB)**供智能助手接入 | ¥669,000 |
| ⑤ 团队级仿真集群 | UltraLAB 设计仿真团队集群 | 4 台计算节点:2×霄龙 9475F(96 核 4.5GHz)/ 1TB DDR5;管理/存储节点 + 23TB 闪存阵列 + 126TB 并行存储 / 100G EDR 互联 | 参数化扫描、拓扑优化、代理模型数据生产等批量任务的节点级并行(需浮动许可证) | ¥946,000 |
4.2 选型逻辑说明
- 为什么主力档用 7985WX 超频平台:COMSOL 隐式 FEM 的 PARDISO/MUMPS 直接求解器高度依赖单核主频 + 内存带宽,64 核全核 4.8GHz 超频 + 8 通道 DDR5 是单槽性能天花板;256GB 内存覆盖 300–500 万 DOF 直接求解。
- 为什么 6.4 之后要重视显卡:cuDSS 实测——175 万 DOF 声学模型,H100 求解 30 秒 vs i9-10920X 191 秒(6 倍+);常规结构分析 RTX 5000 Ada 相对 Xeon CPU 也有 2 倍提速。56 显卡从"显示卡"变成了"求解加速器"。
- 为什么旗舰选 4×RTX Pro 6000 96GB:① cuDSS 多 GPU 并行可突破单卡显存容量上限,求解更大模型;② 时域显式声学多卡近乎线性加速(5000 万 DOF 案例:单卡 RTX 6000 Ada 29 分钟 → 双卡 18 分钟)7;③ 腾出 192GB 显存跑 DeepSeek V4 Flash 原生权重,直接做 COMSOL 智能助手的私有化后端——一台机器 = 仿真求解 + AI 助手 + 代理模型训练三合一。
- 为什么批量任务必须上集群:参数化扫描/优化/UQ 是节点级完美并行,4 节点 × 96 核的集群吞吐远超单机堆核;UltraLAB 集群含 100G EDR 互联、统一存储与作业调度,配合浮动许可证开箱即用。
五、常见问题硬件配置分析(FAQ)
Q1:COMSOL 支持 GPU 计算吗?主要是哪些求解器和模块?
| GPU 功能 | 适用求解器/模块 | 版本 |
|---|---|---|
| NVIDIA cuDSS 直接稀疏求解器 | 所有单物理场与多物理场(结构、电磁、声学、流体耦合均可),支持单机多 GPU 与集群 | 6.4 新增 |
| 时域显式压力声学(dG 间断伽辽金) | 声学模块——宽频声学、大规模三维声场(3 亿自由度级) | 6.3 起,6.4 扩展多 GPU/集群 |
| DNN 代理模型训练 | 代理模型/数字孪生 | 6.3 起 |
前提:NVIDIA GPU + CUDA Toolkit 12.9.1(6.4 Update 1 起,支持 Blackwell 架构)。
Q2:COMSOL 吃 CPU 核数还是主频?多少核合适?
分负载:隐式 FEM 直接求解器(PARDISO/MUMPS)吃单核主频 + 内存带宽,超过 16–32 核后加速比明显衰减,盲目堆 128 核浪费预算;迭代求解器、显式动力学、参数化扫描吃核数。通用单机建议 32–64 核高主频平台(如 7985WX 4.8GHz),核数需求交给集群解决。
Q3:内存配多少?怎么估算?
经验法则:三维隐式模型用直接求解器时,每 100 万自由度约需 20–40GB 内存(随物理场耦合数增加)。建议:中小模型 128GB 起步;300–500 万 DOF 主力模型 256–512GB;超大模型或内存不够时,6.4 的 cuDSS 多 GPU 方案可用显存扩展求解容量(4×96GB=384GB)。
Q4:COMSOL 用 Windows 还是 Linux?
两者都原生支持(与 Schrödinger 不同)。选择建议:交互建模 + 智能助手用 Windows(智能助手目前仅 Windows 版 Desktop 提供)4;批处理、集群计算、大内存节点用 Linux(调度生态成熟、内存开销小)。UltraLAB 方案常见组合:Windows 建模终端 + Linux 计算节点/集群。
Q5:多块 GPU 有什么额外要求?
两点硬门槛:① 许可证——单 GPU 时域显式声学任何许可证可用,多 GPU(单机多卡或集群)必须网络浮动许可证(FNL)7;② 硬件——多卡平台需充足 PCIe 通道与电源散热,UltraLAB GX660M 系列双路平台原生支持 4 卡全速 + 双 2000W 电源。
Q6:DeepSeek 本地部署给 COMSOL 智能助手用,怎么配?
COMSOL 智能助手支持任意 OpenAI API 兼容的自托管服务4,标准做法:Linux GPU 服务器上用 vLLM 部署 DeepSeek V4 Flash(原生权重约 160GB,需 2×96GB=192GB 显存;4-bit 量化版单卡 24GB 可跑,能力略降),Windows 端的 COMSOL 智能助手填局域网 API 地址即可。涉密单位全程内网,数据不出厂。
Q7:DNN 代理模型训练吃什么硬件?
数据生产吃 CPU 集群(批量参数化仿真,建议集群档);训练吃 GPU(6.3 起支持 CUDA 训练加速,24–48GB 显存覆盖多数代理模型)6。GX660M 旗舰单机即可"白天产数据、晚上训模型";量产级建议集群 + 多卡节点。
Q8:6.4 新增的显式动力学和颗粒流模块对硬件有什么要求?
显式结构动力学(跌落/撞击/爆炸):显式时间步进并行效率高,吃多核 CPU 与内存带宽,32–64 核高主频平台收益明显。颗粒流模块(DEM):负载随颗粒数增长,数十万颗粒级用 32 核+128GB 起步;大规模 DEM-CFD 耦合建议 512GB 内存 + 多核平台。
Q9:参数化扫描和优化太慢,加硬件能解决吗?
这类任务是"同一模型换参数跑 N 次",属于完美并行:最快路径不是升级单机,而是浮动许可证 + 集群扫描——4 节点集群(384 核)可把 100 组参数的扫描从 3 天压到 1 晚。UltraLAB 设计仿真团队集群(¥946,000)即为此类场景设计,含调度与统一存储。
Q10:预算 10 万以内跑 COMSOL(含试试 GPU 加速),怎么配?
选 A350 153128-MCT(¥61,000):Ultra9 265K 超频(性能核 5.3GHz)保证单核求解速度,128GB 内存覆盖 200 万 DOF 级模型,RTX 5090 v2 24GB 可体验 cuDSS 加速、时域显式声学 GPU 求解与 DNN 训练,还能跑 4-bit 量化 DeepSeek 给智能助手做私有化后端。剩余预算可加 20TB SATA 盘做模型库归档。
六、结语
COMSOL 6.4 改变了仿真工作站的配置逻辑——过去"CPU 堆内存、显卡只负责显示",如今 cuDSS 让 GPU 成为通用求解加速器,本地 DeepSeek 大模型又能直接驱动智能助手。新配置公式是:高主频多核 CPU(隐式 FEM)+ 大内存(直接求解器)+ 大显存多卡(cuDSS/显式声学/DNN/LLM)+ 集群(批量扫描)。
UltraLAB 图形工作站提供从 ¥61,000 入门机型到 4×RTX Pro 6000 旗舰、再到设计仿真团队集群的完整梯度,所有机型支持按需定制配置与免费远程实测——用您的真实 COMSOL 模型跑一遍,性能达标再付款。
咨询方式:访问 UltraLAB 官网(xasun.com)或联系销售工程师,提供您的模块清单(如 AC/DC+传热+声学)与模型自由度规模,获取定制配置单与实测报告。


