






2026年8月27日 · 阅读时间约 18 分钟 · 适用读者:航空发动机工程师、气动热力分析师、国防科研院所、CAE仿真主管、AI算法工程师
核心观点:NK-32发动机是全球唯一量产的三转子军用大推力加力涡扇发动机,单台加力推力245kN(25吨),四台并联推动275吨的图-160实现2马赫超音速巡航。其3级低压风扇+5级中压压气机+7级高压压气机的复杂气动布局、1357°C涡轮前温度、空心单晶叶片冷却技术,对仿真算力提出了极致要求——整机非定常大涡模拟需20亿求解点,多物理场耦合需TB级内存,AI代理模型训练需96GB显存。本文基于2026年最新工程实践,提供从入门到旗舰的四级UltraLAB硬件配置方案。
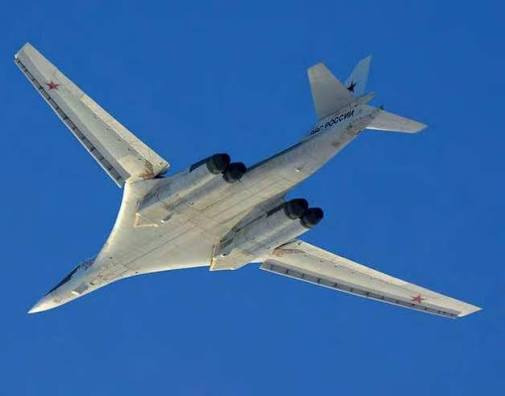
一、NK-32发动机:三转子架构的技术传奇
1.1 基本技术参数
NK-32由苏联库兹涅佐夫设计局于1977年开始研制,1983年正式量产,是全球唯一采用三转子(三轴)结构的军用大推力加力涡扇发动机
| 参数项 | NK-32(初代) | NK-32-02(改进型) | 技术含义 |
|---|---|---|---|
| 加力推力 | 245 kN(25,000 kgf) | 245 kN(维持) | 全球军用涡扇最强推力级别 |
| 巡航推力 | 137 kN(14,000 kgf) | 142 kN | 亚音速巡航效率提升 |
| 推重比 | 7.35 | 7.5 | 结构减重与材料升级 |
| 涵道比 | 1.4 | ~1.3 | 低涵道比适合超音速飞行 |
| 总增压比 | 28.4 | ~28 | 高压压气机极限设计 |
| 涡轮前温度 | 1357°C(1630 K) | ~1400°C | 空心单晶叶片+复杂冷却通道 |
| 干重 | 3,400 kg | 3,600 kg | 钛合金+镍基合金主体 |
| 长度 | 6,000 mm | 7,453 mm | 含加力燃烧室与可调喷管 |
| 最大直径 | 1,460 mm | 1,785 mm | 风扇外径 |
| 亚音速油耗 | 0.72 kg/(kgf·h) | 0.64–0.65 kg/(kgf·h) | 油耗降低10%,航程+1000km |
| 超音速油耗 | 1.70 kg/(kgf·h) | ~1.55 kg/(kgf·h) | 加力燃烧效率优化 |
| 大修间隔 | 500小时 | 1000小时+ | 数字控制系统+新材料 |
1.2 三转子架构的技术独特性
与美军F101-GE-102等双转子发动机不同,NK-32引入了中压转子,形成三根同心轴独立运转 三转子结构使得发动机各部件分别工作在理想转速下,推力得到进一步提升,而且更省油
- 低压轴:驱动3级风扇 + 2级低压涡轮,转速最低,优化大流量进气
- 中压轴:驱动5级中压压气机 + 1级中压涡轮,转速中等,解决高低压转速矛盾
- 高压轴:驱动7级高压压气机 + 1级高压涡轮,转速最高,实现28.4总增压比
这种设计的代价是结构复杂度指数级上升:多转轴、多轴承、多管路、多级盘片耦合,装配流程繁琐、检修难度大、故障点位更多 三转子多转轴、多轴承的复杂结构,造成整机管路、传动部件数量大幅增加,装配流程繁琐、检修难度大、维护成本高昂、故障点位更多。这也使得NK-32的仿真分析难度远超常规双转子发动机。
1.3 主要应用平台
| 平台 | 角色 | 动力配置 | 性能指标 |
|---|---|---|---|
| 图-160"白天鹅" | 超音速战略轰炸机 | 4× NK-32 | 275吨起飞重量,2.05马赫极速,12300km航程 |
| 图-160M2 | 现代化升级型 | 4× NK-32-02 | 航程+1000km,数字飞控,隐身涂层 |
| 图-22M3M | 超音速中程轰炸机 | 2× NK-32-02 | 替代NK-25,推力升级 |
| 图-144LL | 超音速客机试验机 | 4× NK-32 | 验证超音速民航技术 |
| PAK DA | 下一代隐身战略轰炸机 | 4× NK-32 Tier 2(无加力版) | 亚音速隐身巡航,30吨载弹量 |
二、NK-32发动机AI分析的七大技术环节
2.1 整机仿真技术架构
对NK-32这类三转子加力涡扇发动机进行AI辅助分析,需要覆盖从进气道到尾喷管的全通路多物理场耦合:
 图1:NK-32发动机AI分析七大技术环节全链路
2.2 七大技术环节详解
| 序号 | 技术环节 | 分析对象 | 核心难点 | AI赋能方式 | 典型软件 |
|---|---|---|---|---|---|
| ① | 气动性能分析 | 3级风扇+5级中压+7级高压压气机叶型;可调收敛-扩张喷管 | 三级转子转速耦合、跨音速叶栅激波、喘振边界预测 | AI代理模型替代90%工况点CFD;神经网络预测喘振裕度 | CFX、Fluent、DIMAXER、STAR-CCM+ |
| ② | 燃烧室仿真 | 环形燃烧室、双点火器、燃油雾化与掺混 | 高温(>2000°C)燃烧、NOx生成、燃烧不稳定 | 物理信息神经网络(PINN)嵌入化学反应机理;AI优化燃油分布 | Chemkin、CONVERGE、Fluent |
| ③ | 结构强度与疲劳 | 17片空心单晶涡轮叶片、钛合金压气机盘、镍基合金机匣 | 热-机械耦合疲劳、蠕变-疲劳交互、低周疲劳寿命 | AI预测裂纹萌生位置;数字图像相关(DIC)数据驱动 | Abaqus、ANSYS Mechanical、nCode |
| ④ | 热管理与冷却 | 涡轮叶片内部冷却通道、气膜孔、热障涂层(TBC) | 1357°C燃气 vs 900°C金属壁温差;冷却效率与气动损失权衡 | AI优化冷却通道拓扑;代理模型快速评估冷却方案 | Icepak、FloTHERM、COMSOL |
| ⑤ | 转子动力学 | 三轴同心转子、多轴承支承、临界转速、不对中 | 三转子耦合振动、油膜涡动、碰摩故障 | 机器学习故障诊断;LSTM预测振动趋势 | ANSYS Rotordynamics、ADAMS、MATLAB |
| ⑥ | 红外隐身特征 | 加力燃烧室火焰稳定器、尾喷管红外辐射、旁路冷却气流 | 加力工况红外信号强烈;需平衡推力与隐身 | AI代理模型快速评估红外特征;多目标优化喷管型面 | FLIR分析工具、自研辐射传输代码 |
| ⑦ | 数字孪生与PHM | 整机健康状态、寿命预测、故障预警、维护决策 | 多源异构数据融合(振动+温度+油液+性能) | 大模型(LLM)解析维护手册;GNN图神经网络建模部件关联 | Python、PyTorch、NVIDIA Modulus、自研平台 |
表3:NK-32发动机AI分析七大技术环节、核心难点与软件工具映射
2.3 计算特征:为什么航空发动机仿真是最"吃"算力的CAE场景?
| 计算维度 | 具体特征 | 硬件影响 |
|---|---|---|
| 网格规模 | 整机非定常大涡模拟(LES)需20亿求解点;单叶片RANS需5000万–2亿网格单节点20亿求解点的实用化仿真能力 | 内存需求TB级;GPU显存48GB+ |
| 多物理场耦合 | 气动+燃烧+结构+热+转子动力学五场耦合,数据传递密集 | 内存容量决定耦合规模;存储I/O带宽决定迭代速度 |
| 时间尺度跨度 | 转子转速(万转/分)vs 燃烧脉动(kHz级)vs 热惯性(分钟级) | 需要多时间步长耦合策略;长时瞬态计算耗时长 |
| 非线性强度 | 湍流、燃烧化学反应、材料非线性、接触非线性叠加 | 收敛困难;需要高主频CPU保障矩阵分解速度 |
| AI训练数据量 | 单个DOE(100个工况×20个部件)产生数百GB场数据 | NVMe Gen5 SSD刚需;存储容量10TB+ |
三、大模型本地部署:航空发动机分析的"智能智库"
3.1 为什么需要本地部署?
NK-32发动机的AI分析涉及大量敏感技术参数(叶片型线、冷却通道拓扑、材料成分、推力曲线),数据安全是红线。本地部署大模型的核心价值:
| 维度 | 云端API | 本地部署(UltraLAB) |
|---|---|---|
| 数据安全 | 设计参数上传第三方,存在泄密风险 | 数据完全不出域,满足国防保密要求 |
| 知识库定制 | 通用模型,无法理解航空发动机专有术语 | 可注入NK-32技术手册、试验数据、故障案例 |
| 响应实时性 | 网络波动导致延迟,不适合实时诊断 | 本地GPU推理,毫秒级响应,支持实时PHM |
| 成本可控 | 按Token计费,整机分析高频调用成本不可控 | 一次性硬件投资,长期使用零边际成本 |
| 离线可用 | 依赖网络,试验现场/外场无法使用 | 完全离线运行,试验室/机库/外场均可部署 |
3.2 本地部署的算力需求
| 模型规模 | 参数量 | 最低显存 | 推荐显存 | 适用场景 |
|---|---|---|---|---|
| 轻量助手 | 7B | 16GB | 24GB | 技术问答、文献检索、简单代码生成 |
| 专业分析 | 13B–32B | 32GB | 48GB | 气动参数解读、故障诊断推理、报告生成 |
| 旗舰智库 | 70B | 80GB | 96GB+ | 整机设计决策支持、多文档关联分析、数字孪生对话 |
关键提示:NK-32的三转子结构分析需要大模型理解复杂的多轴耦合关系、转速匹配、喘振边界等专业知识,属于深度领域推理。建议至少配置48GB显存以流畅运行32B级专业模型;若需同时加载整机技术手册(数万页PDF)进行RAG检索,建议升级至96GB。
四、软件清单:从气动CFD到AI数字孪生的全栈工具链
4.1 核心仿真软件矩阵
| 软件名称 | 厂商/来源 | 类型 | 在NK-32分析中的核心功能 | 硬件依赖 |
|---|---|---|---|---|
| ANSYS CFX / Fluent | Ansys | CFD求解器 | 三级压气机全通道非定常流场、喘振边界预测、喷管气动优化 | 高主频CPU + 大内存 + GPU(GPU原生加速) |
| DIMAXER | 秩益科技(国产) | GPU原生CFD | 航空发动机整机20亿点大涡模拟;单GPU 2.5亿求解点;较传统方案提速100–1000倍 单GPU卡2.5亿求解点、单节点20亿求解点的实用化仿真能力 | NVIDIA A100/H100(大显存GPU刚需) |
| STAR-CCM+ | Siemens | 多物理场CFD | 旋转机械、多相流、传热、气动噪声一体化分析 | 多核CPU + 高端GPU |
| ANSYS Mechanical | Ansys | 结构求解器 | 空心叶片热-机械耦合疲劳、机匣强度、盘片应力 | 高主频CPU + 大内存 |
| Abaqus | Dassault | 非线性结构 | 单晶叶片蠕变-疲劳、接触非线性、断裂力学 | 高主频CPU + 大内存 |
| ANSYS Chemkin | Ansys | 燃烧仿真 | 航空煤油燃烧机理、NOx生成、燃烧不稳定分析 | 多核CPU |
| CONVERGE | Convergent Science | 燃烧CFD | 喷雾燃烧、自动网格生成、湍流燃烧耦合 | 多核CPU + GPU |
| ANSYS Icepak / FloTHERM | Ansys / Siemens | 热分析 | 涡轮叶片冷却通道优化、热障涂层评估 | 中等CPU + 内存 |
| ANSYS Rotordynamics | Ansys | 转子动力学 | 三轴临界转速、不平衡响应、油膜轴承稳定性 | 高主频CPU |
| ADAMS | Hexagon | 多体动力学 | 整机振动响应、支承系统动力学 | 中等CPU |
| nCode DesignLife | Hexagon | 疲劳分析 | 空心叶片低周疲劳、热-机械疲劳寿命预测 | 多核CPU |
| MATLAB / Simulink | MathWorks | 系统仿真 | 发动机控制系统建模、数字孪生框架搭建 | 中等CPU |
4.2 AI与数字孪生工具链
| 工具/框架 | 类型 | 在NK-32分析中的核心用途 | 硬件要求 |
|---|---|---|---|
| PyTorch + NVIDIA Modulus | AI框架 | PINN嵌入N-S方程与燃烧方程;代理模型替代全通道CFD | NVIDIA GPU,显存≥48GB |
| DeepSpeed | 训练优化 | 大模型分布式训练、显存优化、ZeRO-Offload | 多GPU + NVLink |
| LangChain + RAG | AI应用框架 | 构建NK-32专用知识库(技术手册+试验数据+故障案例) | GPU显存决定上下文长度 |
| Ollama / vLLM | 本地部署 | 一键本地运行Llama 3、DeepSeek、Qwen等开源大模型 | GPU显存≥模型需求 |
| TensorRT | 推理加速 | AI代理模型推理优化,毫秒级响应 | NVIDIA GPU |
| ONNX Runtime | 跨平台推理 | 将PyTorch训练的代理模型部署至边缘设备 | NVIDIA/AMD GPU |
| Python + NumPy/SciPy | 科学计算 | 试验数据处理、性能曲线拟合、参数辨识 | CPU多核 |
| ParaView / Tecplot | 可视化 | 20亿网格点流场后处理、动画生成 | GPU加速渲染 |
4.3 开源生态与自研工具
| 工具 | 类型 | 特点 |
|---|---|---|
| OpenFOAM | 开源CFD | 可自定义湍流模型与燃烧模型,适合科研探索 |
| SU2 | 开源CFD | 航空航天专用,支持伴随法优化、气动外形敏度分析 |
| Cantera | 开源燃烧 | 化学反应机理开源库,适合航空煤油替代燃料研究 |
| MoS2 / FEniCS | 开源FEM | 自定义偏微分方程求解,适合新型冷却结构拓扑优化 |
| 自研数字孪生平台 | 企业级 | 整合气动+结构+热+控制多源数据,实现NK-32全生命周期管理 |
五、UltraLAB硬件配置选型指南
5.1 选型核心原则:航空发动机仿真的"三重算力悬崖"
NK-32级别的航空发动机仿真,硬件需求呈现三个陡峭的"算力悬崖":
- CFD悬崖:从RANS到LES,网格数从5000万跃升至20亿,内存需求从64GB跃升至1TB+
- GPU悬崖:DIMAXER等GPU原生求解器需要大显存(48GB+),传统CFD(CPU-only)与GPU加速CFD的算力差距达100–1000倍 GPU原生加速带来的成本效率(较传统方案降低100至1000倍)
- AI悬崖:从7B轻量模型到70B专业智库,显存需求从16GB跃升至96GB+
5.2 四级UltraLAB配置方案
方案A:单部件气动分析与AI入门(预算 3–5万)
表10:UltraLAB A350 入门配置 —— 适用于压气机单级叶型分析、7B级LLM本地部署| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB A350 15064-MBX | 个人旗舰工作站,水冷超频优化 |
| CPU | Intel Ultra7 265K(20核,8P核全核5.1GHz)+ 水冷 | 高主频保障单级叶片CFD前处理与网格划分流畅;20核支持轻量并发 |
| GPU | NVIDIA RTX 5060Ti 16GB | 轻量AI推理;DIMAXER小规模测试(<5000万点) |
| 内存 | 64GB DDR5-5600 | 支撑单级压气机RANS(500万网格)+ 7B大模型驻留 |
| 存储 | 2TB NVMe Gen4 SSD + 4TB HDD | 系统与活跃项目SSD,试验数据归档HDD |
| 散热 | 360mm 一体式水冷 | 保障CPU满载不降频,长时间CFD求解稳定性 |
| 适用场景 | 研究生入门、单级叶片气动优化、简单结构强度校核、7B级LLM技术问答 | — |
方案B:多级压气机耦合与中等规模AI训练(预算 6–9万)
表11:UltraLAB A350 专业配置 —— 适用于三级压气机非定常分析、13B–32B级LLM| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB A350 156128-MCA | 专业工作站,水冷超频优化 |
| CPU | Intel Ultra9 285K(24核,8P核全核5.6GHz)+ 水冷 | 24核高频CPU显著缩短非定常CFD求解时间;5.6GHz全核超频实测优化 |
| GPU | NVIDIA RTX Pro 5000 32GB 或 RTX 4090 24GB | 32GB显存可本地部署13B–32B级大模型;支撑DIMAXER中等规模仿真(<2亿点) |
| 内存 | 128GB DDR5 RDIMM(4×32GB) | 满足三级压气机全通道非定常分析(2000万网格);大模型上下文缓存 |
| 存储 | 4TB NVMe Gen5 SSD(14GB/s) | 高读写寿命,应对非定常CFD产生的海量瞬态数据 |
| 散热 | 双冷排+双水泵水冷散热系统 | CPU+GPU双满载场景下维持低温稳定运行 |
| 适用场景 | 企业气动工程师日常分析、多级压气机性能评估、中等规模DOE、13B–32B级LLM本地部署 | — |
方案C:整机大涡模拟与AI代理模型训练(预算 12–18万)
表12:UltraLAB AE450 科研配置 —— 适用于整机LES、多物理场耦合、AI代理模型训练| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB AE450 145128-MCA | 科研级算力平台,CPU与GPU平衡架构 |
| CPU | AMD EPYC 9275F(24核4.5GHz)+ 水冷 | 多核性能适合驱动并行CFD任务;4.5GHz全核超频实测优化频率 |
| GPU | NVIDIA RTX Pro 5000 48GB 或 A100 80GB | 48GB显存支持DIMAXER整机大涡模拟(2.5亿点/卡);支撑AI代理模型(PINN/FNO)训练 |
| 内存 | 128GB DDR5 ECC RDIMM | 支撑整机RANS(5000万网格)+ 结构耦合;多任务并发内存隔离 |
| 存储 | 4TB NVMe Gen5 SSD + 8TB SATA企业级HDD | 全闪存阵列保障高频IO吞吐;大容量HDD归档历史算例 |
| 网络 | 万兆以太网 | 便于团队协作与试验数据高速传输 |
| 适用场景 | 整机非定常气动分析、燃烧室详细仿真、AI代理模型训练、32B级LLM本地部署 | — |
方案D:旗舰工程版 / 整机数字孪生与超大规模AI(预算 20–35万)
表13:UltraLAB EX660 旗舰配置 —— 适用于20亿点LES、整机数字孪生、70B级LLM本地部署
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB EX660 227256-MCB | 企业级共享计算平台,双路服务器架构 |
| CPU | 2× Intel Xeon Gold 6530(64核2.7GHz)+ 工业水冷 | 64核物理核心支持"6–8个CFD任务并行"或"单任务全线程";遗传算法优化时每个种群独立占用核心 |
| GPU | NVIDIA A100 80GB ×4(NVLink)或 H100 80GB ×2 | 80GB显存×4卡=320GB总显存,彻底释放DIMAXER 20亿点整机LES潜力;支撑70B级大模型本地部署与微调 |
| 内存 | 256GB–512GB DDR5 ECC RDIMM | 支撑20亿点LES网格驻留 + 多物理场耦合;多用户并发内存隔离 |
| 存储 | 8TB NVMe Gen5 SSD(系统+活跃项目)+ 16TB SATA企业级HDD(RAID1) | NVMe Gen5提供14GB/s读写,应对批量任务数据洪峰;RAID1保障试验数据安全 |
| 网络 | 100G InfiniBand | 多节点集群扩展;多GPU高速互联 |
| 散热 | 分体式水冷+独立水泵 | 保障AVX-512指令集持续高频运行不降频;多卡+多核持续满载的终极散热方案 |
| 适用场景 | 整机20亿点大涡模拟、全通路多物理场耦合、数字孪生实时推演、70B级LLM本地部署、7×24小时连续运算 | — |
航空发动机仿真内存容量速查表
| 仿真级别 | 网格规模 | 内存需求 | 适用分析 |
|---|---|---|---|
| 单级叶片RANS | 100–500万 | 32–64GB | 叶型优化、损失评估 |
| 单级叶片LES | 2000–5000万 | 128–256GB | 非定常分离流、尾迹干涉 |
| 三级压气机RANS | 5000万–2亿 | 256–512GB | 级间匹配、喘振边界 |
| 整机RANS | 2–5亿 | 512GB–1TB | 整机性能、安装效应 |
| 整机LES | 10–20亿 | 1–2TB+ | 全环非定常大涡模拟、湍流细节捕捉 |
5.3 常见问题硬件配置深度分析(FAQ)
Q1:为什么航空发动机CFD需要GPU原生求解器(如DIMAXER)?传统CPU求解器不够用吗?
以NK-32整机20亿点大涡模拟为例:
| 求解方式 | 硬件配置 | 预估耗时 | 成本效率 |
|---|---|---|---|
| 传统CPU求解器 | 双路Xeon 64核 | 数周–数月 | 基准 |
| CPU+GPU混合(Fluent) | 双路Xeon + RTX 4090 | 数天–数周 | 5–10× |
| GPU原生(DIMAXER) | 4× A100 80GB | 数小时–1天 | 100–1000× |
结论:对于航空发动机整机高保真仿真,GPU原生求解器已从"可选项"变为"刚需"。UltraLAB旗舰配置的4×A100方案,可将原本数月的计算压缩至一天内完成,这是设计迭代速度的根本性变革。
Q2:NK-32的三转子结构仿真,对CPU有什么特殊要求?
三转子动力学分析涉及三根同心轴+多轴承+多盘片的耦合振动,其有限元模型具有以下特征:
- 自由度规模巨大:每级盘片×3轴×6自由度,整机模型可达数千万DOF
- 矩阵非对称:陀螺效应、油膜轴承导致刚度矩阵非对称,求解器兼容性要求高
- 频响分析密集:需在0–500Hz范围内扫描数百个频率点,寻找临界转速
CPU选型建议:
- 以ANSYS Rotordynamics为主:选高主频(≥4.5GHz全核)+ 16–28核,矩阵分解单核敏感
- 以批量临界转速扫描/DOE为主:选多核(56核+),每个频率点独立占用8核并行
Q3:大模型本地部署,为什么推荐70B级而非7B级?
航空发动机分析属于深度领域知识推理,7B级模型存在明显局限:
| 能力维度 | 7B模型 | 32B模型 | 70B模型 |
|---|---|---|---|
| 三转子转速匹配理解 | 模糊,常混淆双/三转子 | 准确,可解释级间关系 | 精准,可推导最优转速比 |
| 喘振边界预测 | 无法计算 | 可引用公式,数值不准 | 可结合CFD数据给出定量预测 |
| 技术手册RAG检索 | 简单匹配 | 多文档关联 | 跨文档推理,生成综合结论 |
| 故障诊断推理 | 表面描述 | 多因素关联 | 根因定位,给出维护建议 |
| 报告生成质量 | 模板化 | 结构化 | 工程化、可追溯、可验证 |
结论:对于NK-32级别的专业分析,32B是可用底线,70B是推荐配置。UltraLAB EX660的96GB显存方案可流畅运行70B模型,支撑真正的"智能智库"。
Q4:为什么水冷散热对航空发动机仿真至关重要?
航空发动机CFD求解器(Fluent、DIMAXER)和结构求解器(Abaqus)重度依赖AVX-512指令集,CPU满载功耗可达300W+。风冷在持续满载下会出现热降频:
- 标称4.5GHz的CPU,风冷满载可能跌至3.2GHz
- 20亿点LES求解时间增加40–60%
- 长时间运行稳定性下降,偶发内存错误(ECC无法完全规避)
UltraLAB的分体式水冷+独立水泵方案,可将CPU温度控制在60°C以下,GPU温度控制在70°C以下,保障AVX-512持续高频运行,稳定性提升显著。
Q5:NVMe Gen5 SSD在航空发动机仿真中的价值有多大?
以NK-32整机非定常LES为例,单次计算产生的数据量:
| 数据类型 | 数据量 | 存储需求 |
|---|---|---|
| 网格文件 | 50–100GB | 长期归档 |
| 瞬态流场结果(1000时间步) | 500GB–1TB | 分析期高频访问 |
| 试验数据(振动+温度+性能) | 100–500GB | 长期归档 |
| AI训练数据集(1000个工况) | 2–5TB | 训练期高频访问 |
| 单次项目总计 | 3–7TB | 分层存储策略 |
速度对比:
| 存储类型 | 顺序读写 | 1000步瞬态数据加载时间 |
|---|---|---|
| SATA HDD | 200MB/s | 2–4小时 |
| SATA SSD | 500MB/s | 1–2小时 |
| NVMe Gen4 | 7GB/s | 5–10分钟 |
| NVMe Gen5 | 14GB/s | 2–5分钟 |
结论:对于需要频繁加载海量瞬态数据的航空发动机后处理与AI训练,NVMe Gen5是生产力刚需。
Q6:双路Xeon和单路Threadripper,航空发动机仿真怎么选?
| 维度 | 单路Threadripper PRO 7995WX(96核) | 双路Xeon Gold 6530(64核) |
|---|---|---|
| 核心数 | 96核 | 64核(32×2) |
| 内存通道 | 8通道(带宽高) | 16通道(双路,带宽极高) |
| 内存容量上限 | 2TB | 4TB+ |
| NUMA | 无 | 有(需优化内存亲和性) |
| 单任务性能 | 极强(单路无NUMA开销) | 强(跨Socket通信有延迟) |
| 多任务并发 | 强 | 极强(物理隔离两个Socket) |
| DIMAXER GPU求解 | 单节点性能强 | 多节点扩展好 |
| 价格 | 较高 | 性价比更优 |
选型建议:
- 以单机超大模型(20亿点LES)为主 → 选单路Threadripper + 4×A100,避免NUMA开销
- 以团队多任务并发(6–8个工程师同时提交)为主 → 选双路Xeon,每个Socket独立服务一个用户
- UltraLAB推荐:航空发动机仿真场景优先选双路Xeon Gold/Platinum,兼顾多任务并发与大内存扩展(可达4TB)
六、投资回报测算:算力升级的经济账
以UltraLAB EX660旗舰配置(¥25万级)实测NK-32整机仿真+AI分析工作流:
| 指标 | 传统配置(¥5万级) | UltraLAB旗舰配置(¥25万级) | 提升倍数 |
|---|---|---|---|
| 单级叶片RANS求解 | 8小时 | 1小时 | 8× |
| 三级压气机非定常分析 | 72小时(3天) | 8小时 | 9× |
| 整机20亿点LES | 数周–数月 | 1–2天 | 15–30× |
| AI代理模型训练(1000工况) | 48小时 | 6小时 | 8× |
| 大模型报告生成 | 人工4小时/份 | 自动10分钟/份 | 24× |
| 设计迭代周期 | 3个月 | 2周 | 6× |
| 人力成本节省 | — | ¥3,000/天(按¥750/小时计) | — |
| 硬件投资回收周期 | — | 8–12个月 | — |
隐性收益
- 试验成本节约:整机高空台试验单次成本数百万元,AI代理模型可在虚拟空间完成90%工况筛选,仅保留10%关键工况进行物理验证
- 故障预测收益:数字孪生提前预警涡轮叶片裂纹,避免空中停车事故,单次避免损失不可估量
- 知识沉淀:资深发动机设计师的经验通过Skill模板固化,新人3个月即可独立承担分析任务
- 保密合规:本地部署确保NK-32核心技术参数不出域,满足国防保密与出口管制要求
- 7×24小时运转:夜间自动执行DOE与AI训练,工程师次日直接查看优化结果
七、UltraLAB 2026航空发动机仿真+AI产品矩阵速查
表15:UltraLAB 2026年航空发动机整机仿真+AI大模型部署产品矩阵| 预算区间 | 推荐机型 | 核心配置 | 适用场景 | 目标用户 |
|---|---|---|---|---|
| 3–5万 | UltraLAB A350 | Ultra7 265K + RTX 5060Ti 16GB + 64GB | 单级叶片气动分析、结构校核、7B级LLM | 研究生、初级工程师 |
| 6–9万 | UltraLAB A350 Pro | Ultra9 285K + RTX Pro 5000 32GB + 128GB | 多级压气机非定常、中等规模DOE、13B–32B级LLM | 企业气动工程师 |
| 12–18万 | UltraLAB AE450 | EPYC 9275F + RTX Pro 5000 48GB + 128GB | 整机RANS、燃烧室详细仿真、AI代理训练、32B级LLM | 科研团队、仿真主管 |
| 20–35万 | UltraLAB EX660 | 双Xeon Gold 6530 + A100 80GB×4 + 256–512GB | 20亿点LES、整机数字孪生、70B级LLM、团队共享 | 研发总监、高校PI |
| 40–80万 | UltraLAB GA660M | 双EPYC 9755 + H100×4 + 1–2TB | 超大规模系统仿真、国家级课题、AI大模型微调 | 大型研发团队 |
| 80万+ | UltraLAB AlphaPro660 | 双EPYC 9575F + 8×B200 + 全液冷 + 4TB内存 | 7×24持续计算、国家级发动机仿真中心 | 科研院所、国防单位 |
结语:算力即国力,平台即壁垒
NK-32发动机诞生于冷战最激烈的年代,苏联工程师用三转子架构解决了大推力与高效率的矛盾,创造了航空动力史上的奇迹。近半个世纪后的今天,当AI与大模型成为新一轮技术革命的核心引擎时,算力平台正在成为航空发动机研发的"新基础设施"。
一台经过精准调优的UltraLAB工作站,不仅能将NK-32级别的整机大涡模拟从"数月"压缩到"一天",更能通过本地部署的70B级大模型,构建起属于中国工程师自己的"智能航空发动机智库"——从气动设计到故障诊断,从燃烧优化到数字孪生,全流程AI赋能,全数据本地安全。
选型金句:航空发动机仿真的硬件投资,不是成本,而是技术主权与时间主权。8–12个月的回收周期,换来的是15–30倍的仿真提速、6倍的设计迭代加速,以及可沉淀的国家级航空发动机知识资产。在航空动力自主可控的战略背景下,选对软件工具链,更要配好底层算力平台,才能让"AI+航空发动机"从概念真正落地为生产力。
UltraLAB定制图形工作站 —— 为航空发动机整机仿真、DIMAXER GPU原生求解、大模型本地部署及数字孪生平台提供极致算力支撑。
支持深度配置定制、三年上门质保、CAE软件预装调优、涉密环境安全加固服务。
供货商:西安坤隆计算机科技有限公司 · 国内知名高端定制图形工作站厂家
业务电话:400-705-6800
技术咨询微信:100369800 / xasun001
官方网站:www.xasun.com


