






未来 2—6 周,一直是短中期天气预报与季节气候预测之间的“技巧低谷”。MicroDuet 的价值,不是精确预言第 30 天几点下雨,而是通过 AI 后处理与概率偏差校正,让月尺度的温度、降水和环流风险判断更可靠。
本文以 MicroDuet、PBC(Probabilistic Bias Correction,概率偏差校正)和 PoET 集合后处理为核心,拆解其数据链路、相关算法、计算特点、AI 推理方式、行业应用与 UltraLAB 硬件选型,适合气象科研机构、农业与能源企业、水利应急部门、保险科技团队及 AI for Science 平台参考。
**先给结论:**MicroDuet 更像安装在现有动力或 AI 集合预报之上的“智能校准层”。其推理通常不需要从零运行一套全球数值预报系统,但生产部署仍需要稳定的数据下载、历史回报管理、张量后处理、概率产品生成、可视化和归档能力。
本文目录
- MicroDuet 到底是什么
- 为什么 2—6 周天气预报这么难
- 核心计算环节与相关算法
- AI 推理如何形成业务产品
- 应用场景与决策价值
- UltraLAB 硬件配置怎么选
- 软件清单与部署环境
- 常见硬件配置问题与排查
- 采购与业务验收清单
一页看懂:月尺度 AI 天气预报算什么、吃什么硬件?
| 计算环节 | 典型输入/输出 | 主要算法或操作 | 首要硬件指标 | 常见瓶颈 |
|---|---|---|---|---|
| 实时预报数据接入 | ECMWF 等集合预报、静态场 | 下载、校验、解码、格式转换 | 网络、CPU、NVMe | 数据延迟、文件损坏 |
| 历史回报与再分析管理 | Hindcast、ERA5/观测目标 | 时间对齐、分区索引、缺测处理 | 容量存储、内存、元数据 | 数据版本混乱 |
| 动力/AI 基础预报 | 多成员大气状态 | 数值积分或基础模型推理 | 通常由上游中心提供 | 误认为本地必须重建 |
| PoET 集合后处理 | 多变量、多成员、多时效 | Ensemble Transformer | GPU 显存、内存带宽 | 成员与变量维度膨胀 |
| PBC 概率偏差校正 | 历史预报—观测对、实时集合 | 概率校准、分布校正、偏差学习 | CPU/GPU、内存、NVMe | 时间泄漏与样本匹配 |
| 概率产品生成 | 分位数、类别概率、集合成员 | RPSS、CRPS、阈值和区域统计 | CPU、内存 | 指标口径不一致 |
| 降尺度与行业产品 | 全球网格到区域/站点 | 统计降尺度、插值、风险模型 | CPU、内存,可选 GPU | 把插值当新增信息 |
| 可视化与服务 | 地图、时间序列、API | 渲染、切片、查询、缓存 | CPU、NVMe、网络 | 并发与数据服务 |
选型口诀:模型推理看显存,集合数据看内存,历史回报看存储,业务时效看数据链路,行业价值看概率校准与真实验证。
一、MicroDuet 到底是什么?不是一个“凭空预测下个月”的聊天模型
MicroDuet 是面向次季节集合预报的组合方案。根据 Microsoft Research 公开介绍,它把 PBC 概率偏差校正应用于 ECMWF 的动力预报与融合 Transformer 的混合模型 PoET,用于改善未来 2—6 周概率预报。
在 ECMWF 于 2025 年启动的 AI Weather Quest 实时竞赛中,MicroDuet 在首个三个月赛季的各天气变量和预报时效上排名第一;Microsoft Research 还报告其完整一年实时预报表现,以及提前 19—26 天提示 2026 年初美国冬季风暴风险的案例。相关 PBC 论文报告,它使 AIFS 的次季节技巧加倍,并改善动力模型在所评估气压、温度和降水目标上的大部分表现。
这些结果说明其研究与业务潜力,但应注意三个边界:
- 它是概率预报,不是逐日确定性承诺。更适合回答“某周偏暖、偏湿或进入高风险分位的概率多大”。
- 它是后处理与校准,不是完全摆脱上游预报。基础动力或 AI 集合的质量、观测目标和历史回报仍然重要。
- 竞赛成绩不自动等于所有地区都更好。部署前必须按区域、季节、变量和提前期独立检验。
一句话理解 MicroDuet:先保留基础模型对大气演化的预测,再利用历史预报错误校正集合分布,让“发生什么”和“有多大概率”更加可信。
二、为什么未来 2—6 周天气预报这么难?
2.1 初始误差会随时间放大
大气是混沌系统。短中期预报高度依赖初始场,而随着预报时间延长,微小误差会不断增长,单条确定性轨迹逐渐失去可操作意义。
2.2 次季节可预测性来自更慢变化的信号
海温、土壤湿度、平流层过程、热带季节内振荡等可能提供部分可预测性,但其影响随地区、季节和环流背景而变化,不能简单外推历史平均。
2.3 集合成员会存在系统偏差和离散度失真
集合预报本应描述不确定性,但如果成员过于集中、长期偏向某一气候状态,或者不同成员缺乏代表性,即使平均场看似合理,概率仍可能不可靠。
2.4 “准确”必须拆成多个指标
平均误差、距平相关、CRPS、RPSS、可靠性和极端事件命中能力回答的是不同问题。月尺度产品尤其需要同时评估技巧、分辨率、可靠性和经济决策价值,不能只展示一次极端事件案例。
三、核心计算环节与相关算法:从集合输入到可信概率
3.1 数据接入与时空对齐
核心输入:实时集合预报、历史 Hindcast、再分析或观测目标、经纬度/地形/土地覆盖等静态变量、时间与成员元数据。
**关键处理:**GRIB/NetCDF 解码、坐标统一、变量映射、起报时间与预报时效对齐、缺测检查、集合成员维度和气候分区管理。
计算特点:以 CPU、网络、存储和元数据管理为主。数据对齐错误往往比模型参数错误更隐蔽,必须保留来源、版本、下载时间和校验记录。
3.2 PoET:用 Transformer 做集合后处理
**相关算法:**Ensemble Transformer、注意力机制、多变量特征融合、集合成员表示学习,以及面向概率目标的训练。
计算特点:
- 输入不仅包含网格和变量,还可能包含多个集合成员与静态场;
- 成员、变量、气压层和时效增加会放大张量尺寸与显存需求;
- 推理吞吐与数据预处理密切相关,GPU 快并不代表端到端产品一定快;
- 集合后处理的目标不是只优化均值,而是改善整个预测分布。
3.3 PBC:学习历史概率预报中的系统误差
相关算法:概率偏差校正、历史预报—观测配对、分位数/分布校准、集合离散度调整、统计或机器学习回归。
计算特点:
- 训练阶段需要多年历史回报与观测目标,数据读取和样本构造可能占主要工作量;
- 推理阶段以已训练校正器处理新集合,通常比从头训练基础气象模型轻量;
- 校正器可能按变量、区域、季节或预报时效组织,具体以实现为准;
- 必须严格按时间划分训练与验证,避免使用未来信息造成“虚假高分”。
3.4 MicroDuet:组合不同预报信息与后处理优势
MicroDuet 的工程意义在于将动力/混合预报与 PBC 结合,而不是押注单一模型。组合系统需要统一变量、成员、网格和概率表达,并保存每级输出,便于定位改进来自基础模型、集合后处理还是偏差校正。
3.5 概率评价:不能只看一张预报图
常见指标:
- CRPS:评价完整预测分布与观测之间的差异;
- RPSS:相对于参考预报的分级概率技巧;
- 可靠性图:检验预测概率与观测频率是否一致;
- ROC/AUC:评价特定事件的风险区分能力;
- Brier Score:评价二分类事件概率误差;
- 空间与区域指标:评估极端事件位置、范围与行业区域风险。
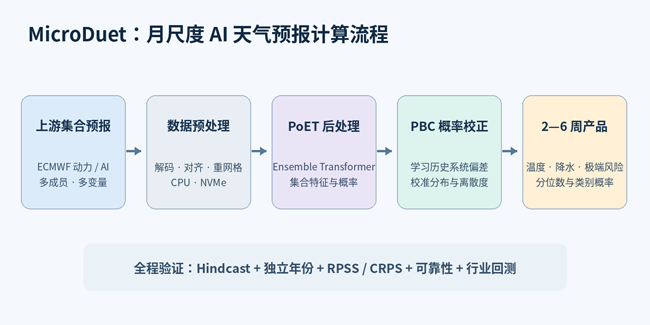
图 1:MicroDuet 类系统的核心不是单点天气生成,而是集合后处理、概率校准与业务验证。
四、AI 推理应用:怎样把模型输出变成可执行产品?
4.1 每周滚动次季节推理
业务平台可按照上游起报周期自动完成:数据下载 → 完整性检查 → 张量预处理 → PoET/PBC 推理 → 分位数和类别概率生成 → 区域聚合 → 图表/API → 归档。
与“跑一次模型”相比,生产系统更关心失败重试、延迟告警、版本追踪和结果一致性。
4.2 极端冷暖与异常降水风险提示
可输出未来不同周次、不同区域的高温、低温、强降水或干旱相关概率。产品应明确阈值定义、参考气候期、空间分辨率和不确定性,不能把“进入历史高分位”改写成确定灾害预警。
4.3 区域降尺度与站点订正
全球次季节产品可结合地形、土地覆盖、站点观测和区域气候特征进行统计降尺度。常用方法包括分位数映射、回归、随机森林、神经网络和偏差订正。降尺度可改善区域适用性,但不会自动创造大尺度模型中不存在的可预测信号。
4.4 多模型融合与业务决策模型
可将 MicroDuet 类输出与其他动力、AI 或统计产品进行融合,再接入作物需水、电力负荷、风光出力、水库调度或灾害风险模型。此时需避免“双重校准”和相关误差被忽略,并通过滚动回测检验真实决策收益。
| AI 推理产品 | 典型输出 | 推荐验收指标 | 不应作出的承诺 |
|---|---|---|---|
| 周尺度温度概率 | 偏暖/偏冷及分位数概率 | RPSS、可靠性、区域回测 | 第 30 天精确气温 |
| 周尺度降水概率 | 偏湿/偏干、累积降水分位 | CRPS、Brier、极端事件检验 | 精确到街道的降雨时间 |
| 极端风险信号 | 高低温、强降水等风险等级 | 命中率、空报率、提前期 | 替代官方预警 |
| 农业管理建议 | 播种、灌溉、防护的时间窗口 | 农艺模型与产量/成本回测 | 脱离土壤和品种的通用建议 |
| 能源风险产品 | 负荷、风光与水电风险情景 | 概率评分、调度成本回测 | 保证收益或零风险调度 |
**业务边界:**AI 次季节预报是风险决策参考,不能替代气象主管机构发布的监测、预报和预警信息。
五、应用场景:提前 2—6 周,哪些行业真正能行动?
5.1 农业:从“看天气”转向种植风险管理
可辅助安排播种与收获窗口、灌溉和排水、施肥计划、霜冻与热害防护、病虫害气象风险准备。决策应同时结合作物品种、生育期、土壤墒情和农艺专家意见。
5.2 电力与新能源:更早准备负荷和供给波动
温度概率可用于负荷情景分析;降水、环流和区域统计可辅助水电来水、风光资源和检修计划研究。对交易和调度而言,应通过成本损失函数与历史滚动回测衡量价值,而不是只看预报相关系数。
5.3 水利与应急管理:为资源预置争取时间
可用于干旱、持续性强降水和寒潮风险的情景准备、物资配置和会商参考。具体人员转移、工程调度和公众预警必须遵守主管部门流程。
5.4 保险与供应链:把概率转化为暴露管理
可服务于农业保险、巨灾风险分析、库存与物流规划。需要把天气概率与资产暴露、脆弱性和历史损失数据结合,避免将气象技巧直接等同于赔付预测精度。
5.5 科研与公共气象服务
可用于集合后处理、概率校准、次季节可预测性研究和多模型比较。科研平台应保留完整 Hindcast、观测目标与代码版本,支持分区域、分季节和分预报时效复现结果。
六、UltraLAB 硬件配置怎么选?按部署深度分四级
以下为配置级别与选型区间建议,不是固定 SKU 或性能承诺。若只调用上游预报 API,本地无需重建全球数值预报;若需要训练基础模型或运行高分辨率 NWP,则应另行设计更高级计算平台。
6.1 方案 A:次季节 AI 推理与产品验证工作站
适合:科研复现、单区域试验、每周滚动推理、概率产品与可视化。
| 部件 | 建议配置思路 | 选择理由 |
|---|---|---|
| CPU | 高主频、多核心工作站级处理器 | 数据解码、重网格、统计与任务调度 |
| 内存 | 128–256 GB ECC 起步 | 容纳集合张量、历史样本与中间副本 |
| GPU | 按模型张量和批量选择显存 | 加速 Transformer 或其他深度后处理 |
| 系统/缓存盘 | 企业级 NVMe SSD | 模型、环境、临时数据与缓存 |
| 活跃数据盘 | 独立大容量 NVMe/SSD | 存放实时预报与近期 Hindcast |
| 归档与备份 | 大容量可靠存储 + 独立副本 | 保存历史回报、目标场和产品版本 |
6.2 方案 B:多变量、多成员业务推理服务器
适合:多区域、多变量、多时效滚动产品,以及科研和业务团队共用。
- GPU:按成员数、变量数、网格、批量和并发测试显存与吞吐;多卡可优先服务独立起报或区域任务。
- CPU:保证数据解码、插值、评价和图像生成不会拖慢 GPU。
- 内存:建议 256 GB–1 TB,根据历史样本构造和并行任务实测;避免 Swap 成为常态。
- 存储:将实时缓存、活跃 Hindcast 和长期归档分层,减少慢速归档盘影响在线推理。
- 网络:按上游数据量和下载窗口配置,关键业务需考虑链路与下载重试。
6.3 方案 C:PBC/PoET 训练与区域模型研发平台
适合:重新训练后处理模型、区域偏差校正、多模型融合和统计/深度降尺度。
| 关键项 | 选型重点 | 验收方式 |
|---|---|---|
| GPU 显存 | 最大训练张量、批量、梯度与优化器状态 | 真实训练批量和混合精度测试 |
| 系统内存 | 样本生成、数据加载与并发实验 | 监测峰值、数据加载和 Swap |
| CPU | 网格处理、样本配对和指标计算 | 检查 GPU 数据等待 |
| NVMe | 高吞吐样本读取、检查点和缓存 | 多 worker 连续读取测试 |
| 实验管理 | 数据版本、模型版本与随机种子 | 同配置复现实验 |
| 调度 | 训练、推理和评价资源隔离 | 多用户并发与失败恢复 |
6.4 方案 D:行业级天气风险服务平台
适合:农业、能源、水利、保险和集团级多部门服务。
建议分为数据接入层、AI 推理层、概率产品层、行业模型层、API/可视化层和备份审计层。上游预报、PBC/PoET 模型、区域参数和参考气候期均需版本化;对关键产品建立延迟、缺测、异常分布和概率漂移告警。
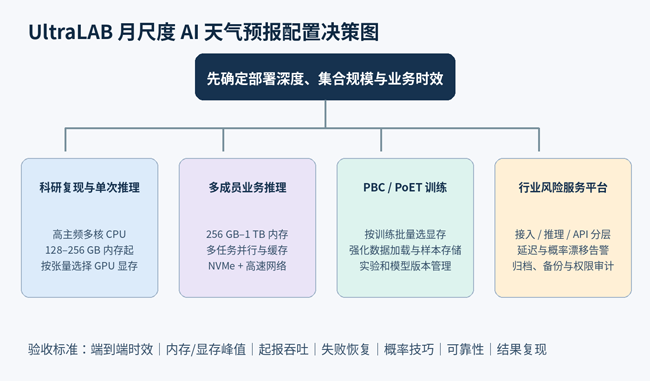
图 2:UltraLAB 配置从部署深度出发,区分轻量推理、业务运行、模型研发与行业平台。
6.5 数据存储比想象中更重要
历史集合回报通常包含成员、变量、层次、网格、起报时间和预报时效等多个维度。容量估算应同时考虑原始数据、统一格式副本、训练样本、缓存、模型检查点、业务产品和备份,避免只按单日文件大小采购。
七、软件清单:从气象数据到概率产品服务
| 软件层级 | 常见组件示例 | 主要用途 |
|---|---|---|
| 操作系统 | Ubuntu LTS、Rocky Linux 等 | 工作站与服务器环境 |
| 气象数据 | ecCodes、CDO、NCO、cfgrib | GRIB/NetCDF 解码、转换与处理 |
| Python 科学生态 | NumPy、Xarray、Dask、Pandas、SciPy | 多维数组、并行与统计 |
| 地球空间 | Cartopy、GeoPandas、Rasterio、GDAL、PyProj | 地图、重投影与区域分析 |
| AI 框架 | PyTorch、CUDA 工具链、ONNX Runtime(按模型) | 训练与推理 |
| 核心模型 | PBC、PoET、MicroDuet 类后处理流程 | 集合后处理与概率校正 |
| 上游数据 | ECMWF 集合/Hindcast、ERA5、站点观测(按授权) | 输入、训练与验证 |
| 概率评价 | properscoring、xskillscore 或定制指标 | CRPS、RPSS、可靠性与回测 |
| 降尺度与统计 | scikit-learn、XGBoost、分位数映射工具 | 区域/站点订正与融合 |
| 流程调度 | Slurm、Airflow、Prefect、Cron(按规模) | 滚动任务、重试与依赖管理 |
| 环境复现 | Conda/Mamba、Apptainer、Docker(按策略) | 依赖隔离和部署 |
| 数据与模型版本 | Git、DVC、MLflow、对象存储元数据 | 实验、数据与模型追踪 |
| 产品服务 | FastAPI、PostgreSQL/PostGIS、缓存服务 | 查询、API 与区域统计 |
| 可视化 | Matplotlib、Cartopy、交互式地图组件 | 概率图、时间序列和可靠性图 |
| 运维保障 | 监控告警、日志、快照与备份工具 | 时效、稳定与数据恢复 |
PBC、PoET 与 MicroDuet 的可用代码、权重、接口和许可证应以作者或项目正式发布为准。若未公开完整实现,不应将自行复刻版本宣称为官方模型;业务部署还需核对上游数据和再分析产品的使用条款。
八、常见问题:AI 天气预报硬件配置与性能分析
Q1:MicroDuet 能准确预测下个月某一天的天气吗?
不能这样理解。其主要价值是未来 2—6 周概率预报和风险信号,适合评估某周偏暖、偏湿或极端风险概率,而非给出第 30 天精确逐小时天气。
Q2:本地运行 MicroDuet 是否必须自建超级计算机?
若使用上游动力/AI 集合并执行后处理,通常不需要从零运行完整全球 NWP;但训练、海量 Hindcast、区域高分辨率产品或多用户服务仍需匹配 GPU、内存和存储。具体以公开实现和业务规模为准。
Q3:AI 推理只需要一小块显存,为什么还要大系统内存?
集合数据在解码、重网格、样本构造和区域统计时可能产生多份中间数组;历史回报处理和多任务并发也会占用大量内存。显存小不代表端到端数据管线轻量。
Q4:GPU 利用率不高,预报产品仍出得慢,问题在哪里?
常见原因包括数据下载、GRIB 解码、重网格、慢速磁盘、单线程指标计算或频繁小批量推理。应分段记录接入、预处理、推理、后处理和绘图耗时。
Q5:多 GPU 能否让每次起报成倍加速?
不一定。若单任务不能有效跨卡,多卡更适合并行处理不同起报、变量、区域或集合批次。应以业务吞吐和时效而非理论线性加速验收。
Q6:为什么历史 Hindcast 存储比实时数据更占空间?
业务训练与校准需要覆盖多年、多成员、多变量和多起报时间,且常保留原始、标准化和训练样本副本。应按完整数据生命周期估算容量。
Q7:NVMe 已足够快,为什么训练仍等待数据?
可能是小文件过多、数据加载 worker 不足、预处理串行、压缩解码开销或样本格式不适合批量读取。可优化分块、缓存、并行加载与训练样本布局。
Q8:增加集合成员是否一定提高产品可靠性?
不一定。成员数量、代表性和校准共同决定概率质量。更多成员也会增加显存、内存、存储与推理成本,应通过概率评分和可靠性评估收益。
Q9:统计降尺度需要高端 GPU 吗?
分位数映射和传统回归通常以 CPU 为主;深度降尺度和高分辨率模型可使用 GPU。选择硬件前应先明确输出分辨率、区域大小和模型类型。
Q10:PBC 回测分数很高,是否就能直接业务上线?
不能。还需排除时间泄漏,进行独立年份和滚动实时验证,并按区域、季节、变量与提前期检查可靠性、极端事件和失败案例。
Q11:模型训练完成后,是否不需要再更新?
上游模型、观测目标、数据格式和气候分布都可能变化。应建立漂移监控和定期再校准机制,但更新必须保留版本和独立验证,避免无记录地替换业务模型。
Q12:UltraLAB 平台如何做业务验收?
使用真实上游数据与完整业务周期,测量下载成功率、端到端延迟、GPU/内存峰值、存储增长、并发吞吐、失败重试、结果复现和独立回测指标,而非只做单次模型推理演示。
九、采购与上线前,请确认这 12 项参数
- 部署范围:调用上游产品、仅做 PBC/PoET,还是训练区域模型;
- 预报变量:温度、降水、气压、风及所需气压层;
- 空间范围:全球、全国、区域或站点,以及目标分辨率;
- 集合规模:成员数、起报频率、预报时效与时间步长;
- **历史数据:**Hindcast 年数、再分析/观测目标和数据授权;
- 模型信息:代码、权重、精度、框架、许可证和接口;
- 业务时效:上游数据到达后多久必须生成产品;
- 用户并发:内部研究、批量业务还是对外 API;
- 行业输出:分位数、类别概率、极端风险或决策情景;
- 数据治理:保存周期、版本、审计、备份与恢复目标;
- 验证方案:参考预报、独立年份、区域季节和概率指标;
- **扩展计划:**GPU、内存、NVMe、容量存储与网络扩展空间。
UltraLAB 配置建议:提供上述参数和一段真实起报流程,可将“AI 天气模型需要什么服务器”转化为可验证的 GPU 显存、CPU、内存、NVMe、网络和归档存储组合。先保证数据链路和概率产品质量,再优化推理速度与并发,让硬件投入服务于行业决策时效。
结语:提前一个月的真正价值,是让概率更早进入决策
MicroDuet 与 PBC 展示的方向,不是让 AI 消灭天气的不确定性,而是更好地识别和校准不确定性。对农业、能源、水利、应急和保险而言,未来 2—6 周更可靠的概率信号,意味着更充足的准备时间和更精细的资源安排。
对专业团队而言,更合理的 UltraLAB 平台应做到:上游数据接得稳、历史回报管得好、AI 推理跑得快、概率产品可验证、业务结果可追溯。月尺度 AI 天气预报的核心竞争力,是模型、数据、评价与行业决策的完整闭环。
参考资料与使用说明
- Microsoft Research,2026-10-19:New AI framework bridges a critical gap in mid-range weather forecasts。介绍 MicroDuet、PBC、PoET、AI Weather Quest 表现及提前 19—26 天风险案例。
- 研究论文预印本:Enhancing AI and Dynamical Subseasonal Forecasts with Probabilistic Bias Correction。介绍 PBC 方法、AIFS 与动力模型次季节技巧改进和竞赛结果。
- ECMWF AI Weather Quest 会议材料:相关 Poster。包含 PoET、PBC、Hindcast 与集合推理设置等资料。
使用说明:公开结果对应特定变量、地区、时段、参考预报和评价体系,不代表所有区域与所有事件均有相同改进。本文硬件区间为通用工程建议,实际配置以公开实现、数据授权和真实业务测试为准。AI 次季节产品不能替代官方气象预报预警,也不应作为高风险决策的唯一依据。
主题标签:#AI天气预报 #MicroDuet #PBC #次季节预报 #集合预报 #AI推理 #智慧农业 #能源气象 #UltraLAB


