






文章目录
一、三台机器核心规格对齐
二、三大计算领域应用分析
三、核心算法与计算特点解析
四、利弊对比与选型决策矩阵
五、软件生态清单
六、大模型本地部署完整指南
七、常见问题与硬件配置分析
八、总结与展望
引言:四万块,买一台能跑大模型的桌面机器,怎么选?
如果现在让你花四五万块,买一台能跑大模型的桌面机器,你会怎么选?
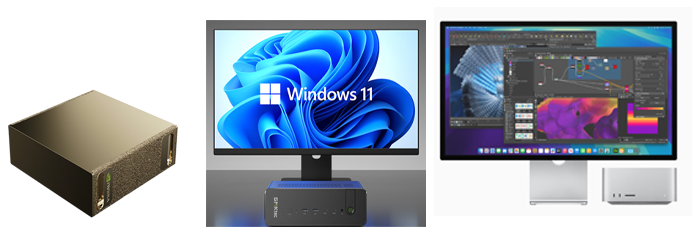
最近这个问题变得越来越难答。原因很简单:过去本地跑大模型,基本只有"装个独显 workstation"这一条路;而现在,NVIDIA、AMD、苹果三条技术路线同时杀到了同一个价位和同一个桌面上,它们的名字分别是:
- DGX Spark -- CUDA生态 + 200Gb/s互联
- 极摩客 EVO-X5 Pro -- 192GB内存 + 160GB可作显存
- Mac Studio M5 Max -- 614GB/s内存带宽
它们的宣传语听起来都很有道理:一个说我有CUDA和一千万亿次算力,一个说我有192GB内存能离线跑320B大模型,一个说我有每秒614GB的内存带宽。但真要把钱花出去,你很快会发现这三台机器根本不是同一个物种 -- 它们只是碰巧大小差不多、内存差不多,就都被摆进了"桌面AI主机"这个筐里。
这篇我们就来把它们掰开对齐:规格对规格,长板对短板,场景对场景。看完你应该能清楚知道自己该掏哪台的钱。
一、三台机器的底牌:核心规格逐项对齐
| 对比项 | NVIDIA DGX Spark | 极摩客 EVO-X5 Pro | Mac Studio M5 Max |
|---|---|---|---|
| 芯片平台 | GB10 Grace Blackwell | 锐龙 AI Max+ PRO 495 | Apple M5 Max |
| CPU | 20核Arm(10x Cortex-X925 + 10x Cortex-A725) | 16核32线程 Zen5(最高5.2GHz) | 18核CPU(6超能核+12性能核) |
| GPU | Blackwell架构GPU(第五代Tensor Core) | RDNA 3.5集成GPU + XDNA 2 NPU(55 TOPS) | 40核GPU + 16核神经网络引擎 |
| 内存配置 | 128GB LPDDR5x 统一内存 | 192GB LPDDR5X(160GB可作显存) | 128GB统一内存(焊死不可升级) |
| 内存带宽 | 273 GB/s | 约273 GB/s | 最高614 GB/s |
| AI算力 | 最高1 PFLOP FP4(稀疏) | NPU 55 TOPS + RDNA3.5集显 | 16核神经网络引擎(未公开峰值) |
| 存储 | 4TB NVMe M.2自加密 | 3x M.2 PCIe4.0,最高24TB | 1TB SSD(按配置锁死) |
| 关键扩展 | 2x QSFP ConnectX-7 200Gb/s互联 | 2x USB4 V2 80Gbps / 四屏8K / DASH | 4x 雷雳5 120Gb/s / 最多5屏 / SDXC |
| 尺寸/重量 | 150x150x50.5mm / 1.2kg | 桌面主机 | 197x197x95mm / 约2.7kg |
| 参考价格 | 约4万元档(渠道浮动) | 192GB+4TB首发49999元 | 128GB+1TB国行46999元 |
关键洞察:三台的内存(128GB、192GB、128GB)和带宽(273、273、614 GB/s)完全不是一个比例关系。极摩客赢在容量,苹果赢在带宽,NVIDIA赢在算力和互联。
二、三大计算领域应用分析
2.1 科学计算场景
科学计算涵盖计算物理、计算化学、天体物理模拟、气候建模等领域,对浮点运算能力和多机互联带宽有极高要求。
DGX Spark 在科学计算中的优势:
- CUDA生态:NVIDIA全套AI软件栈预装(NIM、CUDA、JupyterLab、Docker),从原型到部署路径最顺
- 多机互联:两台机器通过QSFP直连组成256GB小集群,可模拟更大内存规模
- FP4精度:1 PFLOP FP4稀疏算力,适合大规模科学模拟的混合精度训练
适用科学计算任务:
| 任务类型 | 代表软件/框架 | DGX Spark | EVO-X5 Pro | Mac Studio M5 Max |
|---|---|---|---|---|
| 分子动力学模拟 | GROMACS、LAMMPS | 优秀(GPU加速) | 良好(CPU并行) | 一般 |
| 计算流体力学 | OpenFOAM | 优秀(GPU加速) | 优秀(CPU并行) | 一般 |
| 量子化学计算 | Gaussian、ORCA GPU版 | 优秀 | 良好 | 有限 |
| 气候/天体模拟 | RAMSES、ENZO | 优秀(多机集群) | 良好 | 有限 |
| 有限元分析 | Abaqus、ANSYS | 有限 | 优秀(原生x86) | 不兼容 |
极摩客 EVO-X5 Pro 在科学计算中的表现:
- x86架构 + Windows/Linux双支持,现有科学计算软件几乎都能直接跑
- 192GB大内存可装载超大规模科学数据集
- 三个M.2插槽最高24TB扩展,适合海量科学数据存储
Mac Studio M5 Max 在科学计算中的表现:
- 614GB/s带宽在生成阶段(如模拟结果可视化渲染)优势明显
- macOS上MLX框架对部分AI辅助科学计算有优化
- 安静散热适合实验室长期运行
2.2 仿真计算场景
仿真计算包括CAE工程仿真、数字孪生、有限元分析、系统仿真等,对内存容量和多任务并发有强需求。
仿真计算核心需求分析:
| 需求维度 | 要求说明 | 最优选择 |
|---|---|---|
| 内存容量 | 大型有限元模型需百GB级内存 | 极摩客EVO-X5 Pro(192GB) |
| 多任务并发 | 同时运行多个仿真工况 | 极摩客EVO-X5 Pro(x86多核优势) |
| 数据I/O | 大规模网格文件读写 | 极摩客EVO-X5 Pro(24TB扩展) |
| 可视化渲染 | 仿真结果后处理渲染 | Mac Studio M5 Max(614GB/s带宽) |
| 集群扩展 | 分布式仿真加速 | DGX Spark(200Gb/s互联) |
各平台仿真软件兼容性:
| 仿真软件 | DGX Spark | EVO-X5 Pro | Mac Studio M5 Max |
|---|---|---|---|
| ANSYS | 有限(Arm版) | 原生支持 | 不兼容 |
| COMSOL | Linux版可用 | 原生支持 | 不兼容 |
| Abaqus | Linux版可用 | 原生支持 | 不兼容 |
| OpenFOAM | GPU加速优秀 | CPU并行优秀 | 有限支持 |
| MATLAB/Simulink | 支持 | 完美支持 | 原生支持 |
| SolidWorks | 有限 | 原生支持 | 不兼容 |
2.3 生命科学计算场景
生命科学计算涵盖基因组学分析、蛋白质结构预测、药物筛选、医学影像AI等,是AI算力需求增长最快的领域之一。
生命科学计算核心算法分析:
| 算法类别 | 代表算法/工具 | 算力需求特征 | 推荐平台 |
|---|---|---|---|
| 基因组序列比对 | BWA、Bowtie2、Minimap2 | CPU多核+大内存 | EVO-X5 Pro |
| 蛋白质结构预测 | AlphaFold2、RoseTTAFold | GPU大显存+高带宽 | DGX Spark / M5 Max |
| 分子对接筛选 | AutoDock、Glide | GPU并行计算 | DGX Spark |
| 医学影像AI | nnU-Net、MONAI | GPU训练+推理 | DGX Spark |
| 单细胞分析 | Scanpy、Seurat | CPU+内存密集型 | EVO-X5 Pro |
| 药物分子生成 | DiffDock、AtomNet | GPU推理+生成 | M5 Max(带宽优势) |
生命科学场景选型建议:
- 基因组学/生物信息流:极摩客EVO-X5 Pro(大内存 + x86兼容 + 多存储)
- AI药物发现/蛋白质设计:DGX Spark(CUDA生态 + GPU算力)
- 医学影像分析+可视化:Mac Studio M5 Max(高带宽 + 专业显示)
三、核心算法与计算特点深度解析
3.1 三大平台核心算法栈对比
| 算法领域 | DGX Spark(CUDA生态) | EVO-X5 Pro(x86+ROCm) | Mac Studio M5 Max(MLX/Apple Silicon) |
|---|---|---|---|
| 深度学习训练 | PyTorch+CUDA(生态最成熟) | PyTorch+ROCm(社区适配中) | PyTorch+MLX(苹果生态优化) |
| 大模型推理 | TensorRT-LLM、vLLM | llama.cpp、Ollama | MLX框架、llama.cpp |
| 科学计算加速 | cuBLAS、cuFFT、cuSPARSE | rocBLAS、rocFFT | Accelerate框架、MLX |
| 量子计算模拟 | Qiskit+CUDA | Qiskit(CPU模拟) | 有限支持 |
| 图神经网络 | DGL、PyG(CUDA优化) | 有限支持 | 基础支持 |
| 强化学习 | Ray RLlib、Stable Baselines | CPU并行可行 | 轻量级可行 |
3.2 计算特点深度分析
DGX Spark -- "生态最强,脾气最大"
- 优势:CUDA生态是真正做AI研发的基本配置;200Gb/s互联支持多机集群;从桌面原型到数据中心部署路径现成
- 劣势:Arm+Linux生态中Windows软件和x86专属工具链走不通;20核Arm CPU日常桌面性能不突出;遇到未适配Arm64的软件只能认栽
- 计算特点:峰值算力最强,适合GPU密集型训练和推理任务
极摩客 EVO-X5 Pro -- "最能装,也最老实"
- 优势:192GB内存+160GB可分配显存,价位唯一;x86架构+Win/Linux双支持;三个M.2插槽最高24TB;USB4 V2外接显卡坞;AMD DASH远程带外管理
- 劣势:RDNA 3.5集显AI算力偏弱;推理吞吐量跟不上CUDA;AI生态依赖ROCm和社区适配,调试成本高
- 计算特点:内存容量最大,适合大数据装载和离线合规场景
Mac Studio M5 Max -- "最安静,也最挑人"
- 优势:614GB/s带宽三台唯一双倍以上优势;雷雳5+SDXC+5屏+ProRes媒体引擎;安静散热;统一内存架构高效
- 劣势:内存焊死不可升级;存储按配置锁死;AI训练微调生态不如CUDA;硬件无后期扩展空间
- 计算特点:带宽最强,适合token生成密集型任务和创意工作流
四、利弊对比与选型决策矩阵
4.1 三维能力对比
| 能力维度 | DGX Spark | EVO-X5 Pro | Mac Studio M5 Max |
|---|---|---|---|
| 算力峰值 | 优秀(1 PFLOP FP4) | 一般(NPU 55 TOPS) | 一般(未公开) |
| 内存容量 | 良好(128GB) | 优秀(192GB) | 良好(128GB) |
| 内存带宽 | 一般(273GB/s) | 一般(273GB/s) | 优秀(614GB/s) |
| 生态成熟度 | 优秀(CUDA全家桶) | 良好(x86万能兼容) | 良好(苹果生态) |
| 扩展能力 | 良好(QSFP互联) | 优秀(多插槽) | 一般(焊死) |
| 日常可用性 | 一般(Arm限制) | 优秀(x86全能) | 优秀(macOS体验) |
4.2 场景-平台匹配矩阵
| 应用场景 | 推荐平台 | 核心理由 | 备选方案 |
|---|---|---|---|
| AI研发/模型微调/多机实验 | DGX Spark | CUDA生态+200Gb/s互联 | -- |
| 企业私有化AI/政企算力节点 | EVO-X5 Pro | 数据本地闭环+x86兼容+DASH管理 | -- |
| 金融机构数据安全节点 | EVO-X5 Pro | 离线合规+大内存+Windows兼容 | -- |
| 离线AI教育实验室/高校机房 | EVO-X5 Pro | 部署门槛低+多人复用+大容量 | DGX Spark |
| 影视后期/内容创作+本地AI | Mac Studio M5 Max | 614GB/s带宽+专业创作生态 | -- |
| 基因组学/生物信息分析 | EVO-X5 Pro | 大内存+多存储+x86兼容 | DGX Spark |
| AI药物发现/蛋白质设计 | DGX Spark | CUDA+GPU算力+科学计算栈 | M5 Max |
| 医学影像AI+可视化 | Mac Studio M5 Max | 高带宽+多屏+专业显示 | DGX Spark |
| CAE工程仿真 | EVO-X5 Pro | ANSYS/COMSOL/Abaqus原生支持 | -- |
| 气候/天体物理模拟 | DGX Spark | 多机集群+GPU并行 | EVO-X5 Pro |
4.3 一句话决策
要「容量」且必须兼容现有Windows业务系统 -- 选 极摩客 EVO-X5 Pro(192GB+4TB,首发约49999元)
要「生态」做真AI研发、以后还要扩展成小集群 -- 选 DGX Spark(128GB+4TB,渠道约四万元档)
要「带宽」本身就是苹果生态重度创作者,想顺手跑本地模型 -- 选 Mac Studio M5 Max(128GB+1TB,国行46999元)
极摩客给的是容量,DGX Spark给的是生态,Mac Studio给的是带宽。搞清楚你缺哪一个,这四万块钱就不会花错地方。
五、软件生态清单
5.1 三大平台软件兼容性总表
| 软件类别 | 软件名称 | DGX Spark | EVO-X5 Pro | Mac Studio M5 Max |
|---|---|---|---|---|
| AI框架 | PyTorch | CUDA版 | CPU/ROCm | MLX优化版 |
| TensorFlow | CUDA版 | 有限支持 | 基础支持 | |
| JAX | 支持 | CPU版 | MLX替代 | |
| 大模型工具 | Ollama | Arm版可用 | 一键安装 | 原生支持 |
| llama.cpp | 支持 | 支持 | 原生优化 | |
| vLLM | 原生支持 | 不支持 | 不支持 | |
| LangChain | 支持 | 支持 | 支持 | |
| 科学计算 | MATLAB | Arm版有限 | 原生支持 | 原生支持 |
| OpenFOAM | GPU加速 | CPU并行 | 有限 | |
| GROMACS | GPU加速 | CPU版 | 有限 | |
| 工程仿真 | ANSYS | 有限 | 原生支持 | 不兼容 |
| COMSOL | Linux版 | 原生支持 | 不兼容 | |
| Abaqus | Linux版 | 原生支持 | 不兼容 | |
| 开发工具 | Docker | 原生 | 原生 | 原生(Rosetta) |
| VS Code | 支持 | 支持 | 支持 | |
| JupyterLab | 预装 | 支持 | 支持 | |
| 内容创作 | Final Cut Pro | 不兼容 | 不兼容 | 原生 |
| DaVinci Resolve | 有限 | 有限 | 原生优化 | |
| Adobe CC | Arm版 | 原生支持 | 原生支持 |
5.2 推荐软件安装清单
DGX Spark 推荐安装:
# 基础AI栈
dgx-cli setup
# 安装NIM微服务
docker run --gpus all nvcr.io/nim/meta/llama-3.1-8b-instruct
# 开发环境
pip install jupyterlab langchain transformers
# 科学计算
pip install cupy cuda-toolkit
EVO-X5 Pro 推荐安装:
# Windows环境
# 安装AMD GPU驱动 + ROCm(Linux子系统)
# Python环境
pip install ollama llama-cpp-python
# 仿真软件
# ANSYS / COMSOL / Abaqus 直接安装
Mac Studio M5 Max 推荐安装:
# 安装MLX框架
pip install mlx mlx-lm
# 大模型推理
brew install ollama
ollama pull llama3.1
# 开发环境
pip install jupyterlab langchain
# 科学计算
pip install numpy scipy pandas
六、大模型本地部署完整指南
6.1 部署方案对比
| 部署方案 | DGX Spark | EVO-X5 Pro | Mac Studio M5 Max |
|---|---|---|---|
| Ollama部署 | Arm版可用 | 一键安装 | 原生支持 |
| vLLM部署 | 原生支持(最佳) | 不支持 | 不支持 |
| TensorRT-LLM | 原生支持 | 不支持 | 不支持 |
| llama.cpp | 支持 | 支持 | 原生优化 |
| MLX框架 | 不支持 | 不支持 | 原生支持 |
| Docker容器 | 原生 | 原生 | Rosetta转译 |
| 量化部署 | FP4/FP8/INT8 | INT4/INT8 | INT4/FP8 |
6.2 大模型本地部署步骤(以Ollama为例)
步骤一:环境准备
# DGX Spark(Arm Linux)
curl -fsSL https://ollama.com/install.sh | sh

# EVO-X5 Pro(Windows/Linux)
# Windows:下载安装包直接安装
# Linux:curl -fsSL https://ollama.com/install.sh | sh

# Mac Studio M5 Max
brew install ollama
ollama serve
步骤二:拉取模型
# 轻量模型(<7B参数,三台均可流畅运行)
ollama pull llama3.2

# 中等模型(7B-13B参数)
ollama pull mistral

# 大型模型(70B+参数,推荐EVO-X5 Pro或DGX Spark)
ollama pull llama3.1:70b
步骤三:推理测试
# 交互式对话
ollama run llama3.2

# API服务启动
ollama serve --host 0.0.0.0

# 测试推理速度
python -c "
import requests
import time
start = time.time()
resp = requests.post('http://localhost:11434/api/generate',
    json={'model':'llama3.2','prompt':'请简述量子计算原理','stream':False})
elapsed = time.time() - start
print(f'TTFT: {resp.json().get("total_duration",0)/1e9:.2f}s')
print(f'生成速度: {resp.json().get("eval_count",0)/elapsed:.2f} tokens/s')
"
步骤四:性能调优建议
| 调优维度 | DGX Spark | EVO-X5 Pro | Mac Studio M5 Max |
|---|---|---|---|
| 量化策略 | FP4稀疏量化(极致压缩) | INT4量化 | MLX INT4量化 |
| 批处理大小 | 根据显存调整(最大256) | 根据内存调整(最大512) | 根据统一内存调整 |
| 上下文长度 | 8K-32K | 32K-128K(大内存优势) | 8K-32K |
| 并发请求 | 支持(vLLM推理服务器) | 有限(单用户为主) | 有限(单用户为主) |
| 多模型加载 | 需多机互联 | 大内存可多模型切换 | 128GB有限 |
6.3 各平台可运行最大模型参考
| 模型规模 | DGX Spark | EVO-X5 Pro | Mac Studio M5 Max |
|---|---|---|---|
| 7B参数 | 流畅推理(>100 tok/s) | 流畅推理 | 流畅推理 |
| 13B参数 | 流畅推理 | 流畅推理 | 流畅推理 |
| 34B参数 | 流畅推理 | 流畅推理 | 较慢 |
| 70B参数 | 量化后推理 | INT4推理(大内存) | 较慢 |
| 200B参数 | 需量化+优化 | 4-bit量化可运行 | 超出内存 |
| 320B参数 | 单机不足 | 4-bit量化离线运行 | 超出内存 |
注意:实际可运行规模受量化方案、模型结构、上下文长度、微调方法影响,采购前建议用自有模型实测。
七、常见问题与硬件配置分析
7.1 常见问题诊断表
| 问题现象 | 可能原因 | DGX Spark排查 | EVO-X5 Pro排查 | Mac Studio排查 |
|---|---|---|---|---|
| 大模型加载失败/OOM | 内存/显存不足 | 检查统一内存使用:dgx-cli memory | 检查LPDDR5X使用 | 检查统一内存监控 |
| 推理速度缓慢 | 带宽瓶颈/量化不当 | 检查CUDA版本兼容性 | 检查ROCm适配状态 | 检查MLX优化版本 |
| Arm架构软件不兼容 | 软件未适配Arm64 | 检查容器Arm镜像 | 不适用(x86) | 检查Rosetta转译 |
| 多机互联不稳定 | QSFP线缆/网络配置 | 检查ConnectX-7驱动 | 不支持原生互联 | 不支持 |
| 散热噪音大 | 负载过高/散热策略 | 检查DGX OS温控策略 | 检查风扇曲线设置 | 正常(被动散热为主) |
| 存储扩容困难 | 插槽/接口限制 | 单M.2插槽 | 三M.2插槽可扩至24TB | 存储焊死不可升级 |
| AI生态缺失 | 框架/库未适配 | 检查NIM微服务状态 | 检查ROCm社区支持 | 检查MLX模型移植 |
| Windows软件不兼容 | Arm架构限制 | 无Windows支持 | 原生Windows支持 | macOS-only |
7.2 硬件配置推荐方案
方案A:AI研发极致方案(DGX Spark)
| 配置项 | 推荐规格 | 说明 |
|---|---|---|
| 主机 | DGX Spark 128GB+4TB | 核心计算平台 |
| 网络 | 2x QSFP 200Gb/s互联线缆 | 多机扩展必备 |
| 显示器 | 2x 4K显示器(DP输出) | Arm Linux驱动适配 |
| 外设 | USB-C扩展坞 | 补充接口 |
| 预估总价 | 约4万元 | 渠道价浮动,购前确认实时报价 |
方案B:企业私有化全能方案(极摩客 EVO-X5 Pro)
| 配置项 | 推荐规格 | 说明 |
|---|---|---|
| 主机 | EVO-X5 Pro 192GB+4TB | 大内存+大容量 |
| 存储扩展 | 额外2x 8TB M.2 SSD | 总存储达20TB |
| 显示器 | 2x 4K显示器(USB4扩展) | 四屏8K支持 |
| 外设 | USB4显卡坞(可选) | 额外GPU加速 |
| 预估总价 | 约5.5万元 | 含扩展存储 |
方案C:创作+AI一体化方案(Mac Studio M5 Max)
| 配置项 | 推荐规格 | 说明 |
|---|---|---|
| 主机 | Mac Studio M5 Max 128GB+1TB | 核心平台 |
| 存储扩展 | Thunderbolt SSD 4TB | 高速外接存储 |
| 显示器 | 2x 6K Pro Display XDR | 发挥多屏优势 |
| 外设 | 雷雳扩展坞 | 补充接口 |
| 预估总价 | 约6万元 | 含外接存储和显示器 |
7.3 采购决策 Checklist
- 明确核心场景:研发训练 vs 推理部署 vs 仿真计算 vs 内容创作
- 确认软件兼容性:现有业务软件是否支持Arm/x86/macOS
- 评估模型规模:自有模型参数量+量化方式+上下文长度需求
- 检查扩展需求:存储扩容、多机互联、外接GPU等
- 核算总拥有成本:主机+扩展+能耗+运维,而非仅看裸机价格
- 实测验证:拿自有模型和数据进行POC测试,勿只看参数
八、总结与展望
8.1 核心结论
| 维度 | 胜出者 | 关键理由 |
|---|---|---|
| AI研发与生态 | DGX Spark | CUDA生态不可替代,200Gb/s互联支持集群扩展 |
| 内存容量与兼容性 | EVO-X5 Pro | 192GB+24TB+Windows兼容,企业私有化首选 |
| 内存带宽与创作 | Mac Studio M5 Max | 614GB/s带宽+专业创作生态,安静省心 |
| 性价比(纯算力) | DGX Spark | 四万元档拿到PFLOP级算力 |
| 性价比(全能型) | EVO-X5 Pro | 49999元拿到192GB+4TB+x86全兼容 |
| 性价比(体验型) | Mac Studio M5 Max | 46999元一台专业创作+AI一体机 |
8.2 行业趋势展望
- 2026-2027年:桌面AI超算将从"极客玩具"走向"企业标配",私有化部署需求持续爆发
- Arm架构崛起:DGX Spark的Grace架构预示着Arm在AI基础设施领域的野心,但生态迁移仍需时间
- 统一内存架构:苹果验证了UMA在AI推理中的价值,未来NVIDIA/AMD可能跟进
- 带宽为王:随着模型参数持续增长,内存带宽将成为比算力更重要的瓶颈
8.3 最终建议
极摩客给的是"容量",DGX Spark给的是"生态",Mac Studio给的是"带宽"。
搞清楚你缺哪一个,这四万块钱就不会花错地方。
声明:本文数据基于2026年10月公开信息整理,价格与参数可能因渠道和版本浮动,采购前请以实时报价和官方文档为准。本文不构成任何投资建议,硬件选型请结合实际业务需求进行POC测试。
参考资料:新网景科技《128GB、192GB、614GB/s:三台桌面AI超算横评,谁才是你桌上那台?》


