






摘要:本文解读 NVIDIA 的 Megatron-LM 模型并行论文(arXiv:1909.08053)及其后续 PTD-P 工作(arXiv:2104.04473),梳理层内张量并行、层间流水线并行与数据并行的组合机制及其通信特征,分析该负载对 GPU 显存、GPU 间互连带宽和 CPU/存储配套的要求,并给出 UltraLAB 图形工作站的入门、主流与高性能分档选型建议。
适用读者:大模型预训练/微调工程师、AI for Science 研究人员、需要为多 GPU 训练环境做硬件规划的高校与企业实验室。
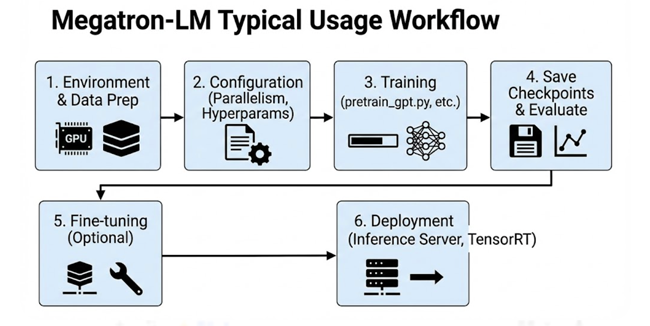
一、资料背景与核心观点
- 资料名称 1:《Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism》(Shoeybi 等,NVIDIA,arXiv:1909.08053)
- 资料名称 2:《Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM》(Narayanan 等,arXiv:2104.04473,常称 PTD-P 论文)
- 发布机构:NVIDIA(第一作者单位)
- 原文链接:https://arxiv.org/abs/1909.08053 ;https://arxiv.org/abs/2104.04473 ;代码:https://github.com/NVIDIA/Megatron-LM
核心观点:当 Transformer 模型参数量超出单张 GPU 显存时,必须对模型本身进行切分。第一篇论文提出层内张量并行:将自注意力层的 Q/K/V 投影矩阵按列切分、输出投影按行切分,MLP 的两个 GEMM 分别按列、按行切分,配合 f/g 共轭算子,使每个 Transformer 层在前向和反向各只需两次 All-Reduce,最终在 512 张 V100 上以 76% 扩展效率训练 8.3B 参数模型。第二篇论文进一步把张量并行(Tensor Parallelism)、流水线并行(Pipeline Parallelism)与数据并行(Data Parallelism)组合为 PTD-P 三维并行,在 3072 张 A100 上训练万亿参数级模型,说明单机多卡与跨机扩展需要不同的并行度配比。
二、主要功能模块与核心算法
- 张量并行(TP):切分单层内的矩阵乘。注意力头按列并行分配,后续线性层按行并行,消除中间同步点;每层仅前向两次、反向两次 All-Reduce。
- 流水线并行(PP):按层把模型切到不同设备,micro-batch 流水调度;PTD-P 论文引入交错式(interleaved)1F1B 调度以降低流水线气泡。
- 数据并行(DP):在每个 TP×PP 副本之间做梯度 All-Reduce,可与分布式优化器(切分优化器状态)组合降低显存占用。
- 混合精度与激活重计算:FP16/BF16 混合精度配合动态损失缩放;激活检查点(activation checkpointing)以算力换显存。
- 集合通信:All-Reduce(DP 梯度、TP 层内)与 P2P(PP 相邻阶段)由 NCCL 承载;TP 通信最频繁,对 GPU 间带宽最敏感。
原文未提供面向单工作站场景的基准数据,论文实验均在集群上完成,本文对工作站场景的建议为基于其通信机制的推导。
三、计算特点与性能瓶颈
- 计算特征:GEMM 密集型,混合精度下充分利用 Tensor Core;属于典型的计算密集 + 通信密集混合负载。
- 显存:权重、梯度、优化器状态与激活共同决定显存下限。张量并行的首要动机就是单卡显存不足;TP 组内各卡显存占用近似均分。
- 互连带宽:TP 的 All-Reduce 发生在每一层,频率远高于 DP;在多 GPU 单机上,若 GPU 间只有 PCIe 互连,TP 通信会迅速成为瓶颈,因此 TP 组应优先放在 NVLink/NVSwitch 域内。
- CPU 与 I/O:数据加载与预处理需要足够 CPU 核心与内存;检查点体积巨大(数十 GB 至 TB 级),需要高吞吐 NVMe 存储以避免训练停顿。
- 扩展规律:论文的实测表明,模型并行用于"加速小模型"时收益递减——1.2B 模型在固定 batch 下从 1 卡扩到 8 卡仅获得约 3 倍加速,通信开销随每卡计算量下降而凸显。这一结论对工作站选型有直接意义:并行度应服从显存需求,而非盲目堆卡。
四、典型应用场景
- 高校/企业实验室的十亿至百亿参数级模型预训练或小规模继续预训练:单机 4—8 张高显存 GPU,TP 置于机内 NVLink 域。
- 垂直领域大模型全参数微调:7B—70B 量级,显存决定最小 GPU 配置,batch 与序列长度决定是否需要激活重计算。
- 多模态与科学基础模型研究:视觉—语言联合训练对显存和 I/O 的压力进一步放大。
- 训练框架与并行策略研究:Megatron-LM 源码级二次开发,需要交互式调试环境。
五、UltraLAB 硬件配置建议
以下分档依据张量并行/流水线并行的通信特征与显存需求推导,不含价格与性能承诺;GPU 型号与互联能力需在采购前与 UltraLAB 工程师核实当前可选配置。
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 系统盘/项目盘/数据盘 | 散热/电源/扩展性 | 适用场景 |
|---|---|---|---|---|---|---|
| 入门(算法验证) | 单路高主频 16—24 核(如 Intel Xeon W / AMD Threadripper 级),保证数据加载与编译吞吐 | 128—256 GB ECC | 1—2 张 48 GB 级专业/高端 GPU,TP=2 时优先确认双卡互联方案 | 2 TB NVMe 系统盘 + 4 TB NVMe 数据盘 | 风冷/液冷机箱,≥1600 W 冗余电源,预留双槽位 | 7B 级全参数微调、Megatron 源码调试与并行策略学习 |
| 主流(课题组主力) | 单路 32—64 核,内存通道数满配以保障 dataloader 带宽 | 512 GB—1 TB ECC | 4 张 48—80 GB 级 GPU,优先选择支持 NVLink 互连的配置,机内 TP≤4 | 2 TB NVMe 系统盘 + 8 TB NVMe 项目盘 + 大容量 HDD 归档 | 高静压散热、≥2600 W 电源、PCIe 拓扑需保证 GPU 对等通信带宽 | 13B—34B 级模型训练/继续预训练,多模态模型实验 |
| 高性能(小集群节点) | 双路 64 核级,NUMA 绑定 GPU 分区 | 1—2 TB ECC | 8 张 80 GB 级 GPU,NVSwitch 全互联机箱级方案,机间 100/200 Gb 或 InfiniBand | 4 TB NVMe 系统盘 + RAID 阵列 NVMe 项目盘 + 并行文件系统对接 | 机架式、冗余电源、机房级散热;checkpoint 写入峰值需实测 | 70B 级及以上预训练节点,或作为更大集群的单节点模板 |
推荐理由与升级方向:TP 通信频率决定"单机的价值上限"——NVLink 域越大,机内可容纳的模型规模越大;单机显存总量决定可训练参数量下限。升级路径建议:先扩显存与 GPU 互联,再扩 CPU 内存,最后考虑多机 RDMA 组网。
六、软件清单
| 类别 | 名称 | 必需/可选 | 说明 |
|---|---|---|---|
| 训练框架 | Megatron-LM(含 Megatron-Core) | 必需 | 本文主角,PyTorch 之上的并行训练框架 |
| 基础框架 | PyTorch + CUDA + NCCL | 必需 | TP/PP/DP 通信由 NCCL 承载 |
| 加速组件 | Transformer Engine / Apex | 可选 | FP8/混合精度与融合算子 |
| 并行辅助 | 分布式优化器(Megatron 内置)、激活重计算 | 可选 | 显存紧张时启用 |
| 环境 | Python、conda/容器(NGC PyTorch 镜像) | 必需 | 建议容器化保证版本一致 |
| 监控 | nvidia-smi / DCGM、Nsight Systems | 可选 | 通信与显存瓶颈定位 |
| 可视化 | TensorBoard / Weights & Biases | 可选 | 训练曲线与实验管理 |
七、常见问题与硬件分析
Q1:单机 8 卡是否越多越好?
不是。论文实测显示小模型在固定 batch 下扩展收益迅速递减(1.2B 模型 1→8 卡仅约 3 倍加速)。并行度首先由显存需求决定:模型放得下,就少切分;切分越多,通信占比越高。
Q2:PCIe 互连的 4 卡工作站能跑张量并行吗?
可以运行,但 TP 每层两次 All-Reduce 对带宽敏感,PCIe 拓扑下 TP 效率明显下降。建议 TP 组限制在有高速互连的 GPU 对内,跨 PCIe 的部分用流水线或数据并行承载。
Q3:显存和内存如何配比?
经验规则:主机内存 ≥ GPU 显存总量的 1—2 倍,以容纳 dataloader 缓存、优化器状态 offload(若启用)与检查点写入缓冲。数据预处理重的场景取上限。
Q4:训练 70B 级模型单工作站够吗?
取决于精度与并行策略:BF16 权重 + Adam 状态的 70B 模型静态显存需求约 1.1 TB 量级,超出单工作站 8×80 GB 的能力边界,需要分布式优化器切分或多机扩展。工作站更适合 30B 级以下或微调场景,更大规模建议以工作站为开发环境、集群为生产环境。
Q5:消费级 GPU 与专业 GPU 如何选择?
Megatron-LM 本身不限定 GPU 类型,但长时间满负荷训练对显存容量、ECC、散热与驱动稳定性要求高;专业卡在显存容量与可靠性上更有保障,消费卡性价比高但需自行评估稳定性风险与厂商支持政策。
八、总结与选型建议
Megatron-LM 的核心启示是:大模型训练的硬件规划应从"并行策略反推互连拓扑"。张量并行每层通信,必须落在 NVLink/NVSwitch 高速域内;流水线并行适合跨域;数据并行放在最外层。对工作站用户:先算清目标模型的显存下限(权重+梯度+优化器状态+激活),确定 GPU 数量与单卡显存;再按 TP 组大小选择具备相应 GPU 互联能力的机箱与主板;最后按 1—2 倍显存总量配主机内存,用高吞吐 NVMe 保障检查点与数据管线。避免"堆卡即提速"的误区——通信拓扑不对,卡数越多浪费越大。
参考来源
- Shoeybi M. et al. Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism. arXiv:1909.08053. https://arxiv.org/abs/1909.08053
- Narayanan D. et al. Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM. arXiv:2104.04473. https://arxiv.org/abs/2104.04473
- NVIDIA Megatron-LM 代码库. https://github.com/NVIDIA/Megatron-LM
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



