






摘要:自由能微扰(FEP)以接近实验的精度(约 1 kcal/mol 量级)预测蛋白-配体结合亲和力,已成为苗头化合物优化阶段的标准计算实验。FEP+ 基于 GPU 分子动力学引擎,按扰动对批量提交。本文解析其负载结构,给出不同研发规模下的 UltraLAB 工作站配置。
适用读者:计算化学/CADD 研究员、药企先导优化团队、高校药物设计课题组。
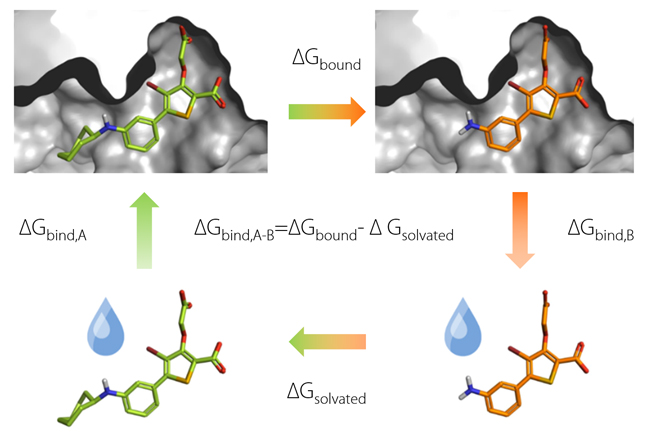
一、资料背景与核心观点
- 资料名称:Schrödinger FEP+ 官方产品资料;Wang L. 等,J. Am. Chem. Soc. 2015(FEP+ 方法学论文,DOI: 10.1021/ja512751q)。
- 原文链接:https://www.schrodinger.com/platform/products/fep/、https://pubs.acs.org/doi/10.1021/ja512751q。
核心观点:FEP+ 通过"炼金术"自由能微扰,沿 λ 窗口在分子动力学模拟中逐步将一个配体变为另一个,计算相对结合自由能;官方称其在大规模验证研究中达到接近实验的预测精度(约 1 kcal/mol),并支持相对/绝对结合、溶解度、残基突变等多类扰动。主动学习(Active Learning)工作流可用 ML 模型引导,将 FEP+ 扩展到百万级化合物库的高效筛选。
二、主要功能模块与核心算法
- 自由能微扰/热力学积分:λ 耦合参数窗口采样,Bennett 接受比(BAR)等方法估计 ΔΔG。
- GPU 分子动力学引擎:Desmond GPU 版执行溶剂化体系的纳秒级采样。
- 自动化图构建:扰动图(perturbation map)自动生成与环路闭合误差控制。
- 主动学习 FEP:用已有 FEP+ 结果训练项目专属 ML 模型,只对最有价值的化合物做全计算。
- 体系准备:蛋白准备(Protein Preparation Wizard)、力场分配(OPLS 系列)。
三、计算特点与性能瓶颈
3.1 GPU 密集且"多任务独立"
单个 FEP 计算 = 多 λ 窗口 × 溶剂化 MD 采样,GPU 上运行;不同扰动对之间相互独立,属高吞吐批量负载:卡数近似线性转化为日吞吐(每天可完成的扰动数)。这是与"单一大体系 MD"完全不同的扩展模式。
3.2 单任务资源画像
单扰动体系(蛋白+配体+水盒,数万—十几万原子)在单 GPU 上运行;显存需求温和(8—16 GB 量级通常可覆盖),但追求单任务速度时大显存高算力卡仍有收益。CPU 负责体系准备、分析与任务编排,按并发任务数配 8—16 线程/卡。
3.3 存储与 I/O
轨迹与分析数据持续写入;批量场景下每天可累积数百 GB,NVMe 项目盘 + 定期归档是标准做法。
四、典型应用场景
- 先导化合物优化:每轮数十—数百个设计分子的相对结合自由能排序。
- 选择性/溶解度优化:多性质并行扰动。
- 残基突变扫描:亲和力成熟、耐药突变评估。
- 主动学习大规模筛选:ML 预筛 + FEP+ 精算的闭环。
五、UltraLAB 硬件配置建议
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 系统盘/项目盘/数据盘 | 散热/电源/扩展 | 适用场景 |
|---|---|---|---|---|---|---|
| 入门级 | 16 核 | 64—128 GB | 2 卡,每卡 16—24 GB | 1 TB NVMe + 2 TB NVMe | 风冷,1200 W | 课题组级,每周数十扰动 |
| 主流级 | 32—48 核 | 256 GB | 4 卡,每卡 24—48 GB | 2 TB NVMe + 4 TB NVMe + 归档盘 | 高规格风冷/液冷,1600—2000 W | 药企项目组,每日数十扰动 |
| 高性能级 | 64 核或双路 | 512 GB | 8 卡,每卡 48 GB 以上 | 2 TB NVMe + 8 TB NVMe + NAS 归档 | 整机液冷,冗余电源 | 多项目并行、主动学习大批量闭环 |
说明:FEP+ 按 GPU 并发数消耗许可(具体授权模型以 Schrödinger 商务条款为准),硬件卡数应与许可匹配;GPU 型号支持列表以官方文档为准,采购前请核实。
六、软件清单
| 类别 | 软件 | 必需性 |
|---|---|---|
| 核心平台 | Schrödinger Suite(Maestro、FEP+) | 必需 |
| MD 引擎 | Desmond(GPU) | 必需 |
| 体系准备 | Protein Preparation Wizard、LigPrep | 必需 |
| 开源替代 | OpenFE(Open Free Energy)、pmx、GROMACS/AMBER TI | 可选(方法对比) |
| 分析 | FEP+ 内置分析、Python/pandas | 必需 |
| 运行环境 | Linux(RHEL/Rocky 系)、CUDA | 必需 |
七、常见问题(FAQ)
Q1:FEP+ 为什么适合多卡工作站而不是超算?
扰动任务天然独立、单任务规模适中,多卡工作站即可获得近似线性的吞吐扩展,且无队列等待;超算更适合千卡级峰值需求。
Q2:开源方案(OpenFE/GROMACS TI)能替代 FEP+ 吗?
方法上等价、生态与验证程度不同:FEP+ 的优势在自动化、力场与大规模验证;开源路线灵活但需自建流程。硬件需求画像(GPU 批量 MD)两者基本一致。
Q3:GPU 显存需要多大?
单扰动体系通常 16 GB 级显存可覆盖;大蛋白/膜体系或追求单任务速度时 24—48 GB 更从容。吞吐导向场景"卡数 > 单卡显存"。
Q4:主动学习 FEP 的硬件增量在哪?
ML 训练负载很轻,主要增量仍是更多 FEP+ 计算本身;闭环自动化要求工作站长期稳定运行,电源与散热冗余值得投资。
八、总结与选型建议
FEP+ 类自由能计算的选型主线是"GPU 卡数定吞吐,单卡显存定体系上限,CPU/存储配套批量流水线"。课题组 2 卡起步;项目组 4 卡/256 GB 是甜点;多项目并行上 8 卡液冷平台。硬件规模务必与 FEP+ 许可并发额度对齐,避免资源闲置。
边界声明:约 1 kcal/mol 精度为官方大规模验证研究口径,具体项目精度取决于体系与力场适用性;GPU 支持与许可模型以 Schrödinger 官方信息为准。
参考来源
- Schrödinger. FEP+ 产品页. https://www.schrodinger.com/platform/products/fep/
- Wang L, et al. Accurate and Reliable Prediction of Relative Ligand Binding Potency in Prospective Drug Discovery by Way of a Modern Free-Energy Calculation Protocol and Force Field. JACS 2015. https://pubs.acs.org/doi/10.1021/ja512751q
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



