






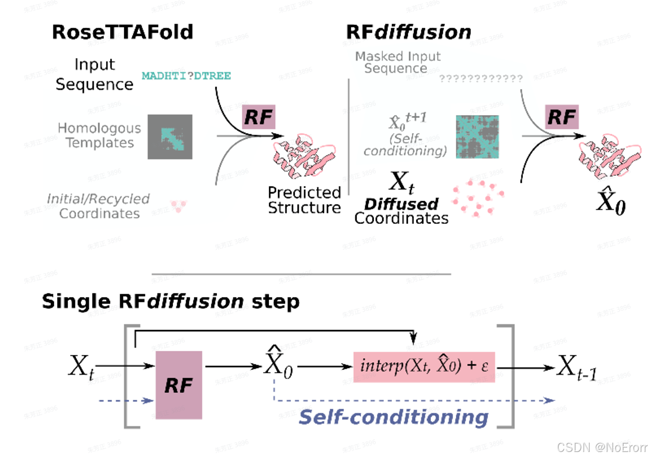
摘要:RFdiffusion 是华盛顿大学 Baker 实验室提出的蛋白质骨架生成模型,将 RoseTTAFold 结构预测网络改造为去噪扩散模型,可从零生成或按功能约束生成蛋白质骨架。本文依据其 Nature 论文与官方代码仓库梳理推理流程,分析显存随设计长度增长的核心约束与批量采样的吞吐逻辑,给出面向蛋白质工程团队的 UltraLAB 工作站分档配置建议。
适用读者:蛋白质工程与合成生物学研究人员、计算结构生物学团队、从事酶设计与结合蛋白设计的实验室。
一、资料背景与核心观点
- 资料名称:De novo design of protein structure and function with RFdiffusion(Nature)与 RosettaCommons/RFdiffusion 官方代码仓库
- 发布机构:University of Washington(Baker Lab)等
- 原文链接:
核心观点:RFdiffusion 在蛋白质骨架坐标空间执行去噪扩散:从噪声(或条件化初始结构)出发,经数十至上百步去噪生成新骨架,支持无条件生成、对称寡聚体、功能位点支架(scaffolding)、结合蛋白设计等任务。论文报告了计算设计与多类实验验证结果。对选型的关键事实是:推理完全在单张 GPU 上执行,显存占用随设计残基长度显著增长,且实际工作流需要"大量采样 + 下游筛选"——生成只是管线第一环,随后还有 ProteinMPNN 序列设计与 AlphaFold2/Rosetta 验证,构成 GPU 与 CPU 交替的混合负载。
二、主要功能模块与核心算法
依据论文与官方仓库:
- 去噪扩散骨干:基于 RoseTTAFold 的三轨(序列-距离-坐标)网络改造,逐步从噪声骨架去噪至目标结构;推理步数(T)可调,步数越多单样本耗时越长。
- 条件化机制:功能位点/靶蛋白等条件信息经势能与引导(guidance)机制注入采样过程,实现 motif scaffolding 与 binder 设计。
- 对称与寡聚体生成:通过对称性约束生成环状/多聚体组装体。
- 推理脚本体系:官方仓库提供统一入口脚本,通过参数控制设计长度、条件、采样数与输出格式;权重文件需单独下载。
- 配套生态:ProteinMPNN 做序列设计、AlphaFold2/RoseTTAFold 做结构验证筛选——官方文档将其作为推荐下游流程引用。
原文未提供统一的显存—长度对照表;显存占用与设计长度、条件复杂度相关,需实测校准。
三、计算特点与性能瓶颈
计算密集特征
- GPU 单卡推理:每个样本的去噪链在单卡上执行,FP32 张量计算为主;单样本耗时随长度与步数增长,从秒级到分钟级不等。
- 批量采样 = 任务级并行:实际设计需要成百上千个候选骨架,样本间完全独立,多 GPU 按卡数线性提升吞吐。
- 管线混合负载:RFdiffusion(GPU)→ ProteinMPNN(GPU,较轻)→ AF2 验证(GPU + CPU 数据库检索)交替,整机需兼顾两类负载。
显存与内存
- 显存是第一约束:短链(<150 残基)无条件生成可在 8–12 GB 显存运行;长链与复杂条件(如 300+ 残基、结合蛋白设计)显存需求升至 24 GB 乃至更高。建议以 24 GB 为通用下限,48 GB 覆盖长链与复杂条件,并以目标设计任务实测确认。
- 系统内存需求温和,64 GB 覆盖多数场景;AF2 验证环节因序列数据库与批量任务建议 128 GB。
I/O 与存储
- 模型权重数 GB,输出 PDB 文件小;批量采样产生的中间轨迹文件可控。主要存储压力来自下游 AF2 数据库(数百 GB)——若管线包含 AF2 验证,需为其预留 2–3 TB NVMe。
四、典型应用场景
- 结合蛋白(binder)设计:针对给定靶标生成结合骨架,需大批量采样 + 严格筛选,多 GPU 吞吐导向。
- 功能位点支架:酶活性位点、表位的骨架移植,中长链条件化生成,显存需求较高。
- 对称材料与寡聚体设计:蛋白笼、多聚体组装,入门—主流档即可覆盖。
- 方法教学与算法研究:复现论文、调整扩散过程,单卡 24 GB 可开展。
五、UltraLAB 硬件配置建议
说明:官方未发布硬件配置表,以下按"显存随长度增长、吞吐随卡数线性"的机制推导;采购前请以目标设计任务(长度、条件类型)实测显存峰值。
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 系统盘 / 项目盘 / 数据盘 | 散热 / 电源 / 扩展性 | 适用场景 |
|---|---|---|---|---|---|---|
| 入门级 | 高主频 12–16 核 | 64 GB | 单张 24 GB 显存级 GPU | 1 TB NVMe 系统盘 + 2 TB NVMe 项目盘(含 AF2 数据库则 4 TB) | 风冷塔式,1200 W 级电源 | 短链无条件生成、教学与方法研究 |
| 主流级 | 24–32 核 | 128 GB ECC | 单张 48 GB 显存级 GPU,或双 24 GB 卡 | 2 TB NVMe 系统盘 + 4 TB NVMe 项目盘 + 8 TB HDD 归档 | 强化风冷,1600 W 级电源 | binder 设计批量采样、完整 RFdiffusion→MPNN→AF2 管线 |
| 高性能级 | 32–64 核 | 256 GB ECC | 2–4 张 48 GB 显存级 GPU | 2 TB NVMe 系统盘 + 8 TB NVMe 项目盘 + 16 TB RAID 归档 | 冗余电源、分舱风道、7×24 设计 | 千级候选批量生成与验证筛选生产性运行 |
推荐理由与升级方向:显存决定"能不能设计长链与复杂条件",卡数决定"每天能出多少候选";升级优先增加 GPU 张数,其次扩充 NVMe 以承载 AF2 数据库与批量中间结果;CPU 在 32 核后收益递减。
六、软件清单
| 类别 | 软件 | 必需性 | 说明 |
|---|---|---|---|
| 生成模型 | RFdiffusion(官方仓库 + 权重) | 必需 | 需支持 CUDA 的 NVIDIA GPU |
| 序列设计 | ProteinMPNN | 必需(管线下游) | 骨架到序列 |
| 结构验证 | AlphaFold2 / RoseTTAFold | 可选(强烈推荐) | 设计可行性筛选;AF2 需约 2 TB 级数据库 |
| 深度学习框架 | PyTorch + CUDA/cuDNN | 必需 | 版本与仓库要求匹配 |
| 结构分析 | PyMOL / ChimeraX、BioPython | 可选 | 结果检查与批量处理 |
| 环境管理 | Conda / Apptainer | 可选 | 依赖固定 |
七、常见问题(FAQ)
Q1:24 GB 显存能做结合蛋白设计吗?
中等长度可以,长链与复杂条件可能溢出。显存占用随设计总长度(靶标 + 设计链)增长,官方未给出统一对照表。建议先以目标任务规模做小规模实测;预算允许时选 48 GB 显存级 GPU 可显著降低反复裁剪任务的工程成本。
Q2:多 GPU 能加速单个样本的生成吗?
不能。单个样本的去噪链在单卡上串行执行;多 GPU 的正确用法是并行跑多个样本,吞吐近似按卡数线性增长——这恰好匹配"大量采样 + 筛选"的设计范式。
Q3:RFdiffusion 生成后为什么还要跑 AlphaFold2?
扩散模型生成的是骨架,需经 ProteinMPNN 设计序列,再用 AF2 预测该序列是否折叠回目标骨架,作为计算筛选。AF2 环节引入约 2 TB 级数据库与额外 GPU/CPU 负载,是整机存储与内存规划必须计入的部分。
Q4:CPU 配置重要吗?
相对次要但不忽略:数据装载、AF2 的 MSA 检索与批量任务调度都在 CPU 上。16–32 核高主频即可,超过 32 核后收益递减,预算应优先投向 GPU。
Q5:训练自己的 RFdiffusion 需要什么样的硬件?
论文级训练使用大规模加速卡集群,单机工作站不现实。工作站适合推理与少量微调试验;微调前请核实官方仓库是否提供训练代码与资源说明,按实测显存需求评估。
八、总结与选型建议
RFdiffusion 工作流的选型逻辑是"显存决定任务上限、卡数决定日吞吐、存储为 AF2 验证留余量"。入门以 24 GB 显存单卡 + 64 GB 内存起步;binder 与功能位点设计的生产性运行建议 48 GB 显存级单/双卡 + 128 GB 内存 + 4 TB 以上 NVMe;千级候选批量筛选再上多卡平台。采购前用目标设计规模实测显存峰值,是避免配置失误的最可靠步骤。
参考来源
- Watson, J. L. 等:De novo design of protein structure and function with RFdiffusion,Nature(2023)。https://www.nature.com/articles/s41586-023-06415-8
- RosettaCommons:RFdiffusion 官方代码仓库。https://github.com/RosettaCommons/RFdiffusion
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



