






一句话导读:一套从公开资料整理的 24个三维大尺寸目标CST模型库(无人机、舰船、固定翼飞机)正在电磁仿真圈刷屏——模型可以直接导入CST求解表面电流与RCS。但网格量动辄800万~1400万的电大尺寸仿真,普通工作站根本算不动。本文拆解其核心算法与计算特点,并给出 UltraLAB 工作站/服务器四级硬件选型方案、软件清单与大模型本地部署攻略。
本文目录
- 核心内容应用分析:24个大尺寸目标CST模型库
- 主要核心算法:CST求解器与RCS仿真算法
- 计算特点:网格、内存、并行与GPU加速
- 应用场景
- UltraLAB硬件配置怎么选
- 软件清单
- 大模型本地部署指南
- 常见问题:硬件配置分析(FAQ)
一、核心内容应用分析
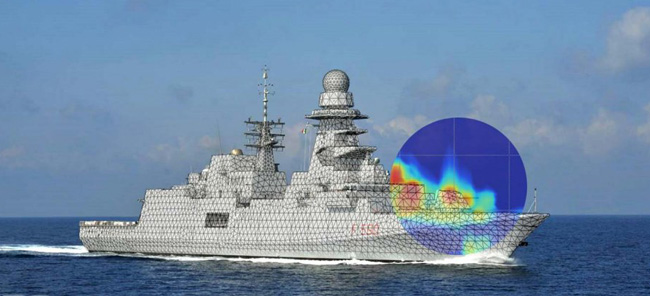
近期,电磁仿真公众号「CST超表面工坊」第34期发布了一套 三维大尺寸目标CST模型库:团队从公开资料整理出 24个三维目标(旋翼无人机、四旋翼飞行器、大型水面舰艇、固定翼无人机等),并完成 格式转换 → 尺寸设置 → CST工程配置 的全流程,可直接用于 表面电流分布与RCS(雷达散射截面) 求解。
1.1 模型库的工程化亮点
| 亮点 | 说明 | 对仿真的价值 |
|---|---|---|
| 开箱即用的工程对象 | 每个工程已建好 Components、Plane Wave、Excitation Signals、Field Monitors、Farfields | 跳过繁琐激励/监视器配置,直接求解 |
| 多频点监视器 | 每个目标预设 5λ / 7.5λ / 10λ 等多频点 E/H 场与表面电流监视器 | 一次求解覆盖多个电尺寸工况 |
| CAD外形保真导入 | 舰船类目标以多实体CAD导入(如 FREMM 护卫舰 47 个导入对象),保留上层结构与船体轮廓 | 复杂电大目标几何不失真 |
| 材料一键设置 | PEC(理想导体)材料 + PTC 热边界直接写入 | 散射问题标准配置 |
| 网格规模透明 | 消息窗口实时显示网格数:7,971,810 / 8,283,609 / 13,778,886 / 3,888,929 网格单元 | 直接暴露硬件需求水位 |
1.2 仿真结果:从表面电流到RCS
几何进入工程后,可在结果树中调取各频点的 表面电流分布——颜色分布直观显示入射波作用下目标表面电流幅值,细长构件、边缘和局部连接处 通常是强散射源:
关键洞察:24个模型的网格量普遍在 400万~1400万单元。以 freemm_aquitaine(护卫舰)8,283,609 网格、global_hawk 3,888,929 网格的规模看,这是一组为"电大尺寸全波/混合求解"准备的基准模型库——硬件配置直接决定你能否在下班前拿到RCS结果。
二、主要核心算法
大尺寸目标RCS仿真的核心矛盾是:几何细节要求细密网格,而电大尺寸又要求海量网格。CST的多求解器架构正是为此设计:
2.1 核心求解器与算法对照表
| 求解器 | 核心算法 | 适用电尺寸 | 计算特点 | 硬件诉求 |
|---|---|---|---|---|
| T求解器(时域) | 有限积分法 FIT + PBA/TST | 电中尺寸(<10λ~几十λ) | 天然并行、一次时域跑宽带;PBA 完美边界拟合曲面,TST 薄片技术处理薄层 | 核数 > 内存带宽 > GPU加速 |
| I求解器(积分方程) | 矩量法 MoM / MLFMM + ACA | 电大尺寸远场RCS | 多层快速多极子加速,内存密集型;支持单站RCS快速扫角 | 大内存 + 多核 |
| A求解器(渐进) | 物理光学 PO + 弹跳射线 SBR | 超电大(飞机/舰船整机) | 高频近似效率极高,但对近入射角/腔体类偏差大;支持 ILDC 边缘绕射修正 | 多核 CPU,内存适中 |
| 频域FEM求解器 | 有限元法 | 窄带谐振结构 | 自适应网格、内存随网格近平方增长 | 内存容量 > 带宽 > 核数 |
| 混合求解器 | 全波 + 高频双向耦合 | 大型平台天线布局RCS | 平台用A求解器、源区用I求解器,双向混合 | 大内存 + 多核 + 调度 |
2.2 工程中的关键技术点
-
PBA(Perfect Boundary Approximation):消息窗口中可见
[Perfect Boundary Approximation (PBA), version: default],曲面无需 stair-case 即可精确拟合,配合[Matrixcalc GPU acceleration: on, # of GPUs: 1]实测显著加速矩阵运算; -
TST / 薄片技术:处理旋翼桨叶等薄层结构,消息中
unexpected split TST type提示会自动改用域分解(domain decomposition)重试; - 表面电流 → 远场RCS链路:Field Monitors 记录 5λ/7.5λ/10λ 频点场分布,后处理模板直接输出单站/双站RCS曲线与二维散射图。
三、计算特点
一句话总结:频域直接求解看内存,时域求解看核数与带宽,RCS扫角看调度与存储,智能体与可视化看GPU显存,连续数天的求解看散热。
3.1 计算负载特征表
| 负载特征 | 具体表现 | 硬件瓶颈 |
|---|---|---|
| 网格规模爆炸 | 24个基准模型网格 390万~1380万单元;整机舰船/飞行器RCS常突破2000万单元 | 内存容量(时域约 1~2 GB/百万网格) |
| 时域天然并行 | FIT 显式迭代,核数越多宽带扫频越快 | CPU核数 + 八通道内存带宽 |
| GPU加速成熟 | 时域求解、三维场渲染、远场RCS均可CUDA加速 | NVIDIA显存≥12GB,重度24GB/48GB |
| I/O密集 | 场监视器数据动辄数十GB,Gen5 NVMe 读写14GB/s | NVMe SSD 热数据层 |
| 长时满载 | 电大模型单次求解数小时~数天 | 工业级水冷散热 |
3.2 官方与实测硬件基线
-
达索官方建议:通用工作站 每CPU 8
16核、每CPU配64128GB内存(8条内存插满全部通道以拉满带宽); - GPU加速官方要求:显存≥12GB,仅支持NVIDIA;高端示例配置为双 Xeon Gold 6334 + Quadro GV100 32GB + 128GB DDR4-3200;
- 实测参考:V100 时域加速约 6×,4×A100 约 17×;RTX 4090 48GB 在 CST 2023 后加速比可达 3.2×。
四、应用场景
| 应用场景 | 主要需求 | 推荐求解器 | 关键硬件 | 代表模型 |
|---|---|---|---|---|
| 无人机RCS特征评估 | 旋翼/机身散射源定位、隐身修形 | T / I 求解器 | 多核 + 128~256GB | Typhoon H480、Iris 四旋翼 |
| 舰船整机RCS | 超电大目标单站/双站RCS | A求解器(PO+SBR) | 多核CPU + 大内存 | FREMM Aquitaine、MEKO Barbaros |
| 固定翼平台散射 | 翼面/进气道/挂架强散射分析 | I + A 混合 | 256~512GB ECC | Global Hawk |
| 天线布局与阵地环境 | 载体上天线方向图畸变评估 | 混合求解器 | 大内存 + 多核 | 平台+天线组合模型 |
| 目标识别数据库构建 | 多角度RCS样本批量生成 | I求解器快速扫角 + 参数扫描 | 高并行 + 大NVMe缓存 | 24模型库批量求解 |
| 仿真智能体辅助 | 脚本生成、收敛诊断、报告撰写 | 本地大模型 + PyAEDT/CST Python | GPU 32~96GB | DeepSeek-R1 / Qwen |
五、UltraLAB硬件配置怎么选:核心原则
- 内存容量决定可解问题规模:时域求解约需 1~2GB/百万网格——800万网格的无人机工程 128GB 可解,1400万网格的舰船模型 256GB 起步,整机级 RCS 建议 512GB~2TB ECC;内存不足不是"慢",而是直接报错退出;
- 核数与内存带宽决定求解速度:FIT 时域在多核上近线性扩展,但必须插满内存通道(8/12/16通道 DDR5)喂饱算力;
- GPU 的确定性价值:CST 时域求解器 GPU 加速可提速 40%~60%,更大回报在智能体推理、场数据可视化与 AI 代理模型优化设计;
- NVMe 决定流程效率:场监视器与项目文件动辄数十GB,PCIe 5.0 NVMe(14GB/s)显著缩短加载与读写;
- 散热决定长任务生死:全波求解连续满载数天是常态,工业级水冷保障不降频、不报错。
5.1 四级配置方案(2026版)
方案A:入门工作站(预算 2~4万)—— 个人工程师 / 高校课题组
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB A350 | 个人旗舰工作站,水冷超频优化 |
| CPU | Intel Ultra7 265K(20核,全核5.1GHz) | 高频加速网格剖分与前后处理 |
| GPU | RTX 5060Ti 16GB | 轻量可视化 + 7B~14B智能体 |
| 内存 | 128GB DDR5-5600 | 覆盖400~600万网格时域求解 |
| 存储 | 4TB NVMe Gen4 | 单项目50~200GB场数据高速读写 |
| 散热 | 360mm 一体水冷 | 长时间满载不降频 |
方案B:专业电磁仿真工作站(预算 5~8万)—— 无人机/天线RCS团队
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB A350 高配 | 专业工作站,双冷排水冷 |
| CPU | Intel Ultra9 285K(24核,全核5.6GHz) | 24核高频显著缩短剖分与扫角时间 |
| GPU | RTX PRO 5000 48GB / RTX 4090 48GB | CST GPU求解 + 32B全精度智能体 |
| 内存 | 192GB DDR5 RDIMM | 800~1000万网格(Iris/FREMM级)求解保障 |
| 存储 | 4TB NVMe Gen5(14GB/s) | 大场文件高带宽读写 |
| 散热 | 双冷排 + 双水泵水冷 | 求解与推理双满载低温稳定 |
方案C:超级工作站(预算 9~15万)—— 整机舰船/大型平台RCS
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB AE450 | 科研级算力平台 |
| CPU | AMD EPYC 9005 系列 24~32核高频 + 12通道DDR5 | 内存带宽拉满,驱动1400万+网格求解 |
| GPU | RTX PRO 6000 96GB | 70B智能体FP16推理 + ECC保障数天长任务 |
| 内存 | 384GB DDR5 ECC RDIMM(12×32GB 插满通道) | 整机RCS/超表面电大尺寸直接求解 |
| 存储 | 4TB NVMe Gen5 + 8TB 企业级HDD | 全闪热数据层 + 项目归档层 |
| 网络 | 万兆以太网 | 与单位集群数据互通 |
方案D:多GPU超算平台/集群(预算 20~80万)—— 军工院所 / 批量RCS数据库
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| 机型 | UltraLAB GT650M / EX660 | 双路服务器,6×PCIe 4.0 x16 全速 |
| CPU | 2× Intel Xeon 5代可扩展(64~96核) | 10+个24模型批量求解任务并行排队 |
| GPU | NVIDIA RTX 4090 48GB ×2~4 / A100 | 时域GPU加速 + 智能体服务 + AI优化训练物理隔离 |
| 内存 | 512GB~2TB DDR5 ECC RDIMM | 超大模型直接求解、多任务内存隔离 |
| 存储 | 4TB NVMe Gen5 + 16TB HDD RAID1 | 热数据全闪 + 涉密项目双保险 |
| 网络/散热 | 万兆/InfiniBand;工业水冷 | MPI分布式求解低延迟互联 |
5.2 选型结论速查
内存 128GB  →  400~600万网格无人机RCS / 轻量智能体
     ↓
内存 192GB + GPU 48GB  →  800~1000万网格舰船/平台RCS / 32B智能体
     ↓
内存 384GB + GPU 96GB  →  1400万+网格整机RCS / 70B智能体
     ↓
内存 512GB~2TB + 2~4 GPU  →  团队RCS数据库 / MPI集群 / AI优化设计
六、软件清单
6.1 电磁仿真核心软件栈
| 工具/框架 | 类型 | 核心用途 | 硬件依赖 |
|---|---|---|---|
| CST Studio Suite 2026 | 时域FIT/频域/积分方程/渐进 | 大尺寸目标RCS、EMC、电大尺寸全波 | 多核 + 内存带宽 + NVIDIA GPU |
| Ansys HFSS | 频域FEM | 天线、微波器件、封装RCS | 大内存直接求解,256GB级 |
| Altair FEKO | MoM/MLFMM | 天线布局、散射、线缆束EMC | 内存密集 + 多核 |
| COMSOL Multiphysics | 多物理场 | 电磁-热-力耦合 | 均衡配置 |
| MATLAB Antenna Toolbox | 快速设计 | 阵列综合、方向图快速计算 | 轻量CPU |
| CST Python / VBA | 脚本接口 | 24模型库批量求解、参数扫描自动化 | 与求解器同硬件 |
| PyAEDT | Python API | HFSS/SIwave自动化建模 | 与求解器同硬件 |
6.2 AI与本地大模型栈
| 工具/框架 | 用途 | 硬件依赖 |
|---|---|---|
| Ollama / vLLM | 本地大模型推理框架 | NVIDIA GPU 32~96GB |
| DeepSeek-R1 / Qwen2.5 / GLM | 仿真脚本生成、日志诊断、报告撰写 | 14B~72B 按显存选型 |
| RAG 向量库(FAISS/Milvus) | 设计规范与历史报告检索 | GPU + NVMe |
| JupyterLab / VS Code | 仿真自动化开发环境 | 通用 |
七、大模型本地部署指南
电磁仿真与本地大模型是"绝配":让 AI 帮你写 CST Python 批量脚本、诊断 TST setup failed 之类的收敛日志、自动生成RCS分析报告——数据不出内网,符合保密要求。
7.1 三步部署(Ollama 示例)
# 第一步:安装 Ollama(Windows / Linux 均支持)
curl -fsSL https://ollama.com/install.sh | sh

# 第二步:拉取模型(按显存选型,见7.2节)
ollama run qwen2.5:14b        # 32GB显存,脚本生成/日志诊断
ollama run deepseek-r1:32b    # 48GB显存,方案推理/收敛诊断
ollama run qwen2.5:72b        # 96GB显存,报告审校/知识库问答

# 第三步:对接 CST 自动化(Python 示例)
# pip install openai pywin32
from openai import OpenAI
client = OpenAI(base_url="http://localhost:11434/v1", api_key="ollama")
resp = client.chat.completions.create(
    model="qwen2.5:14b",
    messages=[{"role": "user", "content":
        "生成一段 CST Python 脚本:遍历工程文件列表,批量启动时域求解并导出单站RCS"}]
)
print(resp.choices[0].message.content)
7.2 模型规模—GPU显存速查表
| 智能体任务 | 模型规模 | 最低显存 | 推荐GPU |
|---|---|---|---|
| 脚本生成 / 日志诊断 | 7B~14B | 16~32GB | RTX 5060Ti 16GB / RTX 5090 32GB |
| 规范检索 / 方案推荐 | 14B~32B | 32~48GB | RTX PRO 5000 48GB |
| 报告生成 / 审校 | 70B 量化 | 48~96GB | RTX PRO 6000D 84GB |
| 报告审校(FP16) | 70B 全精度 | 96GB | RTX PRO 6000 96GB |
| 机构专属微调(LoRA/QLoRA) | 按需 | 48~96GB,多卡更优 | 2× RTX PRO 6000 |
部署建议:电磁数据敏感单位优先选择 UltraLAB 方案B/C 的 48GB~96GB 单卡配置——一张卡同时覆盖 CST GPU 求解加速 + 本地大模型推理,物理隔离、无需外网。
八、常见问题:硬件配置分析
Q1:导入24模型库后求解直接报内存不足,怎么补救?模型网格量可从 CST 状态栏 Meshcells 直接读取(如 freemm_aquitaine 为 8,283,609 单元)。时域求解粗略按 1~2GB/百万网格 估算:
- ≤600万网格 → 128GB 内存
-
600
1000万网格 → 192256GB -
1000
2000万网格(整机舰船RCS)→ 512GB2TB ECC
内存不够时 CST 会直接报错退出,没有"慢慢跑"的选项——这是电大尺寸仿真硬件预算的第一优先级。
Q2:消息窗口出现 "unexpected split TST type / Retrying with different domain decomposition" 是硬件问题吗?
不是。这是 薄片技术(TST)遇到无法处理的薄层分裂类型 时的自动回退机制,CST 会自动改用域分解重新求解。若频繁出现且求解时间暴涨,说明模型薄层结构复杂,建议:① 检查桨叶/薄板几何;② 启用 GPU 加速([Matrixcalc GPU acceleration: on])弥补矩阵运算开销;③ 多激励并行时预留 基础内存 × (1 + 0.3×激励数)。
分两点看:
- CST时域求解器GPU加速:官方要求显存≥12GB,仅支持NVIDIA;实测大显存卡可缩短 40%~60% 求解时长(V100约6×,4×A100约17×);
- 专业卡 vs 游戏卡:求解加速两者均可;但连续数天长任务推荐 RTX PRO 系列(ECC显存纠错),消费级 RTX 4090 48GB 性价比更高,适合预算敏感的课题组。
- 电尺寸 <10λ(无人机、部件级):I求解器(MLFMA全波)精度最高,内存密集,按"大内存+多核"配;
- 超电大(舰船、整机飞机):A求解器(PO+SBR)效率极高,CPU多核型负载,内存需求相对温和;
- 混合场景(平台上天线):用双向混合求解器,硬件按"大内存+多核+调度"的均衡架构配(方案C)。
批量求解的瓶颈常在 调度与吞吐 而非单次求解:高频多核CPU + 大容量NVMe缓存中间结果,比单纯堆单任务内存更划算。UltraLAB 方案D(64~96核 + 512GB + 多GPU)支持 10+ 个模型排队并行,配合 CST Python 脚本夜间自动批量出图。
Q6:大模型本地部署会不会和CST抢资源?
会,但可控:① 求解时GPU主要被CST占用,建议智能体推理设 num_gpu_layers 限层;② 更优做法是 方案B/C/D 的双负载设计——CPU负责求解、大显存GPU负责推理,物理分工互不挤占;③ 连续任务用 vLLM 排队,避免并发OOM。
单一智能体推理 + CST可视化优先 96GB单卡(部署简单、显存不碎片化);需要同时服务多名工程师、跑AI代理模型训练或任务隔离时,多卡更优。
Q8:存储需要多大?机械盘能用吗?单个大项目(网格+场分布+RCS全谱)常见 50~200GB,24个模型库全套建议预留 2TB 以上。机械硬盘会造成严重 I/O 阻塞——系统+工程必须放 NVMe,HDD 仅做归档备份。
总结与行动建议
- 个人/课题组:方案A(128GB + RTX 5060Ti)即可跑通 400~600 万网格无人机RCS + 轻量智能体;
- 无人机/天线团队:方案B(192GB + 48GB GPU)是 800~1000万网格的甜点配置;
- 整机舰船RCS:方案C(384GB ECC + 96GB GPU)一步到位;
- 批量RCS数据库/军工院所:方案D 多GPU超算平台 + 万兆网络。
UltraLAB 始终坚持 "算法匹配优先于配置堆砌":先按求解器类型(T/I/A)定内存与核数,再配GPU显存,最后按并发与微调需求定存储与网络。
采购前请明确:① 主要求解器与典型模型网格规模;② 是否批量扫角/参数扫描;③ 智能体模型规模与并发数;④ 数据密级与归档要求。
本文部分模型截图与工程信息引自「CST超表面工坊」第34期公开文章,仅作技术交流。UltraLAB 提供远程测试与技术方案咨询。
UltraLAB 图形工作站供货:西安坤隆计算机科技有限公司
业务电话:400-705-6800


