






摘要与适用读者
可微分编程把自动微分、即时编译(JIT)与数值计算融为一体,使“对求解器本身求导”成为现实:从材料本构反演、拓扑优化到损伤参数识别,梯度可以穿过整个有限元求解流程。本文依据可微分编程综述论文与 JAX-FEM 梯度增强损伤模型论文,提炼技术路线与计算负载特征,为从事科学机器学习(SciML)、反问题与结构优化的科研人员提供 UltraLAB 工作站分档选型方案。
资料背景与核心观点
- 资料一:Learning to Optimize by Differentiable Programming(可微分编程综述),arXiv:2601.16510
- 资料二:A Differentiable Framework for Gradient Enhanced Damage with Physics-Augmented Neural Networks in JAX-FEM,arXiv:2604.03411
- 原文链接:https://arxiv.org/abs/2601.16510;https://arxiv.org/abs/2604.03411
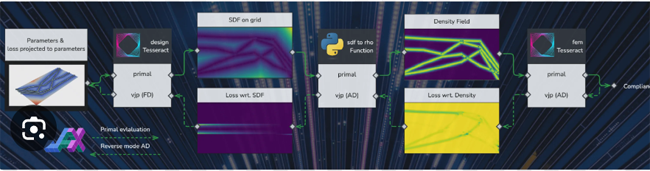
综述指出:JAX 是 Google Research 开发的高性能数值计算框架,可视为“可微分的 NumPy”,通过 grad、jacfwd、jacrev、vmap、jit 等可组合的函数变换,支持对任意 Python 函数的自动微分、即时编译与并行执行,已广泛应用于基于自动微分的优化、科学计算与可微物理仿真。JAX-FEM 论文进一步展示了实际落地:在开源包 JAX-FEM 中实现数据驱动的梯度增强损伤模型,将物理增强神经网络(PANN)本构与可微有限元结合——可微分编程免去了手工推导本构切线、灵敏度实现的负担,并打通了基于梯度的设计优化与反问题求解。
主要功能模块或核心算法
-
自动微分函数变换:
grad(标量函数梯度)、jacfwd/jacrev(前向/反向雅可比)、hessian组合,实现对本构模型、切线刚度与求解器灵敏度的自动求导。 -
jit即时编译:基于 XLA 将 Python 函数编译为优化后的 CPU/GPU 内核,消除解释器开销。 -
vmap自动向量化:将单点本构计算自动批量化到单元/积分点维度,配合pmap做多设备并行。 - 可微有限元流程(JAX-FEM):弱形式装配—线性/非线性求解—目标函数评估全链路可微,梯度经反向传播穿过求解器(隐式微分或解算器展开)。
- 物理增强神经网络本构(PANN):神经网络嵌入物理约束,与 FE 求解耦合训练。
计算特点与性能瓶颈
-
混合负载:前向有限元求解为稀疏线性代数(CPU 友好),神经网络本构评估与批量求导为稠密张量运算(GPU 友好);经
jit后可整体驻留 GPU。 - 内存/显存敏感:反向模式微分需保存前向中间量,自由度规模增大时显存占用陡增;百万自由度级三维问题建议采用隐式微分或检查点技术,并对显存留足余量。
- 并行特征:单步求解难以大规模 MPI 并行(JAX 生态以单节点多设备为主),但“批量参数扫描+vmap/pmap”具有天然的设备级并行性。
- CPU 需求:网格生成、稀疏装配与 IO 仍依赖 CPU;高主频有助于非 JIT 部分的开发调试效率。
- 精度问题:GPU 默认 float32,损伤/塑性问题建议开启 float64,需评估 GPU 双精度算力。
典型应用场景
- 材料本构参数反演:实验位移场→可微 FE→梯度下降识别本构参数,中小模型(10 万自由度内)单卡即可。
- 损伤与断裂相场/梯度增强损伤模拟+神经网络本构联合训练,需 float64 与较大显存。
- 拓扑优化与形状优化:每次迭代包含一次正演+一次伴随求解,迭代数百至数千次,GPU 加速收益明显。
- 不确定性量化中的批量正演:vmap 批量评估数百组参数样本。
UltraLAB 硬件配置建议
可微有限元的硬件核心是“GPU 显存+双精度能力+CPU 高主频”的组合,分档建议如下(配置为选型思路,具体以 UltraLAB 官方方案为准):
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 系统盘/项目盘/数据盘 | 散热/电源/扩展性 | 适用场景 |
|---|---|---|---|---|---|---|
| 入门 | 高主频 16 核桌面级处理器 | 64—128 GB DDR5 | 1× 16—24 GB GPU | 1 TB NVMe+2 TB NVMe | 塔式水冷,≥1000 W 电源 | 二维问题、算法学习、小规模反演 |
| 主流 | 24—32 核工作站级处理器 | 256 GB DDR5 | 1—2× 24—48 GB GPU | 2 TB NVMe+4 TB NVMe | 水冷,1600 W 级电源,预留第二卡位 | 三维中等规模(几十万自由度)可微 FE 与拓扑优化 |
| 高性能 | 64 核以上高内存带宽平台 | 512 GB—1 TB ECC | 2—4× 48 GB 级或 80 GB 级高双精度 GPU | 2 TB NVMe+8 TB NVMe+归档盘 | 机架式冗余电源,可扩展多卡 | 百万自由度级反问题、批量 UQ、PANN 联合训练 |
升级方向:显存优先(反向微分中间量是显存大户),其次双精度算力,再次 CPU 内存带宽;多卡扩展通过 pmap 或批量任务级并行实现。
提示:JAX 对 GPU 无专业卡认证要求,但 float64 性能在不同级别 GPU 上差异极大;若研究必须全程双精度,建议核实候选 GPU 的 FP64 峰值规格再决策。软件清单
| 类别 | 软件 | 必需/可选 | 说明 |
|---|---|---|---|
| 数值框架 | JAX(含 jaxlib、XLA) | 必需 | 自动微分与 JIT 核心 |
| 可微有限元 | JAX-FEM | 必需 | 开源可微 FE 求解框架 |
| 前处理 | Gmsh、meshio | 必需 | 几何建模与网格生成 |
| 科学计算 | NumPy、SciPy、scikit-sparse | 必需 | 数据处理与稀疏求解备份 |
| 优化 | Optax / scipy.optimize | 可选 | 梯度优化器 |
| 可视化 | ParaView、Matplotlib | 可选 | 场量后处理 |
常见问题(FAQ)
Q1:可微 FE 一定要 GPU 吗?
不一定。二维或几万自由度的小问题在 CPU 上 jit 后已足够快;三维、神经网络本构或批量反演场景 GPU 收益显著。建议按最大问题规模决定是否配置 GPU。
Q2:float32 和 float64 怎么选?
结构损伤、塑性问题通常需要 float64 保证收敛与精度;若使用 GPU,请核实其 FP64 吞吐(部分消费级卡 FP64 大幅阉割),必要时选择 FP64 较强的专业/数据中心卡。
Q3:反向传播显存不够怎么办?
优先使用隐式函数定理(自定义 VJP)或 jax.checkpoint 重计算策略;硬件层面升级显存是最直接的手段。
Q4:JAX-FEM 能 MPI 跨节点吗?
JAX 生态以单进程多设备为主,跨节点能力有限;多节点场景建议按“任务并行”(每节点跑独立参数样本)组织,而非单次求解跨节点。
Q5:CPU 为什么要高主频?
网格处理、弱形式代码开发调试阶段大量非 JIT 操作是单线程性能敏感的,高主频直接缩短迭代周期。
总结与选型建议
可微分编程(JAX/JAX-FEM)把“正演+灵敏度”压缩到一个可编译计算图中,其硬件画像为:GPU 负责批量张量与求导、显存决定问题规模上限、CPU 主频影响开发与前处理效率、float64 需求决定 GPU 档次。建议先以目标自由度规模与精度要求估算显存,再按“主流档(1—2 张 24—48 GB GPU)起步、预留第二卡位”的原则配置 UltraLAB 工作站;涉及百万自由度三维反问题或大批量 UQ 时再上高性能档。
参考来源
- Learning to Optimize by Differentiable Programming. arXiv:2601.16510。https://arxiv.org/abs/2601.16510
- A Differentiable Framework for Gradient Enhanced Damage with Physics-Augmented Neural Networks in JAX-FEM. arXiv:2604.03411。https://arxiv.org/abs/2604.03411
- JAX-FEM 开源项目。https://github.com/tianjuxue/jax-fem
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



