






内容摘要(TL;DR):2026年10月巴黎旺多姆广场骚乱中,LV门店的中国产防爆玻璃在暴徒轮番重击下"裂而不穿",让河南恒鑫丰这家隐形冠军一夜出圈。本文从工程角度拆解防爆玻璃的多层夹胶钢化材料组成,系统梳理其抗冲击设计背后的显式动力学核心算法(JH-2 脆性本构、PVB 黏弹性模型、Cohesive 层间脱粘、FEM-SPH 耦合)及其计算特点,并给出冲击/爆炸仿真的软件清单与 UltraLAB 图形工作站三档硬件配置选型方案,附常见问题硬件配置分析 FAQ。
关键词:防爆玻璃、防弹玻璃、PVB 夹胶玻璃、材料组成分析、LS-DYNA、显式动力学、Johnson-Holmquist 本构、冲击仿真、爆炸仿真、UltraLAB 工作站、CAE 硬件配置
目录
- 热点回顾:一场骚乱砸出的"中国玻璃"
- 防爆玻璃材料组成分析:为什么"裂而不穿"
- 核心算法与计算特点:防爆玻璃背后的仿真科学
- 典型应用场景
- 仿真软件清单
- UltraLAB 硬件配置怎么选
- 常见问题:硬件配置分析 FAQ
- 结语
一、热点回顾:一场骚乱砸出的"中国玻璃"
2026年10月17日,巴黎旺多姆广场。六名蒙面暴徒抬起沉重的道路围栏,轮番猛撞 LV 门店橱窗。连续重击之下,玻璃只布满蛛网状裂纹,始终没有被撞穿;而同一片广场的格拉夫珠宝店橱窗被直接砸穿,店内贵重珠宝被洗劫一空。一墙之隔,两种结果。
这段视频在全球社交平台刷屏后,中国外交官张和清公开发声,点明这块防护玻璃产自中国河南——河南恒鑫丰安防科技,一家扎根平顶山高新区二十年的企业。它的防爆炸复合玻璃早年入选国家火炬计划,防爆性能指标高于美国军用标准,国内大量银行、珠宝店的安防玻璃都出自它家。
市场反应快得惊人:
| 事件指标 | 数据 |
|---|---|
| 全法遭打砸抢商户 | 超过 3,000 家 |
| 保险业预估赔付额 | 10~12 亿欧元 |
| "安防钢化玻璃"关键词搜索量涨幅(事发一周内) | +320% |
| 恒鑫丰海外咨询量 | 数日内翻数倍,订单意向排到数月后 |
欧洲商户过去选橱窗玻璃优先看成本,这场骚乱直接击穿了所有人的心理预期。而支撑这块玻璃"扛住"的,不是运气,是材料组成设计与仿真验证的硬功夫——这正是本文要拆解的核心。
为什么是软文也要讲算法?防爆玻璃"裂而不穿"的效果原理简单,量产门槛却极高:胶膜配比、钢化应力、层间贴合度差一丝一毫,抗冲击能力就大打折扣。这些参数的确定,靠的不是试错,而是显式动力学仿真——而仿真的效率,直接取决于你的计算硬件。
二、防爆玻璃材料组成分析:为什么"裂而不穿"
防爆(防弹/防爆炸)复合玻璃的本质是一套多层夹胶钢化复合结构:外层玻璃碎裂吸能后,碎片被中间的高分子胶膜牢牢粘住,整扇玻璃依然卡在框架里纹丝不动。
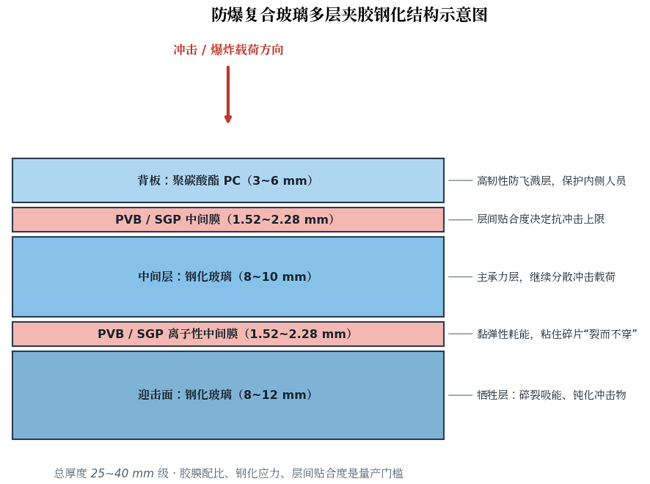
图 1|防爆复合玻璃多层夹胶钢化结构示意(总厚度 25~40 mm 级)
2.1 各层材料组成与功能
| 层级 | 材料 | 典型厚度 | 核心功能 | 关键物性 |
|---|---|---|---|---|
| 迎击面 | 钢化玻璃 | 8~12 mm | 牺牲层:碎裂吸能、钝化/碎裂冲击物 | 弹性模量 ≈72 GPa,密度 ≈2,500 kg/m³,表面压应力 ≥90 MPa |
| 中间膜 ① | PVB / SGP 离子性中间膜 | 1.52~2.28 mm | 黏弹性耗能,粘住碎片"裂而不穿" | SGP 撕裂强度约为普通 PVB 的 5 倍,承载力约 2 倍 |
| 承力层 | 钢化玻璃 | 8~10 mm | 主承力层,分散残余冲击载荷 | 同上,钢化应力均匀性是关键 |
| 中间膜 ② | PVB / SGP 中间膜 | 1.52~2.28 mm | 层间贴合度决定抗冲击上限 | 层间剪切粘结强度、剥离强度 |
| 背板 | 聚碳酸酯(PC) | 3~6 mm | 高韧性防飞溅层,保护内侧人员 | 断裂伸长率 >100%,抗冲击韧性极高 |
2.2 量产工艺的三大门槛
- 胶膜配比与选型:PVB 增塑剂含量、SGP 离子交联度直接决定黏弹性耗能曲线的形状;
- 钢化应力控制:表面压应力不足则首层过早贯穿,应力不均则产生自发裂纹源;
- 层间贴合度:高压釜温度-压力-时间曲线偏差会导致界面气泡与脱粘,抗冲击能力直线下降。
2.3 主流防护等级标准对照
| 标准体系 | 标准号 | 适用场景 | 典型分级思路 |
|---|---|---|---|
| 中国公共安全标准 | GA 165-2016《防弹透明材料》 | 银行、岗亭、运钞车 | 按防枪弹类型分级(如防 79 式轻型冲锋枪) |
| 美国保险商实验室 | UL 752 | 商业安防、司法建筑 | Level 1~8,按枪械威力递进 |
| 欧洲标准 | EN 1063 | 建筑玻璃防弹 | BR1~BR7,含飞溅(S/NS)判定 |
| 防爆冲击波 | ASTM F1642 / ISO 16933 | 爆炸冲击波防护 | 按峰值压力与冲量划分危险等级 |
三、核心算法与计算特点:防爆玻璃背后的仿真科学
防爆玻璃的抗冲击设计高度依赖显式动力学数值仿真——把"暴徒抡围栏砸玻璃""爆炸冲击波扫过幕墙"这类微秒~毫秒级强非线性瞬态事件,搬进计算机里反复推演,用仿真替代昂贵的破坏性试验。
3.1 涉及的五大核心算法
| 算法模块 | 具体算法/模型 | 在防爆玻璃仿真中的作用 | 计算特点 |
|---|---|---|---|
| 时间积分 | 显式中心差分法 | 逐时间步推进冲击波传播与裂纹扩展全过程 | 时间步极小(亚微秒级),单步量适中但总步数高达数百万步 |
| 玻璃脆性本构 | Johnson-Holmquist(JH-1/JH-2)损伤模型 | 描述玻璃在高压、高应变率下的强度退化与碎裂 | 状态变量多、逐单元损伤判据,对缓存与主频高度敏感 |
| 胶膜黏弹性 | 广义 Maxwell / Mooney-Rivlin 超弹性 + Prony 级数 | 刻画 PVB/SGP 的率相关耗能与粘结行为 | 卷积积分历史项增加内存占用与带宽压力 |
| 层间脱粘 | Cohesive Zone Model(CZM)内聚力单元 | 模拟玻璃-胶膜界面的分层、剥离与碎片附着 | 大量接触面对与内聚单元,是显式计算主要耗时来源之一 |
| 爆轰与流固耦合 | SPH 粒子法 / ALE 任意拉格朗日-欧拉 / FEM-SPH 耦合 | 模拟 TNT 爆轰波、玻璃碎片的飞溅抛撒 | 粒子-网格交互搜索密集,通信与 I/O 开销显著 |
3.2 计算特点总结:为什么这类仿真"挑硬件"
| 维度 | 特征分析 |
|---|---|
| 计算特征 | 时间步极小(微秒级),单步计算量适中但总步数巨大;单元、本构与接触计算对内存带宽、L3 缓存、主频敏感 |
| 并行方式 | SMP(共享内存)适合单机小模型(经验约 8 核内);MPP(MPI 区域分解)扩展到数十~数百核;更大规模用 HYBRID 混合并行 |
| 扩展规律 | 每 MPI rank 至少约 1~2 万单元才能摊薄通信开销;1,000 万单元模型超过约 500 rank 通常收益递减——核心数必须与模型规模匹配 |
| 内存需求 | 显式单进程内存中等(每 rank 约 1~2 GB 起步),总需求随单元数、黏弹性历史变量与输出设置增长 |
| I/O 特点 | d3plot 类结果文件按间隔写出,大模型单次输出可达数十 GB;NVMe 本地 scratch 可显著降低多 rank 写出争用 |
| GPU 适用性 | 显式求解主线靠 CPU 并行;GPU 能力集中在隐式等特定路径且有版本与许可限制——不要默认"有 GPU 就更快" |
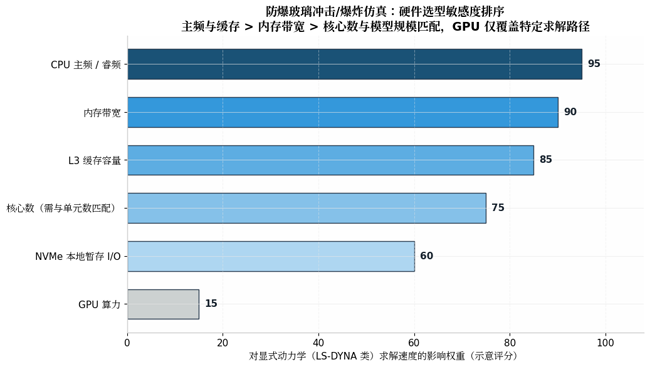
图 2|显式动力学仿真硬件敏感度排序(示意评分):选型优先级为"主频与缓存 > 内存带宽 > 核心数与模型匹配"
四、典型应用场景
| 场景 | 防护对象 | 典型仿真工况 | 模型规模量级 |
|---|---|---|---|
| 银行 / 珠宝店 / 奢侈品门店 | 暴力砸击、枪击 | 重锤/钝器反复冲击、弹击 | 零部件级:10~100 万单元 |
| 使馆、政府要地建筑幕墙 | 爆炸冲击波 | TNT 当量-爆距扫描、碎片飞溅 | 系统级:100 万~3,000 万+ 单元 |
| 警用装备(盾牌、岗亭、观察窗) | 弹击与破片 | 多弹道角 DOE 批量计算 | 零部件级批量算例 |
| 汽车 / 轨道交通风挡 | 飞石、碰撞、鸟撞 | 高速冲击 + 行人保护耦合 | 系统级 |
| 数据中心 / 实验室泄爆外墙 | 内部爆炸泄压 | 压力-冲量谱下的整体响应 | 系统级 + 流固耦合 |
法规工况与 DOE 优化通常需要几十至上百个算例批量提交——吞吐能力(并行算例数)与单算例速度同样重要,这直接决定了硬件配置的取舍。
五、仿真软件清单
| 类别 | 软件 | 说明 | 必需/可选 |
|---|---|---|---|
| 显式求解器 | Ansys LS-DYNA(SMP/MPP/HYBRID,单/双精度) | 碰撞、冲击、穿甲类显式动力学行业标准求解器,含 JH-2 玻璃本构与丰富炸药库 | 必需 |
| 显式求解器 | Altair RADIOSS / Abaqus Explicit / ESI PAM-CRASH | 同类显式求解器,按团队技术栈选用 | 可选替代 |
| 爆炸专项 | ANSYS AUTODYN | 爆轰、破片、流固耦合专项 | 可选 |
| 前处理 | ANSA、HyperMesh、LS-PrePost | 多层结构网格、内聚单元、接触与工况定义 | 必需(至少一款) |
| 后处理/可视化 | LS-PrePost、HyperView、Animator | d3plot 结果分析、裂纹与脱粘云图 | 必需(至少一款) |
| 运行环境 | Windows / Linux + MPI 运行库(随发行包) | MPP 并行运行基础 | 必需 |
| 自动化 | Python(后处理脚本)、Oasys PRIMER | 批量算例提交与报告自动化 | 可选 |
六、UltraLAB 硬件配置怎么选
防爆玻璃冲击/爆炸仿真的选型逻辑一句话概括:先按模型单元数确定合理 MPI rank 数(每 rank ≥ 约 1~2 万单元),再在预算内优先保证主频、缓存与内存带宽,最后配置 NVMe scratch 与充足归档容量。 许可证层面 SMP/MPP 及核心数授权会限制可用并行规模,采购前务必与软件供应商核实授权方式。
6.1 UltraLAB 图形工作站三档配置推荐
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 存储(系统/项目/数据) | 散热/电源 | 适用场景 |
|---|---|---|---|---|---|---|
| 入门级 | 高主频 8~16 核 CPU,重视单核性能与大缓存 | 64~128 GB | 中端 GPU 用于前/后处理可视化 | 1 TB NVMe 系统盘 + 2 TB NVMe 项目盘 | 静音塔式,850 W | 零部件级玻璃试样模型、SMP/小规模 MPP、教学与算法验证 |
| 主流级 | 高主频 24~48 核工作站 CPU,多内存通道满插 | 128~256 GB ECC | 中端 GPU 辅助可视化 | 1 TB NVMe + 4 TB NVMe 项目盘(本地 scratch)+ HDD 归档 | 强风道,1,200 W+ | 百万~千万级单元 MPP、多工况批量计算(整窗/幕墙构件级) |
| 高性能级 | 双路高主频平台(64~128 核级),全通道满插 | 256~512 GB ECC | 按需配置可视化 GPU | 2 TB NVMe 系统 + 8 TB+ NVMe(RAID,本地 scratch) | 机架式、冗余电源、持续满载散热 | 千万级单元系统模型、爆炸流固耦合、大批量 DOE、多用户共享 |
6.2 模型规模与核心数匹配速查表
| 模型单元数 | 建议 MPI rank 数(每 rank ≥1~2 万单元) | 推荐档位 |
|---|---|---|
| ≤ 20 万 | 8~16 核(SMP 即可) | 入门级 |
| 20 万 ~ 100 万 | 16~48 核 MPP | 主流级 |
| 100 万 ~ 1,000 万 | 48~128 核 MPP/HYBRID | 主流级 ~ 高性能级 |
| 1,000 万 ~ 3,000 万+ | ≤ 约 500 rank,超此收益递减 | 高性能级或评估多节点集群 |
6.3 升级路径建议
- 单算例加速:优先提升主频/缓存与内存带宽,核对每 rank 单元数是否落入高效区间;
- 批量吞吐:优先增加整机数量或核心数,按算例拆分并行提交;
- I/O 瓶颈:配置 NVMe 本地 scratch(用 pfile 指定),优化输出间隔,官方资料称视 rank 数与文件系统速度可带来 1~5% 的改进;
- 更大规模(数千万单元以上或整车/整楼多工况并行):建议评估多节点 MPP 集群而非继续堆单机。
七、常见问题:硬件配置分析 FAQ
Q1:防爆玻璃冲击仿真需要多大内存?显式单进程内存需求中等,MPP 脚本常以每 rank 1~2 GB 起步。但防爆玻璃模型含黏弹性历史变量、内聚单元与大量接触面对,总需求随单元数与输出设置明显增长:零部件级(≤100 万单元)建议 64~128 GB;千万级单元或 FEM-SPH 耦合建议 256~512 GB ECC,且务必满通道满插以保证带宽。Q2:核心数是不是越多越好?不是。官方经验规则为每 MPI rank 至少约 1~2 万单元:1,000 万单元模型跑到 500 rank 以上通常收益递减,通信开销反而拖慢计算。核心数应与模型规模匹配,或通过 HYBRID/欠订阅提高利用率——这也是"先定模型规模、再选档位"的原因。Q3:SMP 和 MPP 两种并行模式怎么选?SMP(共享内存)适合约 8 核以内的小问题,无需 MPI 环境、部署简单;更大规模用 MPP(MPI 分布式内存),按 rank 分配内存,扩展性更好;超大规模可用 HYBRID(MPI+OpenMP)降低通信与内存压力。Q4:GPU 能加速 LS-DYNA 这类显式求解吗?显式主线的加速主要靠 CPU 并行;GPU 能力集中在隐式等特定求解路径,且有版本与许可限制。GPU 在本流程中的主要价值是前处理建模与大模型后处理可视化。采购前请以软件厂商当期文档与许可证说明为准,不要默认"有 GPU 就更快"。Q5:为什么同样的核心数,不同机器速度差很多?显式求解对主频、L3 缓存、内存带宽与延迟敏感。官方资料明确推荐高主频、大三缓、高带宽平台并建议开启睿频——仅比较核心数会误判性能。这正是 UltraLAB 工作站以"高主频 + 大缓存 + 满通道内存"为显式动力学平台设计主线的原因。Q6:磁盘对计算速度有影响吗?单机还是集群?有。多 rank 并发写出 d3plot 时,网络文件系统争用会拖慢计算,建议用 pfile 指定 NVMe 本地 scratch 并减少不必要的文件写出。单机高性能档可覆盖千万级单元与批量 DOE;数千万单元以上或整栋幕墙多工况并行,建议评估多节点 MPP 集群。八、结语
法国的骚乱是一场城市灾难,却意外成了中国玻璃的全球质检现场。恒鑫丰们"一夜爆红"的背后,是二十年泡在车间里调参数、做测试的硬功夫——胶膜配比、钢化应力、层间贴合度这三个量产门槛,每一个都对应着 JH-2 本构标定、黏弹性耗能曲线拟合与 Cohesive 界面参数的反复仿真迭代。
对正在进入或升级安防玻璃赛道的制造企业而言,把"材料配方—仿真验证—试验标定"的闭环跑通,离不开一套匹配模型规模的计算平台:主频与缓存优先、内存带宽次之、核心数与单元数匹配,辅以 NVMe 本地 scratch——这正是 UltraLAB 图形工作站三档配置方案的设计逻辑。
获取专属配置方案:如果您正在开展防爆玻璃、防弹复合材料或抗爆结构的显式动力学仿真,欢迎联系 UltraLAB 高性能计算方案中心,提供您的典型模型单元数与软件栈,获取一对一的工作站/集群选型建议。
参考来源
- 今日头条:《不仅法国人没想到,可能连中国人也没想到,法国的骚乱还把中国玻璃公司给托起来了》——https://m.toutiao.com/is/_nYqremevZQ/
- UltraLAB 图形工作站方案网站:《LS-DYNA 显式动力学并行计算:SMP/MPP 模式选择与工作站硬件配置要点》——../..//article/86/3990.html
- Ansys HPC Day: Maximize LS-DYNA MPP Performance;University of Leeds ARC Documentation: LS-DYNA
标签:#防爆玻璃 #中国制造 #法国骚乱 #恒鑫丰 #材料仿真 #LS-DYNA #显式动力学 #UltraLAB #工作站选型 #CAE
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



