






——从微型拦截器关键技术,到 UltraLAB 配置全攻略
摘要:针对"低、慢、小"无人机与巡飞弹的微型拦截器,正在把"高速穿越机 + 火箭式流线外壳 + 机载 AI 视觉"组合成低成本点防御方案。公开资料显示,这类系统的竞争力一半在弹上技术,另一半在研发效率——气动外形迭代、飞控参数整定、AI 识别训练,每一环都是算力密集型工作。本文基于公开技术文章拆解拦截系统的核心技术栈与计算特点,并回答研发团队最关心的问题:从概念设计到外场试验,本地算力到底该怎么配?
目录
- 核心内容应用分析:拦截系统技术体系解读
- 主要核心算法:从气动仿真到机载视觉
- 计算特点:研发流水线"吃"什么硬件
- UltraLAB 硬件配置怎么选:四档方案
- 软件清单:从 CFD 到边缘部署
- 应用场景:点防御的战场与研发布局
- 大模型本地部署:保密环境的智能助手
- 常见问题:硬件配置避坑分析
一、核心内容应用分析:拦截系统技术体系解读
1.1 系统定位
| 维度 | 要点(据原文) |
|---|---|
| 目标 | "低、慢、小"无人机、FPV、巡飞弹 |
| 追求 | 低成本、短反应时间、低附带损伤 |
| 本质 | 高速穿越机套上火箭式流线外壳:四轴电动 FPV,动力为无刷电机,以动能撞击为主 |
| 速度区间 | 外壳针对 200–400 km/h 高速平飞优化 |
| 续航 | 通常仅 3–8 分钟,适合近程点防御 |
| 成本量级 | 整机几千元人民币级(真实微型火箭弹为几万至几十万) |
| 制导模式 | FPV 人工操控 / 机载 AI 辅助自动拦截(后者为工程化主流) |
1.2 技术体系三大块 + 系统级配套(原文框架)
| 板块 | 关键技术点 | 研发算力需求映射 |
|---|---|---|
| ① 气动与结构改造 | 圆锥机头+圆筒机身减阻;3D 打印 PETG/碳纤维薄壳;桨叶半埋/后置降抖振;推重比 ≥2.5–3、6–12S 高压动力;机臂加强抗扭 | 外流场 CFD(高速姿态/俯仰力矩)、模态与振动 FEA、拓扑优化、3D 打印工艺仿真 |
| ② 飞控与高速控制 | Betaflight 花飞参数不适用,须针对高速前飞重新整定;抑制俯仰振荡;FPV 图传减震抗"果冻";接入雷达/射频引导坐标;GPS 受压制时 IMU+气压计姿态保持 | SIL/HIL 半实物仿真、批量蒙特卡洛打靶、控制参数寻优 |
| ③ 感知与导引 | 模式 A 纯人工 FPV;模式 B 机载 AI 视觉:板载边缘计算、可见光/低照度识别、过滤飞鸟建筑虚警、自动跟踪逼近;可选轻量化热成像夜战 | 小目标检测模型训练、多目标跟踪、数据标注与增广、端侧量化部署 |
| 系统级配套 | 前端探测(雷达/射频测向/光电);火控与任务分配(多机协同反蜂群);消费级供应链控成本 | 传感器数据融合仿真、体系对抗推演仿真 |
1.3 原文给出的"与真实微型火箭弹对比"与工程痛点
| 项目 | 火箭造型 FPV 拦截无人机 | 真实微型火箭弹 |
|---|---|---|
| 动力 | 电动无刷电机 + 电池 | 固体火箭发动机 |
| 制导 | FPV 人工 / 机载 AI 视觉,无近炸引信 | 导引头 + 近炸引信自动制导 |
| 成本 | 几千元级 | 几万至几十万 |
| 机动 | 旋翼改变姿态 | 弹翼舵机 |
| 弱点 | 大风性能差、远距离发现难 | 成本高、供应链封闭 |
五大工程痛点(原文总结):① 高速姿态震荡、飞控调参难度远高于普通穿越机;② 自身不能远距离搜索目标,强依赖外部雷达/射频引导;③ 人工拦截极度依赖飞手,AI 在逆光、云层、复杂地物下虚警高;④ 高速图传果冻与震动干扰;⑤ 电池能量有限,续航 3–8 分钟。
1.4 对研发团队的三点启示
- 迭代速度就是战斗力:几千元级的成本结构意味着"快速试错、批量打样",气动外形与飞控参数的每一轮迭代都依赖仿真先行——研发算力的响应速度直接决定型号迭代周期。
- AI 视觉是最大软件变量:原文明确"AI 识别在逆光、云层、复杂地物下虚警高",这本质上是一个数据与训练问题——需要大量真实外场视频数据回流、持续再训练,训练算力与数据管理是长期投入。
- 系统级仿真不可缺席:原文直言"很多项目失败不是飞机不行,是系统级配套缺失"——探测-引导-拦截全链路仿真与多机协同推演,需要独立于单机研发的体系化仿真环境。
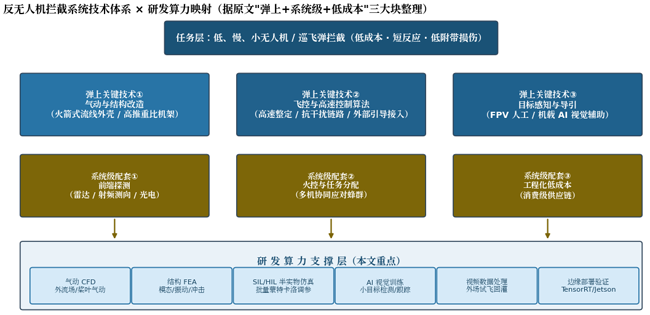
图 1 拦截系统技术体系 × 研发算力映射。上两层是原文技术框架,底层是本文聚焦的研发支撑层。
二、主要核心算法:从气动仿真到机载视觉
以下按研发流水线的六个环节梳理各环节核心算法,其中前两类为原文明确提及的工程难点,其余为该领域公认的实现路径。
2.1 六环节核心算法对照表
| 环节 | 核心算法/方法 | 解决什么问题 | 计算形态 |
|---|---|---|---|
| 气动 CFD | RANS 湍流模型(k-ω SST);动量源法/MRF 模拟旋翼;重叠网格/滑移网格处理桨-身干扰;高速姿态下俯仰力矩提取 | 火箭构型 200–400 km/h 下的阻力、力矩、抖振特性;桨半埋/后置布局比选 | CPU 密集,瞬态计算量大 |
| 结构 FEA | 模态分析(防共振);瞬态冲击/跌落;拓扑优化 + 3D 打印工艺仿真(PETG/薄壳) | 机臂抗扭加强、薄壳减重、高速颤振规避 | CPU+内存带宽敏感 |
| 飞控仿真 | 串级 PID 整定;LQR/模型预测备选;EKF 姿态融合(无 GPS 时 IMU+气压计);增益调度 | 高速前飞俯仰振荡抑制;抗 GPS 压制;大角度俯冲/急转跟踪 | 轻量单核快、批量多开 |
| SIL/HIL 仿真 | 蒙特卡洛打靶;六自由度弹道解算;传感器噪声/延迟建模 | 调参覆盖率、拦截成功概率统计、边界工况摸底 | CPU 多开密集型 |
| AI 视觉 | YOLOv8/RT-DETR 小目标检测;ByteTrack/DeepSORT 跟踪;低照度增强、去雾去抖;可见光+热成像多模态融合 | 过滤飞鸟/建筑虚警;逆光/夜间识别;锁定后自动跟踪逼近 | GPU 训练密集 |
| 系统级融合 | 多传感器航迹关联;目标分配优化(拍卖算法/匈牙利算法);蜂群拦截推演 | 多机协同任务分配;雷达/射频/光电信息融合 | 仿真+优化混合 |
2.2 原文关键细节对算法的约束
- Betaflight 需重新整定:开源飞控默认面向花飞,火箭构型高速平飞必须重做增益调度——这意味着 SIL 仿真环境要覆盖 0–400 km/h 全速域,蒙特卡洛规模随之放大;
- AI 工程化主流是"飞手锁定 + 自动跟踪逼近":人机分工决定了检测模型只需输出目标框与置信度,跟踪与逼近由飞控闭环完成——训练重点在小目标召回率与复杂背景虚警抑制;
- 外部引导 + 末端自主:雷达/射频把拦截机引导到几百米内再交视觉,等价于给 AI 做了一个"感兴趣区域预筛",大幅降低了搜索空间——研发仿真中也应复现这条链路,避免端到端硬啃。
三、计算特点:研发流水线"吃"什么硬件
3.1 六环节负载拆解
| 环节 | 主要任务 | 计算特征 | 时间占比(典型) | 首要硬件瓶颈 | 次要瓶颈 |
|---|---|---|---|---|---|
| ① 气动 CFD | 外形迭代、姿态力矩数据库 | CPU 密集、内存带宽敏感;瞬态算例步数多 | 25–35% | CPU 核数 + 满通道内存 | 授权核数 |
| ② 结构 FEA | 模态/冲击/拓扑优化 | CPU+内存敏感;拓扑优化迭代轮次多 | 10–15% | 内存容量 + 带宽 | 核数 |
| ③ SIL/HIL 仿真 | 飞控整定蒙特卡洛 | 单核轻量、多开吞吐型;数千次打靶 | 20–30% | CPU 核数 | 高主频(单次时长)、内存 |
| ④ AI 视觉训练 | 检测/跟踪模型训练 | GPU 密集;大分辨率 + mosaic 增强吃显存;数据集反复读盘 | 20–30% | 单卡显存容量 | 存储 I/O、内存 |
| ⑤ 视频数据处理 | 外场试飞视频解码、抽帧、标注、增广 | I/O 密集、CPU 解码密集;单架次数百 GB | 5–10% | NVMe 存储带宽 + CPU 解码 | 内存 |
| ⑥ 边缘部署验证 | 量化、剪枝、端侧推理回归 | GPU 轻量、迭代频繁 | < 5% | 显存带宽 / 推理引擎 | CPU 编译 |
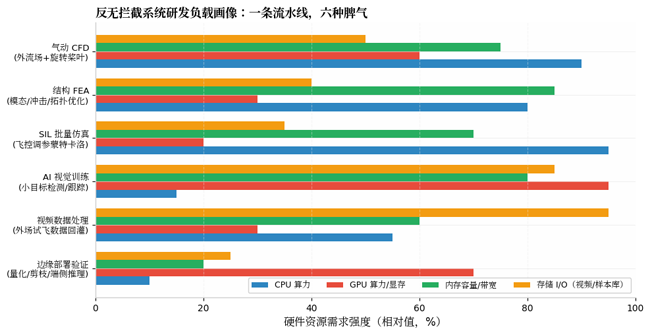
图 2 研发流水线负载画像。结论:这类团队是"CPU 吞吐 + GPU 单卡显存"的双高需求,存储带宽是被低估的第三变量。
3.2 区别于通用研发团队的三个硬件要点
- 蒙特卡洛 SIL 仿真是"隐形吞核兽":一次调参 campaign 动辄数千次六自由度打靶,单核快不如核多——32–64 个并行仿真实例是常态,CPU 核数是吞吐量的线性杠杆,且此类负载几乎不吃 GPU。
- 小目标训练把显存推到 48GB 档:为了 200–400 km/h 相对速度下的远距离小目标,输入分辨率往往开到 1280×1280 甚至更高,配合 mosaic/copy-paste 增广,24GB 卡捉襟见肘,48GB 单卡才是从容之选;双模态(可见光+热成像)训练进一步推高显存与数据管线需求。
- 外场数据回流形成"存储-训练"闭环:单架次试飞视频数百 GB,频繁回灌工作站做抽帧、标注、再训练,机械盘会让 GPU 长时间空转——NVMe RAID 是体验分水岭;保密单位数据不出内网,全部本地化,更依赖单机存储与算力冗余。
3.3 配置逻辑对照表
| 维度 | 通用研发工作站思维 | 反无系统研发思维 |
|---|---|---|
| CPU | 够用即可 | 战略资源(SIL 多开 + CFD 并行,优先 32 核以上) |
| GPU | 单卡即可 | 单卡大显存优先;训练/验证/开发三路并发时考虑双卡 |
| 内存 | 64–128GB | 256–512GB(CFD/FEA 并行算例 + 视频数据集常驻) |
| 存储 | 容量为王 | 带宽为王(Gen4/Gen5 NVMe RAID,视频回灌秒级) |
| 形态 | 塔式 | 塔式(实验室)+ 便携机型(外场回灌/现场再训练) |
| 网络 | 忽略 | 万兆(视频库集中存储、模型分发) |
四、UltraLAB 硬件配置怎么选:四档方案
UltraLAB(西安坤隆计算机科技有限公司旗下品牌)面向 AI+CAE 仿真提供工作站/服务器/便携机型定制。以下按反无系统研发的团队阶段划分四档,具体型号与价格以官方在售配置为准。
4.0 选型三步法
- 定阶段:预研论证 / 型号研制 / 体系化建设 → 对应 ① / ②③ / ③;
- 算负载:每周 CFD 算例数 × 网格量级 → CPU 与内存;数据集规模 × 训练分辨率 → GPU 显存;
- 看环境:实验室静音塔式 / 机房机架 / 外场便携三形态按需组合。
4.1 四档配置总览
| 档位 | 典型机型 | 定位 | CPU | 内存 | GPU | 存储 | 参考预算 |
|---|---|---|---|---|---|---|---|
| ① 预研桌面级 | UltraLAB A330 级 | 方案论证、单机气动/结构仿真、AI 原型 | i9-14900K(24 核) | 128 GB DDR5 | RTX 4090/5090 24–32GB ×1 | 2TB NVMe + 8TB HDD | 3–5 万 |
| ② 型号研制专业级 | UltraLAB GT430P 级 | 拦截器型号研制全流水线 | Xeon W9-3495X(56 核,8 通道) | 512 GB DDR5 ECC | RTX 6000 Ada 48GB ×1–2 | 4TB NVMe RAID + 16TB HDD | 10–20 万 |
| ③ 体系化集群节点 | UltraLAB CA660 / GX660M 级 | 多型号并行 + AI 数据工厂 + 体系推演 | 双路 EPYC 9654(192 核)/ 双路 Xeon | 1–2 TB DDR5 ECC | RTX 6000 Ada/A100 ×4–8(NVLink) | 8TB Gen5 NVMe RAID + 集中存储 | 40–80 万/节点 |
| ④ 外场便携 / 超频定制 | UltraLAB 便携机型 + 超频定制 | 外场数据回灌、现场快速再训练;中小算例分钟级反馈 | 64 核全核超频 4.5GHz(液冷)/ 便携 24 核 | 512 GB–1 TB | 便携 2–4×RTX 4090 级 / 48GB | 4TB NVMe | 8–35 万 |
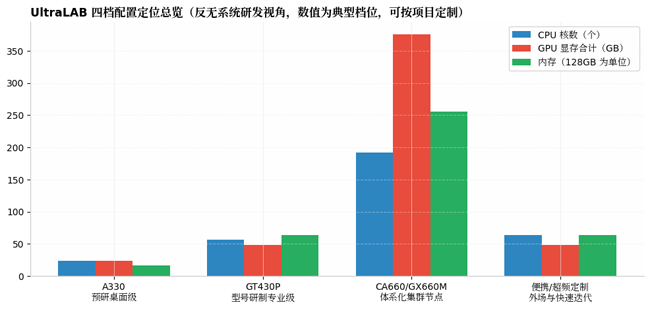
图 3 四档配置硬件画像。档位④首次引入便携形态——外场试验数据当天回灌、当晚再训练,是反无研发的独特节奏。
4.2 各档位详解与性能预期
档位 ① 预研桌面级(3–5 万)
- 适合:方案论证、课题组预研、AI 识别原型验证;
- 配置要点:24 核高主频 + 128GB 内存支撑千万级网格 CFD 与中小 FEA;24–32GB 显存可训 1280 分辨率 YOLO 小目标模型(batch 适度);
- 预期:单个外流场姿态算例 4–8 小时;YOLOv8m 中等数据集 1–2 天收敛一轮。
档位 ② 型号研制专业级(10–20 万)
- 适合:拦截器型号研制主力机——气动/结构/飞控/AI 四人小组共用;
- 配置要点:56 核 8 通道满配内存,同时并行 6–8 个 CFD 算例或 32–48 路 SIL 打靶;48GB 单卡从容应对 1280×1280 小目标训练与可见光+热成像双模态;NVMe RAID 支撑视频数据快速回灌;
- 预期:姿态力矩数据库周级更新;一次 5000 次蒙特卡洛调参 campaign overnight 完成;外场单架次视频当晚完成抽帧标注入库。
档位 ③ 体系化集群节点(40–80 万/节点)
- 适合:多型号并行研制、AI 数据工厂(多外场点数据集中训练)、体系级对抗推演;
- 配置要点:192 核 12 通道支撑 CFD/FEA/SIL 三类负载混部;多卡 NVLink 支撑大分辨率检测模型分布式训练与多任务并发;万兆/IB 接入集中存储,多外场站视频统一回流;
- 预期:万级蒙特卡洛统计置信度评估;十万级标注样本的持续迭代训练流水线。
档位 ④ 外场便携 / 超频定制(8–35 万)
- 适合:外场试验伴随保障(数据当天处理、模型现场再训练)、设计冲刺期高频迭代;
- 配置要点:多 GPU 便携机型把"数据回灌—标注—再训练"闭环从一周压到一天;超频液冷塔式让中小 CFD/FEA 算例提速约 30%,双冷排保 7×24 满载 < 75 ℃;
- 预期:外场当天产出新权重并回归验证;概念外形"当天改、当晚算、次日打样"。
4.3 UltraLAB 针对该类负载的定制能力
| 能力 | 说明 | 收益 |
|---|---|---|
| CPU 全核液冷超频 | 全核锁频超频 + 分体水冷 | SIL 单次仿真与中小算例提速 20–40% |
| 满通道内存 | EPYC 12 通道 / Xeon 8 通道插满 | 内存带宽 400 GB/s+,喂饱 CFD/FEA |
| 多 GPU 拓扑优化 | PCIe 通道分配、NVLink 按需配置 | 训练/验证/开发三路并发不抢带宽 |
| 高速存储 RAID | Gen4/Gen5 NVMe RAID 0/5/10 | 视频回灌与数据集加载从分钟级到秒级 |
| 便携多 GPU 机型 | 2–4 卡便携工作站 | 外场随行,数据不出场 |
| 静音/机架双形态 | 办公静音水冷(<35 dB)/ 2U/4U 机架 | 实验室与机房通吃 |
| ECC 全覆盖 | 内存 + 专业卡显存 ECC | 长周期训练与大量算例的数值可靠性 |
五、软件清单:从 CFD 到边缘部署
5.1 商业软件
| 软件 | 核心功能 | 在拦截系统研发中的角色 | 许可模式 |
|---|---|---|---|
| Ansys Fluent / CFX | 外流场 CFD、旋转机械(MRF/滑移网格) | 火箭构型气动外形与姿态力矩数据库 | 商业订阅(按核/ HPC) |
| Siemens Star-CCM+ | CFD + 多物理场 | 桨-身干扰、整机气动迭代 | 商业订阅 |
| XFlow(无网格 LBM) | 瞬态外流场 | 复杂火箭外形快速评估早期方案 | 商业订阅 |
| Ansys Mechanical / LS-DYNA | 结构模态、冲击动力学 | 机臂抗扭、撞击工况、跌落 | 商业订阅 |
| Altair HyperWorks / OptiStruct | 拓扑优化、轻量化 | 薄壳结构减重设计 | 商业订阅 |
| MATLAB / Simulink | 控制设计、六自由度仿真、数据融合 | 飞控律设计、SIL 框架、航迹融合算法 | 商业订阅 |
| nTopology | 3D 打印结构设计 | PETG 薄壳点阵与工艺设计 | 商业订阅 |
5.2 开源与自研工具链
| 类别 | 工具 | 用途 |
|---|---|---|
| CFD 开源 | OpenFOAM、SU2 | 外流场算例扩展、批量姿态扫描 |
| 飞控固件 | Betaflight / ArduPilot / PX4(含 SITL) | 飞控二次开发与软件在环仿真 |
| 仿真环境 | Gazebo、AirSim、FlightGear | 视觉-动力学联合仿真、合成数据生成 |
| AI 框架 | PyTorch 2.x、ultralytics(YOLOv8/11)、MMDetection、RT-DETR | 小目标检测训练主力 |
| 跟踪算法 | ByteTrack、DeepSORT、BoT-SORT | 锁定目标后的稳定跟踪 |
| 数据标注 | CVAT、Label Studio、Roboflow | 视频抽帧标注、多人协作质检 |
| 图像增强 | OpenCV、FFmpeg、Real-ESRGAN 类超分 | 低照度增强、去雾去抖、数据增广管线 |
| 边缘部署 | TensorRT、NCNN、OpenVINO、JetPack SDK | 板载 AI 模块量化部署与回归验证 |
| 中间件 | ROS 2 | 多传感器仿真与数据回放 |
| 系统层 | Ubuntu 22.04/24.04、CUDA 12.x、Docker+NVIDIA Container Toolkit | 环境标准化,训练/部署环境隔离 |
5.3 推荐软件组合(按档位)
| 档位 | 仿真侧 | AI 侧 | 部署侧 |
|---|---|---|---|
| ① | OpenFOAM / XFlow(试用)+ Simulink | PyTorch + YOLOv8 + CVAT | ONNX Runtime / NCNN |
| ② | Fluent/Star-CCM+ + Mechanical + Simulink | ultralytics + ByteTrack + 自建增广管线 | TensorRT + Jetson 实机回归 |
| ③ | 商业 CFD HPC + 集群版开源求解器 | 分布式训练 + 数据版本管理(DVC) | Triton 推理服务 + 多机型回归平台 |
六、应用场景:点防御的战场与研发布局
| 场景 | 需求特征 | 对应研发负载 | 推荐档位 |
|---|---|---|---|
| 要地近程点防御(机场、电站、油库、指挥所) | 固定阵地、持续值守、低成本拦截 | 型号定型 + 持续数据迭代训练 | ②③ |
| 重大活动低空安保 | 临时部署、快速构建、城市复杂背景 | 城市背景虚警抑制专项数据集训练 | ② + 便携④ |
| 反蜂群拦截 | 多目标同时来袭、多机协同分配 | 体系推演仿真 + 火控分配算法验证 | ③ |
| 机动伴随防空 | 随队机动、外场环境多变 | 外场数据回灌 + 现场再训练闭环 | ④为主 |
| 夜间/低照度防御 | 全天候值守需求 | 热成像多模态融合训练 | ②③ |
| 边海防哨所 | 无人值守、远端回传 | 边缘端轻量化 + 中心节点集中训练 | ③ + 便携④ |
| 靶场试验与鉴定 | 密集试飞、海量视频 | 视频数据工厂 + 蒙特卡洛效能评估 | ③ |
| 院校/预研论证 | 低成本起步、方法验证 | 单机仿真 + AI 原型 | ① |
原文强调的"系统级配套"(探测、火控、成本)提醒我们:拦截系统的效能评估必须在体系仿真环境中完成,单机性能只是入场券。
七、大模型本地部署:保密环境的智能助手
低空防御研发涉及大量不宜出网的资料(试验数据、型号文档、演训记录),公网大模型不可用,本地部署是唯一选项。拦截系统研发的大显存 GPU 工作站可"一机两用":白天跑仿真与训练,并发承载本地大模型——文档智能问答、代码助手(飞控固件/训练脚本)、试验报告自动生成、目标特征知识库检索。
7.1 显存需求速查表
| 模型规模 | FP16 权重 | INT8 | INT4 (Q4) | 建议最低 GPU 配置 | 推荐 UltraLAB 档位 |
|---|---|---|---|---|---|
| 7B–8B | ~16 GB | ~10 GB | ~6 GB | RTX 4090/5090 24–32GB 单卡 | ① |
| 14B | ~28 GB | ~16 GB | ~10 GB | 24–32GB 单卡(Q4)/ 48GB 单卡 | ①② |
| 32B | ~64 GB | ~36 GB | ~22 GB | 48GB 单卡(Q4) | ② |
| 70B–72B | ~140 GB | ~76 GB | ~42 GB | 2×48GB 或 96GB 单卡(Q4–Q8) | ③ |
| 满血 DeepSeek-R1 671B | — | — | ~380 GB | 8×80GB 级服务器 + 张量并行 | ③集群 |
经验公式:Q4 显存 ≈ 参数量 × 0.6 GB/十亿参数 + KV Cache 余量;长文档(型号报告动辄数百页)建议预留 20–30% 显存余量。
7.2 部署软件栈
| 层 | 推荐 | 备注 |
|---|---|---|
| 推理框架 | vLLM / TensorRT-LLM / llama.cpp | 多人并发问答选 vLLM |
| 量化 | AWQ / GPTQ / GGUF Q4 | Q4 几乎无损,优先体验 |
| RAG 前端 | Dify / Open WebUI + 内部文档向量库 | 型号文档、试验规程知识库问答 |
| 容器 | Docker + NVIDIA Container Toolkit | 与涉密仿真/训练环境隔离 |
八、常见问题:硬件配置避坑分析
8.1 FAQ(含硬件配置分析)
| # | 问题 | 分析与建议 |
|---|---|---|
| 1 | CFD 和 SIL 仿真都吃 CPU,先满足谁? | 两者可错峰:CFD 夜间批算、SIL 白天多开。预算内优先核数 + 满通道内存(档位②的 56 核 8 通道是甜点),必要时 CFD 用 HPC 云补充峰值。 |
| 2 | 小目标检测训练 24GB 够不够? | 1280×1280 输入 + mosaic 增广 + 双模态,24GB 需要频繁调小 batch,收敛质量和速度都受损;48GB 单卡是舒适线。两张 24GB 卡不如一张 48GB(小目标训练单卡放得下,避免通信开销)。 |
| 3 | 多模态(可见光+热成像)训练有什么讲究? | 双路输入使 batch 显存与数据管线翻倍,且红外数据集通常远小于可见光——先做模态对齐与共享 backbone 设计,再上硬件;数据侧建议 NVMe RAID,否则加载成为瓶颈。 |
| 4 | 外场数据当天回灌需要什么配置? | 视频解码抽帧是 CPU+I/O 密集负载:便携机型建议 16 核以上 + 多 NVMe(4TB 起)+ 万兆接口;理想节奏是"白天飞、傍晚灌、晚上训、次日回归"。 |
| 5 | 边缘端(机载)部署和训练端如何衔接? | 训练端导出 ONNX → TensorRT/NCNN 量化 → 在带同款 Jetson 的开发机上回归精度;建议工作站保留一张与机载算力同代的验证卡/开发套件,避免"训练很好、上机掉点"。 |
| 6 | SIL 蒙特卡洛仿真需要 GPU 吗? | 基本不需要。六自由度打靶是轻量数值积分,多开并行才是关键:56 核可同时跑 40+ 实例。把钱花在核数与内存上,GPU 让给 AI 训练。 |
| 7 | 仿真软件授权和硬件怎么匹配? | 商业 CFD/FEA 按核授权,买的核数超过授权会导致算例排队或违规;下单前先盘点 license 的 HPC 核数上限,让 UltraLAB 按"授权核数+余量"配 CPU,避免硬件闲置。 |
| 8 | 视频数据存不下、找不回怎么办? | 架次视频原始数据只进一次:回灌即抽帧转样本(JPEG/序列帧),原始视频冷备大容量 HDD;标注数据用 DVC 做版本管理。热数据全 NVMe,拒绝用机械盘当工作盘。 |
| 9 | 保密单位如何做到数据不出内网? | 全本地闭环:本地训练 + 本地大模型 + 内网代码仓库(GitLab);外场便携机数据加密盘回灌;物理断网调试 AI 模块。UltraLAB 全系列支持离线部署与国产 OS 适配。 |
| 10 | 预算有限,第一台机器怎么配? | 档位②优先——它是唯一能让"气动+结构+SIL+AI"四条线同时跑起来的配置;若预算压到 5 万内,选档位①并聚焦"AI 原型 + 开源 CFD",CFD 重算例外包或用超算。 |
8.2 一句话选型口诀
CFD 看通道,SIL 看核数;AI 看显存,视频看硬盘;外场带便携,涉密全离线。
附:下单前 60 秒自检清单
- 每周 CFD/FEA 算例数与网格量级已估算 → CPU 核数 + 满通道内存
- 训练输入分辨率与模态数已确定 → GPU 显存(小目标建议 48GB)
- SIL 蒙特卡洛单次时长 × 目标次数已估算 → 多开并行数
- 单架次视频体量 × 月架次数已估算 → NVMe 容量与 RAID 级别
- 是否有外场伴随保障需求 → 便携机型
- 软件授权核数上限已盘点 → CPU 不超配
- 保密要求已明确 → 全离线本地闭环方案
数据来源与免责声明:文中拦截器技术体系、性能参数(速度区间 200–400 km/h、推重比 ≥2.5–3、续航 3–8 分钟、成本量级等)、工程痛点与系统构成,引自微信公众号"硬十"(朱晓明)原创文章《反无人机微型拦截小火箭关键技术》,均为公开资料整理,本文仅作技术解读与研发算力分析,不涉及任何具体武器的设计、制造或操作指导。UltraLAB 相关机型与定制能力介绍基于品牌公开资料,具体配置与价格请以官方最新在售信息为准。
关于 UltraLAB:UltraLAB 是西安坤隆计算机科技有限公司旗下高端定制图形工作站品牌,面向科学工程仿真、AI 深度学习、大模型本地化部署等场景,提供从桌面工作站、超频工作站、多 GPU 服务器到便携机型与集群的全栈算力定制方案。


