






在数据中心与科研计算的语境下,「内存墙」是比算力更先撞到的天花板:模型权重放不进片上缓存、网络数据来不及过内存、风险矩阵一次读取就耗尽带宽。AMD Alveo V80 正是为"内存带宽受限型(memory-bound)"负载而生的异构加速卡——它将 32GB HBM2e 高带宽内存与 260 万 LUT 的可编程逻辑封装在同一颗 Versal 芯片上,配合 4×200G 网络接口,为量化交易、大模型推理、实时分析等场景提供了"近内存计算"的确定性时延。
图 1:AMD Alveo V80 加速卡(全高 3/4 长、双槽位、被动散热)本文目录
- Alveo V80 规格速览
- 六大应用场景分析:核心算法与计算特点
- UltraLAB 硬件配置怎么选
- 软件清单
- 大模型本地部署实战
- 常见问题:硬件配置分析(FAQ)
一、Alveo V80 规格速览
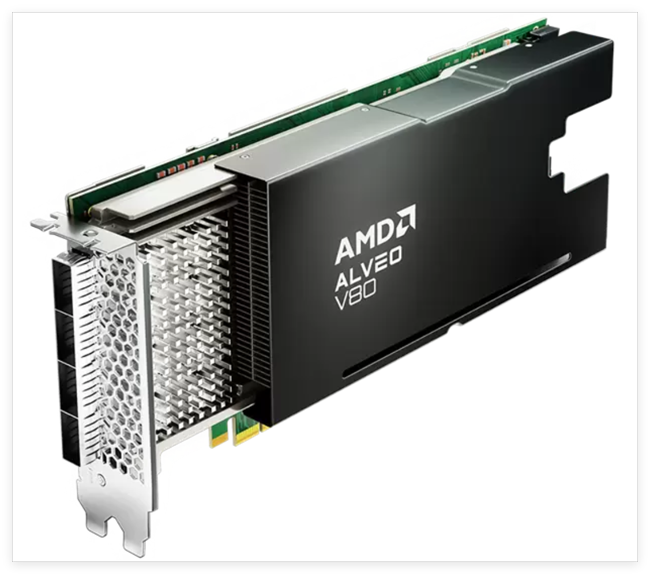
表 1:AMD Alveo V80 关键规格
| 项目 | 规格 | 对应用的意义 |
|---|---|---|
| 核心芯片 | AMD Versal HBM XCV80 自适应 SoC(7nm) | 可编程逻辑 + ARM 处理器 + AI 引擎一体化 |
| 逻辑资源 | 260 万 LUT、10,848 个 DSP58、132Mb BRAM、541Mb UltraRAM | 可同时部署多个并行计算流水线 |
| 板载内存 | 32GB HBM2e(2×16GB 堆叠),峰值带宽 820GB/s | 权重/数据集常驻片上,绕开 PCIe 往返 |
| 内存扩展 | 1×DDR4 DIMM 插槽,可扩 32GB | 超容量场景的溢出层 |
| 网络接口 | 4×QSFP56(每口 2×100G 或 4×10/25/40/50G),内置 3×400G 加密引擎、600G 以太网硬核 | 线速包处理与集群互联 |
| 主机接口 | PCIe Gen4 x16 或 2×Gen5 x8;MCIO 扩展 | 兼容主流工作站与服务器 |
| 管理子系统 | 双核 Cortex-A72 + 双核 Cortex-R5F | 片上运行调度与监控,不占用主机 CPU |
| 功耗形态 | 整卡电气功耗约 300W,被动散热,双槽位 | 需机箱风道配合(见 FAQ) |
| 开发工具 | AMD Vivado / Vitis / Vitis HLS、AVED 示例设计 | RTL 与 C/C++ 高层综合两条路线 |
二、六大应用场景分析:核心算法与计算特点
2.1 总览对比
| 应用场景 | 核心算法 | 计算特点 | V80 价值点 |
|---|---|---|---|
| 金融科技 / 量化交易 | Monte Carlo 模拟、期权定价(Black-Scholes/二叉树)、风险价值 VaR、限价订单簿匹配 | 延迟敏感(微秒级)、流式数据、分支少、可并行度高 | 硬件级确定性时延;数据经 200G 网口直入逻辑,绕开操作系统内核 |
| 大模型推理 | Transformer 解码(注意力 + FFN)、KV Cache 管理、INT4/INT8 量化算子 | 解码阶段纯带宽受限:每生成一个 token 需完整读一遍权重 | 32GB HBM2e 权重常驻,820GB/s 片上带宽直接决定解码速度 |
| 数据库加速与实时分析 | 内存哈希连接、列式压缩/解压缩(LZ4/Snappy 变体)、过滤聚合、欺诈检测特征工程 | 带宽受限、算子简单但数据量巨大、查询模式固定可固化 | 近内存计算 + 硬连线算子流水线,突破 CPU 的 PCIe 往返瓶颈 |
| 网络安全与包处理 | 深度包检测(DPI)正则匹配(Aho-Corasick)、IPsec/MACsec 加解密、流分类 | 线速处理(200G/口)、无分支流式流水、状态表查访密集 | 3×400G 硬件加密引擎 + 片上 TCAM 式规则匹配,CPU 零参与 |
| 基因组学与生物信息 | 序列比对(BWA-MEM2/minimap2 种子扩展)、变异检测(BAM 排序、马尔可夫模型)、k-mer 计数 | 内存带宽受限 + 不规则访存,SMEM/哈希表驻留需求大 | 大容量 HBM 驻留参考序列与索引,确定性流水掩盖随机访存 |
| EDA 与科学计算 | 电路布线/布局优化、门级仿真、SPICE 加速、蒙特卡洛仿真、稀疏矩阵求解 | 位级操作多、访存不规则、迭代间依赖强 | 位宽可定制(非定死 32/64 位),UltraRAM 缓存中间状态 |
2.2 场景详解
场景一:金融科技——把交易策略焊进硬件
核心算法是 Monte Carlo 路径模拟与限价订单簿撮合。这类负载的计算特点是:随机数生成、矩阵运算、指数/对数函数占主导,单任务浮点需求中等,但对时延的方差极度敏感——CPU 缓存未命中一次,可能就错过一个价位。V80 将订单簿状态驻留片上 UltraRAM,行情经 QSFP56 网口直达逻辑,全路径无操作系统调度,实现纳秒级抖动控制。
场景二:大模型推理——带宽就是速度
核心算法是 Transformer 自回归解码。其计算特点可总结为一句话:解码阶段几乎不产生新的矩阵乘并行度,每输出一个 token 都必须把全部活跃权重读一遍,因此推理速度 ≈ 内存带宽 ÷ 权重体积。这正是 V80 的主场:32GB HBM2e 装下 7B~32B 量化模型,820GB/s 带宽全部服务于权重读取,不存在"算力闲置"。详细容量与速度测算见第五章。
场景三:数据库与实时分析——让数据不必"过CPU"
核心算法为压缩/解压、哈希聚合与谓词过滤。计算特点:运算强度低(每字节数据只做几次操作)、吞吐优先、查询模式稳定。把算子编译成硬件流水线后,单卡即可替代多台 CPU 服务器的扫描吞吐,且功耗显著下降。V80 内置的 600G 以太网硬核还支持把卡直接挂入数据面,做"网络侧就地分析"。
场景四:网络安全——线速加解密与深度检测
核心算法包括 Aho-Corasick 多模式正则匹配、AES-GCM/IPsec 隧道加解密、流五元组哈希分类。计算特点是:纯流式、零缓存依赖、每包处理预算仅几纳秒。V80 的 400G 加密引擎是硬连线实现,独立于可编程逻辑,加解密不消耗 LUT 资源;规则库更新只需重新加载位流,无需停机。
场景五:基因组学——喂饱不规则访存
核心算法为 BWA-MEM2 的 seed-and-extend 比对与变异检测流水线。计算特点是:哈希索引与参考基因组体积大、访存高度随机、单线程 ILP 有限。V80 的 HBM 提供 32GB 低延迟随机访问空间,比 DDR5 内存随机访问延迟低一个量级,且 64 个独立伪通道可让多个比对单元并行取数,互不争抢。
场景六:EDA 与科学计算——定制位宽省出十倍效率
核心算法包括布尔可满足性(SAT)、布线冲突求解、蒙特卡洛与稀疏求解。计算特点是:位宽需求多样(1~128 位)、逻辑操作多于浮点、状态中间结果巨大。FPGA 可精确匹配数据通路位宽,避免 GPU/CPU"宽位打窄数"的浪费;541Mb UltraRAM 可缓存百万级中间状态,减少 HBM 往返。
三、UltraLAB 硬件配置怎么选
选型的第一原则是:V80 不吃 CPU 算力,吃的是 PCIe 通道数、机箱风道与供电余量。主机 CPU 只负责调度与预处理,不必堆砌核心数。
3.1 三档参考配置
| 档位 | 适用阶段 | 机型 | CPU | V80 数量 | 内存 | 存储 | 电源/散热要点 |
|---|---|---|---|---|---|---|---|
| 入门验证 | 算法评估、单卡原型、教学实验 | UltraLAB A350 | AMD 锐龙 9950X(16 核) | 1 张 | 128GB DDR5 | 2TB NVMe Gen4 | ≥1200W,导风罩直吹卡体 |
| 标准研发 | 多算法并行、多卡流水线、课题组共享 | UltraLAB AR350 / GR450P | Threadripper PRO 7985WX(64 核,128 条 PCIe 通道) | 2~4 张 | 256GB DDR5 ECC | 2×4TB NVMe Gen5 + 8TB HDD | 1600W+,双冷排水冷 + 整机风道仿真 |
| 旗舰集群 | 线速网络处理、多卡大模型、集群节点 | UltraLAB GX660M / EX660 | 双路 Xeon / EPYC(128~256 核) | 4~8 张 | 512GB~1TB DDR5 ECC RDIMM | 4TB NVMe Gen5 + 16TB RAID | 冗余电源 + 25G/100G 网卡 |
3.2 四个硬约束(选机前必查)
- PCIe 通道账:每张 V80 需要 Gen4 x16(或 Gen5 x8×2)。插 4 张即占用 64 条 Gen4 通道——普通桌面平台(24 条)只够 1 张满速,多卡必须选 Threadripper PRO / EPYC / Xeon W-3500 级平台。
- 风道账:V80 为被动散热,整卡电气功耗约 300W。塔式机箱必须使用导流罩形成穿透式风道,或改造主动散热模块;多卡机型建议相邻卡位留空或采用水冷改造。
- 供电账:除卡体 300W 外,主机 CPU(如 Threadripper PRO)峰值功耗可达 350W。8 卡机型电源需按"卡体功耗 × 卡数 + CPU + 50% 余量"核算。
- 网络账:若使用 V80 的 QSFP56 网口做线速包处理,需配套 100G/200G 交换机与光模块;纯 PCIe 计算场景可不用。
四、软件清单
| 类别 | 软件 | 用途 | 说明 |
|---|---|---|---|
| 操作系统 | Ubuntu 22.04 / 24.04 LTS、RHEL 8/9 | 主机环境 | 以 AMD XRT 官方支持矩阵为准;Windows 仅支持部分管理功能 |
| 运行时 | AMD XRT(Xilinx Runtime) | 主机与卡之间的驱动与调度 | 必装;提供 xbutil/xbmgmt 管理工具 |
| 开发套件 | AMD Vivado Design Suite | RTL 级开发、时序收敛、位流生成 | 适配 Versal 架构的最新版本 |
| 高层综合 | Vitis HLS / Vitis Unified IDE | C/C++ 算法直接综合为硬件流水 | 算法工程师主流路线,迭代快 |
| 参考设计 | AVED(Alveo Versal Example Design) | 快速点亮板卡、验证 HBM/网络 | 官方 bring-up 工程,强烈建议先跑通 |
| AI 工具链 | Vitis AI(配合第三方推理框架) | 量化、编译、部署 AI 模型 | 模型需编译为 DPU/自定义算子映射 |
| 容器化 | Docker / Singularity | 实验环境复现、集群分发 | XRT 支持容器内直通 |
| 集群调度 | Slurm / Kubernetes + Device Plugin | 多卡多机调度 | 教学科研集群建议 Slurm |
| 语言环境 | Python 3.10+、GCC/G++、CMake | 主机侧控制逻辑与数据预处理 | — |
特别提醒:Alveo 系列使用 XRT 软件栈,不走 ROCm;不要把 Instinct 加速卡的软件经验直接搬过来。
五、大模型本地部署实战
5.1 为什么 V80 适合"本地化推理"
大模型解码阶段的速度由内存带宽 ÷ 模型权重体积决定,与算力(TOPS/FLOPS)关系不大。公式近似为:
理论解码上限(token/s)≈ HBM 带宽 ÷(2 × 权重体积)
V80 的 32GB HBM2e 与 820GB/s 带宽,恰好覆盖"把量化模型整个放进片上、每 token 全带宽读权重"的部署形态,且整卡功耗约 300W,远低于同级 GPU 方案,适合对数据不出内网、长期开机成本敏感的实验室与企业。
5.2 模型规模与部署形态测算
| 模型规模 | 量化精度 | 权重大约体积 | 单卡可容纳 | 理论解码上限 | 建议部署形态 |
|---|---|---|---|---|---|
| 7B~8B | INT4 | 约 3.5~4.5GB | ✅ 宽裕 | 约 90~110 token/s | 单卡 + 长上下文 |
| 13B~14B | INT4 | 约 7~8GB | ✅ 宽裕 | 约 50~55 token/s | 单卡 |
| 32B~34B | INT4 | 约 17~19GB | ✅ 可放下(预留 KV Cache) | 约 20~24 token/s | 单卡,KV Cache 需限长 |
| 70B | INT4 | 约 35~40GB | ⚠️ 超出 32GB HBM | — | DDR4 扩展溢出 / 双卡并联 / 选 48GB+ 显存 GPU 机型 |
| Embedding/Rerank 类小模型 | FP16/INT8 | <2GB | ✅ 宽裕 | — | 可与 LLM 同卡共部署 |
5.3 部署路径建议
- 教学/轻量应用:7B~14B 量化模型单卡部署,主机用 UltraLAB A350,整机能耗可控制在 500W 以内,放办公室即可。
- 课题组知识库(RAG):32B 量化单卡 + 128GB 内存承载向量库,选 UltraLAB AR350。
- 70B 级需求:坦率地说这不是 V80 单卡的甜点区——建议改用 RTX PRO 6000 96GB 多卡 UltraLAB 机型(GPU 推理路线),或 2 张以上 V80 做并行解码(工程复杂度高,适合有 FPGA 团队的单位)。
六、常见问题:硬件配置分析(FAQ)
| # | 问题 | 结论要点 |
|---|---|---|
| Q1 | V80 和 GPU 有什么区别?能训练大模型吗? | V80 强在确定性时延、可定制位宽与片上 HBM;训练请选 GPU 集群,V80 定位推理与流式加速 |
| Q2 | 一台机器最多插几张? | 1 张需 Gen4 x16;Threadripper PRO 平台 4~8 张;双路服务器 8 张以上 |
| Q3 | 被动散热会不会过热? | 300W 被动卡必须配导流风道或水冷改造;多卡留空位 + xbutil 监控结温 |
| Q4 | BIOS 要设置什么? | Above 4G Decoding / Resizable BAR、PCIe Bifurcation、IOMMU(虚拟化时) |
| Q5 | 支持 Windows 吗?必须写 RTL 吗? | 运行用 Ubuntu/RHEL + XRT;开发可走 Vitis HLS(C/C++)路线,不必手写 RTL |
| Q6 | 32GB HBM 不够怎么办? | DDR4 扩展 / 多卡并联 / 换 96GB 显存 GPU 机型;带宽需多通道绑核才能吃满 |
结语与选型建议
AMD Alveo V80 不是"替代 GPU"的通用算力卡,而是为内存带宽受限、时延敏感、模式可固化的负载量身定制的专用加速平台。对于高校实验室与企业研发团队,我们的建议是:
- 负载以 Monte Carlo、数据库扫描、包处理、基因比对、EDA 为主 → V80 单卡起步,UltraLAB A350 即可验证;
- 需要 多算法并行或多卡流水线 → UltraLAB AR350/GR450P(Threadripper PRO,128 通道);
- 目标是 32B 级以内的大模型本地化推理 → V80 单卡可行;70B 级以上 → 优先评估 GPU 机型(RTX PRO 6000 96GB 多卡方案)。
免责声明:文中 V80 规格引自 AMD 官方产品资料,大模型部署测算为理论估算,实际性能受量化方案、内核实现与散热条件影响,建议以实测为准。UltraLAB 机型配置以官网在售为准。


