






导读:高光谱异常检测(HAD)的主流范式长期被"背景重构+残差检测"统治——低秩分解、全变分、自编码器、Transformer、扩散模型层层堆叠,却陷入一个悖论:网络重构能力越强,越容易把异常也一起重构掉,导致残差信号反而变弱。IEEE TGRS 2026上的HyFuHAD框架给出了全新思路——跳出单一残差检测,从形态、几何、统计三个维度构建多准则决策系统,并用量子神经网络(QUEEN)学习高维模糊特征。但在这"2.4秒推理出最优AUC"的优雅背后,藏着高光谱计算的真相:一个1024×1024×200波段的高光谱立方体仅原始数据就超过3GB,HyperCSI解混涉及大规模矩阵分解,量子变分电路在Pennylane中的模拟是指数级复杂度的计算,而多准则模糊TOPSIS决策需要逐像素遍历整个立方体。当你的研究从单场景验证扩展到8个真实遥感数据集的系统评测时,你的工作站的内存和CPU,还能跟上这场"高维数据+量子模拟+多准则融合"的算力风暴吗?
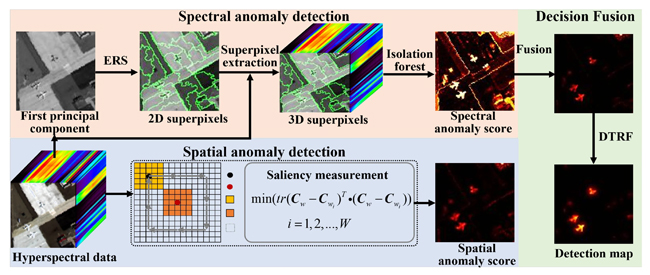
一、高光谱异常检测五大核心计算环节
基于HyFuHAD框架与主流HAD技术路线,现代高光谱异常检测已形成完整计算链条:
1. 数据预处理与降维
高光谱图像(HSI)是高维数据立方体(H×W×B,如1024×1024×200波段)。预处理环节包括:
-
噪声抑制:Savitzky-Golay滤波、小波去噪、BM3D
-
降维:PCA/MNF将数百波段压缩至数十个主成分,降低后续计算复杂度
-
波段选择:基于信息熵、散度或自编码器选择最优波段子集
HyFuHAD中的对应模块:量子分支中的Band Selection Module,从原始高光谱数据中选择代表性波段子集输入QUEEN网络。
2. 多视角异常特征提取
HyFuHAD的核心创新——不依赖单一背景重构,而是从三个互补维度提取异常证据:
表格
| 异常维度 | 方法 | 物理意义 | 计算特征 |
|---|---|---|---|
| 形态异常(Morphological MF) | 形态学属性开闭运算(Attribute Opening/Closing) | 捕捉"小而连通"的异常区域,对飞机、车辆等有效 | 图像形态学滤波,滑动窗口遍历全图,内存带宽敏感 |
| 几何异常(Geometrical MF) | HyperCSI解混 + 残差引导图 | 异常对应独特端元或特殊丰度模式 | 大规模矩阵分解(端元提取+丰度反演),CPU密集 |
| 统计异常(Statistical MF) | Mahalanobis距离(RX检测器) | 刻画偏离背景统计分布的像元 | 协方差矩阵求逆,O(B³)复杂度,波段数高时计算量大 |
3. 模糊特征聚合与不确定性建模
传统方法直接将三类异常图相加或简单阈值处理,HyFuHAD引入模糊逻辑:
-
高斯隶属度函数:将像元特征映射到[0,1]模糊空间
-
Einstein积与Einstein和:替代传统min/max,实现更平滑的模糊度过渡
-
犹豫度Token(Hesitancy Token):显式建模混合像元、边界像元的不确定性,避免强行二分类
计算特点:逐像素模糊运算可完全并行,但高光谱图像通常数百万像素,需要高效向量化实现。
4. 量子深度网络推理(QUEEN)
HyFuHAD的量子分支使用QUEEN(Quantum-based dEfuzzifier)网络:
-
振幅编码:将模糊特征映射到量子态
-
量子变分电路(VQC):参数化旋转门(Ry、Rx、Rz)+ 纠缠门,学习高维非线性表示
-
Pennylane仿真环境:在经典CPU/GPU上模拟量子电路行为(非真实量子硬件)
计算特点:量子电路模拟是指数级复杂度——N个量子比特的状态空间为2ᴺ,即使HyFuHAD使用轻量级电路,模拟20+量子比特的变分电路仍需大量矩阵运算。这是整个 pipeline 中最消耗算力的环节之一。
5. 多准则决策融合(MCDM)
-
经典MCDM:基于Einstein模糊算子的加权聚合,5条模糊规则(如"形态+统计异常同时高→高度确信异常")
-
量子MCDM:QUEEN输出的量子模糊度图
-
最终融合:经典决策图D_C与量子决策图D_Q逐像素融合,输出最终异常检测结果
计算特点:决策融合涉及大规模矩阵逐元素运算,内存带宽和浮点吞吐敏感。
二、核心算法与计算特点深度分析
1. HyperCSI解混算法(几何异常核心)
HyperCSI(Hyperspectral Compressed Sensing and Imaging)通过压缩感知思想进行端元提取与丰度反演:
X=EA+N
其中X为HSI数据矩阵,E为端元光谱矩阵,A为丰度矩阵,N为噪声。
计算特点:大规模非负矩阵分解迭代,涉及多次SVD或交替最小化,内存占用随波段数×像元数线性增长,CPU浮点性能决定收敛速度。
2. RX异常检测器(统计异常核心)
经典RX检测器计算每个像元的Mahalanobis距离:
DRX(x)=(x−μ)TC−1(x−μ)
其中μ为背景均值向量,C为背景协方差矩阵。
计算特点:协方差矩阵求逆O(B³),当波段数B>200时计算量显著;对每个像元计算二次型,可完全并行化,多核CPU可线性加速。
3. 形态学属性滤波(形态异常核心)
属性开闭运算基于连通分量分析,根据面积、形状等属性保留或去除区域:
γT(X)=⋁i{Ci∣Attr(Ci)≥T}
计算特点:连通分量标记是图像处理经典问题,滑动窗口遍历全图,内存带宽敏感(频繁访问邻域像素)。
4. 量子变分电路模拟(QUEEN核心)
Pennylane中的量子电路模拟涉及:
-
状态向量模拟:2ᴺ复数数组存储与演化
-
参数梯度计算:参数移位法则(Parameter-Shift Rule)或有限差分
-
优化迭代:Adam/梯度下降更新旋转门角度
计算特点:状态向量模拟是内存+CPU双重密集;虽然HyFuHAD使用轻量级电路,但量子模拟的底层仍是大型复数矩阵乘法。若扩展到更多量子比特,显存/内存将成为硬瓶颈。
5. 模糊TOPSIS多准则决策
TOPSIS(Technique for Order Preference by Similarity to Ideal Solution)计算每个像元到正理想解和负理想解的距离:
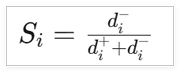
计算特点:大规模距离矩阵计算,可并行化,但需存储多个中间特征图(T_dR1~T_dR5、A、B、H等),内存容量敏感。
三、计算特点总结
表格
| 计算环节 | 计算特征 | 硬件瓶颈 |
|---|---|---|
| 高光谱数据加载 | 原始数据立方体3~10GB,降维后仍数百MB | 内存容量、存储读取速度 |
| HyperCSI解混 | 大规模矩阵分解迭代 | CPU浮点性能、内存容量 |
| RX协方差求逆 | O(B³),波段数高时计算量大 | CPU浮点性能 |
| 形态学属性滤波 | 滑动窗口遍历,连通分量分析 | 内存带宽、CPU主频 |
| 量子电路模拟 | 状态向量演化,复数矩阵乘法 | CPU/GPU浮点性能、内存容量 |
| CNN投影器 | 特征提取与降维 | GPU显存、CUDA核心数 |
| 模糊运算与TOPSIS | 逐像素大规模矩阵运算 | 内存带宽、多核并行 |
| 多数据集评测 | 8个场景(Airport/Urban/Beach/Bridge等)批量处理 | CPU核心数、存储I/O |
| 后处理可视化 | 异常得分图、ROC曲线、AUC计算 | GPU图形性能 |
核心矛盾:高光谱异常检测是高维数据+多算法串联的典型场景——数据立方体占用大内存,解混和量子模拟吃CPU浮点,CNN推理吃GPU,多数据集评测吃多核并行。单一维度的硬件升级无法解决全链路瓶颈。
四、软件工具链
高光谱数据处理
-
Python + spectral / HyperSpy:高光谱数据读写、PCA/MNF降维、波段选择
-
MATLAB + 高光谱工具箱:RX检测器、HyperCSI解混、经典算法原型验证
-
ENVI / IDL:遥感图像可视化、ROI标注、专业分析流程
深度学习与量子机器学习
-
PyTorch / TensorFlow:CNN投影器、自编码器背景重构、端到端异常检测网络
-
Pennylane + PyTorch/TensorFlow:量子变分电路(QUEEN)搭建与训练,参数优化
-
Qiskit / Cirq(备选):其他量子模拟框架
模糊逻辑与多准则决策
-
Python + NumPy/SciPy:高斯隶属度函数、Einstein积/和、TOPSIS决策矩阵
-
scikit-fuzzy:模糊逻辑系统快速原型
形态学与图像处理
-
Python + scikit-image / OpenCV:形态学属性开闭、连通分量标记、图像滤波
-
MATLAB Image Processing Toolbox:形态学运算、属性滤波
评测与可视化
-
Python + matplotlib / seaborn:ROC曲线、AUC计算、异常得分图可视化
-
TensorBoard:训练过程监控
五、科研级硬件配置推荐
基于高光谱异常检测的四大负载特征——高维数据内存密集、矩阵分解CPU密集、量子模拟浮点密集、多数据集评测多核友好——推荐以下三档方案:
【方案A】课题组入门型:单场景验证 + 经典算法复现
相关机型 UltraLAB AX450
表格
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | Intel Xeon 674X(28核56线程,液冷超频4.8GHz) | RX检测器协方差求逆对主频敏感;28核支持多数据集并行评测 |
| 内存 | 128GB DDR5-5600 ECC RDIMM(8×16GB) | 1024×1024×200波段高光谱立方体(~3GB)+ 解混中间矩阵 + 多特征图缓存 |
| GPU | NVIDIA RTX Pro 5000 32GB | 32GB显存支撑CNN投影器推理;Pennylane GPU后端加速量子电路模拟 |
| 系统盘 | 2TB PCIe 4.0 NVMe SSD | Python + PyTorch + Pennylane + MATLAB环境 |
| 数据盘 | 4TB PCIe 4.0 NVMe SSD | 高光谱数据集库(AVIRIS、Hymap、San Diego、PaviaU等) |
| 网络 | 双万兆以太网 | 多用户远程桌面,课题组共享数据集 |
| 散热 | 360mm一体式水冷 | 保障Xeon W长时间满载不降频 |
| 系统 | Ubuntu 22.04 LTS / Windows 11 | Python/Pennylane以Linux为主;MATLAB/ENVI可跨平台 |
适用场景:高校遥感/信号处理课题组,复现HyFuHAD及主流HAD算法(RX、GRX、TPCA、Auto-AD),单场景验证与消融实验,数据规模<1024×1024×200。
【方案B】企业/院所主力型:多场景批量评测 + 量子网络训练
相关机型 UltraLAB AE450
表格
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | AMD Threadripper PRO 7995WX(96核192线程,液冷超频) | 8个真实场景(Airport/Urban/Beach/Bridge等)批量评测可充分利用192线程;高频加速RX/HyperCSI单场景求解 |
| 内存 | 256GB DDR5-4800 ECC RDIMM(8×32GB) | 多场景并行缓存 + 大规模高光谱数据(2048×2048×300波段)+ 量子电路状态向量模拟 |
| GPU | NVIDIA RTX Pro 5000 72GB ×2 | 72GB显存支撑大规模CNN特征提取;双卡NVLink加速Pennylane量子模拟与多batch训练 |
| 系统盘 | 2TB PCIe 5.0 NVMe SSD | 极速加载大型高光谱数据集 |
| 数据盘 | 8TB PCIe 4.0 NVMe SSD ×2(RAID 0) | 多数据集高光谱库(数十GB~数百GB),RAID 0消除I/O瓶颈 |
| 阵列存储 | 32TB SATA企业级HDD ×4(RAID 5) | 历史遥感数据集归档、模型版本库、评测结果库 |
| 网络 | 双万兆以太网 | 多用户并发远程桌面,实验-算法-应用团队协作 |
| 散热 | 冷排液冷系统(CPU+双GPU全覆盖) | 双卡满载+CPU超频,总功耗超1500W |
| 系统 | Ubuntu 22.04 LTS(主)+ Windows 11(辅) | 大规模批处理与量子训练以Linux为主;ENVI/MATLAB可视化可切Windows |
适用场景:遥感技术研究所、国防/农业/环境监测企业研发中心,承担多场景高光谱异常检测系统开发、量子机器学习算法验证、大规模数据集基准评测。
【方案C】旗舰级遥感智能解译中心:多算法融合 + 多用户数字孪生
相关机型 UltraLAB GA660M
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | 2× AMD EPYC 9575F(64核128线程,液冷超频) | 双路平台支持超大规模高光谱数据(卫星级整景)+ 多算法(HyFuHAD+GTVLRR+TGFA-AD+BSDM)并行评测 |
| 内存 | 512GB DDR5-4800 ECC RDIMM(16×32GB) | 整景高光谱数据(>5000×5000×400波段)+ 多分支量子网络 + 多任务并行 |
| GPU | NVIDIA RTX Pro 6000 96GB ×4 | 96GB显存可加载整景高光谱切片;四卡并行支持多用户同时CNN推理、量子模拟与可视化 |
| 系统盘 | 4TB PCIe 5.0 NVMe SSD(企业级) | 高可靠性,保障长时间量子网络训练不中断 |
| 高速数据层 | 16TB PCIe 5.0 NVMe SSD ×2 | 支撑四卡同时读取高光谱数据切片,消除I/O瓶颈 |
| 冷数据层 | 64TB SATA企业级HDD ×6(RAID 6) | 海量遥感影像库、历史异常检测结果、全球高光谱数据集 |
| 网络 | 双25Gb以太网 + InfiniBand HDR(可选) | 未来扩展多节点集群,构建遥感智能解译私有云;与卫星地面站数据互联 |
| 散热 | 定制压缩机散热系统(2000W级) | 四卡96GB旗舰卡满载功耗极高,压缩机散热保障持续峰值性能 |
| 系统 | Ubuntu 22.04 LTS + Kubernetes容器调度 | 多用户容器化隔离,支持PyTorch/Pennylane/MATLAB/ENVI环境并存 |
适用场景:国家级遥感重点实验室、大型卫星应用中心,支撑整景高光谱异常检测、多算法融合决策、量子-经典混合智能解译、多用户协同分析。
六、关键配置细节提醒
1. 内存容量是高光谱的"生命线"
一个1024×1024×200波段的高光谱图像,单精度浮点存储即需约800MB。HyFuHAD pipeline中同时存在原始数据、降维数据、3个异常特征图、5个模糊特征图、CNN投影特征、量子态向量等多个中间结果,总内存占用轻松突破50GB。若进行多场景并行评测,128GB是入门底线,256GB是主力标配,512GB才能驾驭卫星级整景数据。
2. CPU主频决定RX检测与解混的"体感速度"
RX检测器的协方差矩阵求逆和HyperCSI的迭代分解,本质上是串行性较强的矩阵运算。主频每提升10%,单场景处理时间缩短约8~12%。液冷超频至4.8GHz+是提升交互体验性价比最高的投资。
3. GPU显存决定量子模拟与CNN的"规模上限"
Pennylane的GPU后端可将量子电路模拟加速数十倍,但状态向量需完整加载到显存中。20量子比特的状态向量约占用16MB(复数双精度),但随着电路深度和批量大小增加,显存需求快速增长。32GB可支撑轻量级QUEEN网络,72GB/96GB才能支撑更大规模的量子-经典混合模型。
4. 多核并行是多场景评测的"倍增器"
HyFuHAD论文在8个场景上进行了系统评测,每个场景的处理流程独立可并行。96核/112核平台可同时处理6~10个场景,将原本数小时的基准测试压缩到数十分钟。这是高核心数CPU在高光谱研究中的核心价值。
5. 存储分层:NVMe热数据 + HDD冷归档
高光谱数据集(AVIRIS、Hymap、EnMAP等)体积巨大,单景数据可达数GB至数十GB。建议采用PCIe 5.0 NVMe作为活跃工作区(加载当前处理数据),SATA HDD作为遥感影像归档库,避免机械硬盘拖慢数据加载。
七、结语:硬件是跨越"异常检测悖论"的隐形算力
HyFuHAD框架揭示了一个深刻趋势:高光谱异常检测正在从"更深的重构网络"走向"更聪明的证据融合"。形态、几何、统计三维异常证据+模糊逻辑不确定性建模+量子神经网络高维特征学习——这种多准则决策范式,对算力提出了更复杂的要求:不再是单一算法的优化,而是多算法串联、多特征并行、多场景评测的全链路算力保障。
对于高校遥感教授、国防科研院所工程师、农业/环境监测技术骨干而言,选择一台能够同时支撑高维数据加载+矩阵分解+量子模拟+CNN推理+多准则决策的图形工作站,已不是"配置够用就行"的保守策略,而是缩短算法验证周期、提升多场景评测效率、抢占遥感智能解译技术制高点的核心投资。
UltraLAB面向遥感智能解译与高光谱异常检测场景,提供从液冷超频单卡工作站到四卡旗舰融合平台的完整方案,深度优化PyTorch、Pennylane、MATLAB及Python高光谱处理环境的硬件协同,助力您的团队从"重构背景"走向"融合证据"。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


