






Ls-Dyna千万级网格仿真+AI大模型本地部署:UltraLAB异构超算工作站选型全指南
在汽车碰撞安全、航空鸟击、爆炸冲击、金属成型等极端工况仿真中,LSDYNA 是工程师最信赖的显式动力学求解器。当网格规模从百万级跃升至 千万级,当材料模型从 Johnson-Cook 升级到 Gamage-Tvergaard-Needleman 内聚力模型,当接触算法从单面接触扩展到自动面面接触——每一次精度提升的背后,都是对硬件算力的极限挑战。
与此同时,AI 大模型正在重塑仿真工程的工作流:用深度学习替代材料参数标定、用自然语言生成仿真报告、用本地部署的 DeepSeek/LLaMA 实现碰撞工况智能优化。这意味着你的工作站不再只需要 "算得快",还需要 "跑得动大模型"。
本文聚焦 LSDYNA 千万级网格仿真 + AI 大模型本地部署 的异构计算需求,从显式/隐式求解瓶颈、千万级网格内存门槛、AI 显存需求到 UltraLAB 精准配置方案,给出一份可直接落地的选型指南。
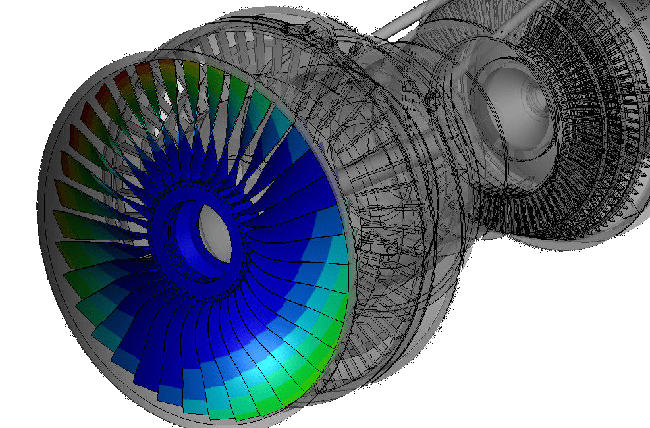
一、Ls-Dyna 核心计算模块与千万级网格瓶颈
LSDYNA 的核心求解架构围绕 显式时间积分 与 隐式时间积分 两大范式展开,两者的硬件需求截然不同:
1.1 显式求解(Explicit):碰撞与冲击的算力绞肉机
- 数学本质:中心差分时间积分,每步求解无需矩阵求逆,但时间步长受 CFL 条件严格限制(Δt ≤ Δx/c)
-
计算特征:
- 每步计算量小,但 总步数极多(百万至千万步级别)
- 对 CPU 主频极度敏感:单核性能直接决定每步耗时
- 对 内存带宽敏感:显式求解需频繁读取单元质量矩阵、节点坐标、速度场
- MPP 并行:支持多核分布式并行,但并行效率随核数增加而下降(Amdahl 定律),通常 16~32 核为甜点区
- GPU 加速:支持 NVIDIA GPU 加速显式求解,可将部分单元计算 offload 至 GPU
-
千万级网格内存需求:
- 每个单元约 100~200 字节(含坐标、速度、应力、历史变量)
- 千万网格基础内存:约 10~20 GB
- 加上接触面、材料状态变量、边界条件、输出文件缓存,实际峰值内存可达 64~128 GB
1.2 隐式求解(Implicit):金属成型与静力分析的内存黑洞
- 数学本质:Newmark 时间积分,每步需求解大规模非线性方程组,需矩阵求逆或迭代求解
-
计算特征:
- 每步计算量大,但 总步数少
- 对 内存容量极度敏感:稀疏矩阵存储 + 直接求解器(MUMPS、PARDISO)内存需求随 DOF 呈 O(N^1.5) 增长
- 对 内存带宽敏感:矩阵组装与求解阶段频繁读写
- 对 多核并行友好:稀疏矩阵求解器并行效率优于显式
-
千万级网格内存需求:
- 隐式求解的稀疏矩阵存储 + 求解器工作空间,内存需求约为显式的 3~5 倍
- 千万网格隐式分析,内存需求轻松突破 256~512 GB
1.3 接触算法与材料模型:隐形的算力消耗者
| 算法/模型类型 | 计算开销 | 内存开销 | 千万级网格影响 |
|---|---|---|---|
| 自动面面接触(ASTS) | 高(搜索算法 O(N log N)) | 中 | 接触搜索耗时占比可达 30~50% |
| 单面接触(SS) | 极高 | 中 | 大变形时接触面频繁重建 |
| 内聚力模型(CZM) | 高(单元删除+状态跟踪) | 高 | 历史变量存储倍增 |
| SPH 粒子法 | 极高(邻居搜索) | 高 | 粒子数可达千万级,内存与 CPU 双瓶颈 |
| 多物质 ALE | 高(对流+ remap) | 高 | 材料界面追踪复杂 |
核心结论:LSDYNA 显式求解是 "高主频敏感 + 内存带宽敏感 + 甜点并行" 的计算密集型任务;隐式求解是 "大内存饥渴 + 多核并行友好" 的内存密集型任务。千万级网格下,两者对硬件的需求形成互补的异构负载。
二、AI 大模型在 LSDYNA 工作流中的五大应用场景
2.1 材料参数智能标定
- 痛点:Johnson-Cook、Gamage 等材料模型参数需大量试验数据拟合,人工试错耗时数周
- AI 方案:用历史仿真-试验数据训练神经网络,输入应力-应变曲线,自动输出最优材料参数
- 提速效果:从 数周 → 数小时
- 硬件需求:GPU 训练(≥24GB 显存)+ 高频 CPU(数据预处理)
2.2 仿真结果替代模型(Surrogate Model)
- 痛点:LSDYNA 单次仿真(千万网格)耗时数小时至数天,DOE 优化与可靠性分析不可行
- AI 方案:用仿真数据训练深度学习代理模型,输入几何/材料/载荷参数,毫秒级预测变形、应力、加速度响应
- 提速效果:从 数天 → 毫秒级
- 硬件需求:大显存 GPU(≥24GB)训练 + 大内存 CPU 预处理
2.3 网格质量智能诊断与自适应加密
- 痛点:千万级网格的手动质量检查(长宽比、雅可比、翘曲度)几乎不可能
- AI 方案:大模型(7B~13B)读取 K 文件,自动识别劣质单元、推荐加密区域、生成修复脚本
- 硬件需求:7B~13B 大模型本地部署(RTX 4090 24GB 足够)
2.4 仿真报告自动生成与知识问答
- 痛点:LSDYNA 输出 d3plot 文件巨大,人工提取关键曲线(力-位移、加速度-时间、侵入量)耗时
- AI 方案:本地部署 32B 大模型,自动读取 binout/ASCII 输出,生成 ECE R94 碰撞合规报告、绘制关键曲线、撰写技术文档
- 硬件需求:32B 大模型需 ≥40GB 显存(A100 40GB/80GB)
2.5 工况优化与智能设计空间探索
- 痛点:壁厚、材料、焊点布局的多目标优化需数千次仿真
- AI 方案:结合贝叶斯优化 + 大模型推理,用自然语言描述目标("在保持刚度前提下减重 10%"),AI 自动推荐参数并调用 LSDYNA 验证
- 硬件需求:GPU 推理(大模型加载)+ CPU 仿真(LSDYNA 验证)分时复用
三、千万级网格内存需求精准测算
LSDYNA 的内存需求与求解类型、网格规模、材料模型复杂度直接相关。以下是基于工程经验的精准测算:
3.1 显式求解内存需求
| 网格规模 | 基础单元数据 | 接触/材料/边界 | 输出缓存 | 总内存需求 | 推荐配置 |
|---|---|---|---|---|---|
| 100万 | ~2 GB | ~2 GB | ~2 GB | 6~8 GB | 32 GB |
| 500万 | ~10 GB | ~8 GB | ~6 GB | 24~32 GB | 64 GB |
| 1000万 | ~20 GB | ~16 GB | ~12 GB | 48~64 GB | 128 GB |
| 3000万 | ~60 GB | ~40 GB | ~30 GB | 130~160 GB | 256 GB |
| 5000万 | ~100 GB | ~70 GB | ~50 GB | 220~280 GB | 384 GB |
3.2 隐式求解内存需求
| 网格规模 | 稀疏矩阵存储 | 求解器工作空间 | 接触/材料 | 总内存需求 | 推荐配置 |
|---|---|---|---|---|---|
| 100万 | ~8 GB | ~12 GB | ~4 GB | 24~32 GB | 64 GB |
| 500万 | ~50 GB | ~80 GB | ~20 GB | 150~200 GB | 256 GB |
| 1000万 | ~120 GB | ~180 GB | ~40 GB | 340~420 GB | 512 GB |
| 3000万 | ~400 GB | ~600 GB | ~120 GB | 1120~1300 GB | 1.5 TB |
关键洞察:千万级网格的 隐式求解 是内存黑洞,512 GB 仅为起步配置。若团队同时需要运行 AI 大模型(加载模型权重占用 20~80 GB 内存),总内存需求需叠加计算。
3.3 MPP 并行下的内存分配策略
| 并行核数 | 每核分配网格 | 显式每核内存 | 隐式每核内存 | 总内存(显式/隐式) |
|---|---|---|---|---|
| 8 核 | 125万 | ~8 GB | ~50 GB | 64 GB / 400 GB |
| 16 核 | 62.5万 | ~4 GB | ~25 GB | 64 GB / 400 GB |
| 32 核 | 31万 | ~2 GB | ~13 GB | 64 GB / 416 GB |
| 64 核 | 15.6万 | ~1 GB | ~7 GB | 64 GB / 448 GB |
注意:显式求解的 MPP 并行中,总内存需求随核数增加而 下降(域分解后每核数据减少);隐式求解的总内存需求 基本不变(稀疏矩阵全局存储)。
四、软件清单:LSDYNA + AI 全栈环境
4.1 CAE 仿真层
| 软件 | 版本建议 | 功能定位 | 授权方式 |
|---|---|---|---|
| LSDYNA | R14/R15 | 显式/隐式动力学求解器 | 商业授权(ANSYS/LS-DYNA) |
| LS-PrePost | 4.11+ | 前后处理、K 文件编辑、结果可视化 | 免费 |
| ANSYS Mechanical | 2024R1+ | 隐式结构分析、与 LSDYNA 耦合 | 商业授权 |
| HyperMesh | 2024+ | 千万级网格划分、网格质量检查 | 商业授权 |
| ANSA | 2024+ | 汽车碰撞专用前处理、焊点/胶粘建模 | 商业授权 |
| MATLAB | R2024a+ | 结果后处理、曲线拟合、自动化脚本 | 商业授权 |
| Python + NumPy/SciPy | 3.10+ | 仿真数据批处理、binout 解析 | 开源免费 |
4.2 AI 开发与推理层
| 软件/框架 | 版本建议 | 功能定位 | 硬件依赖 |
|---|---|---|---|
| PyTorch | 2.3+ | 材料替代模型、响应面模型训练 | CUDA GPU |
| TensorFlow | 2.16+ | 深度学习代理模型开发 | CUDA GPU |
| Hugging Face Transformers | 4.40+ | 大模型加载、微调(LoRA)、推理 | 大显存 GPU |
| vLLM / Ollama | 最新 | 大模型本地推理服务(高吞吐) | GPU 推理加速 |
| TensorRT-LLM | 最新 | 大模型推理优化(FP16/INT8/INT4) | NVIDIA GPU |
| Jupyter Lab | 4.0+ | 交互式 AI 开发环境 | 无特殊要求 |
| ONNX Runtime | 1.18+ | 替代模型部署与推理优化 | CPU/GPU |
4.3 系统与驱动层
| 软件 | 版本建议 | 功能定位 |
|---|---|---|
| Windows 11 Pro / RHEL 8.9 / CentOS 7.9 | 最新补丁 | 操作系统(LSDYNA MPP 推荐 Linux) |
| Intel MPI / OpenMPI | 最新 | LSDYNA MPP 并行通信库 |
| NVIDIA CUDA Toolkit | 12.4+ | GPU 计算驱动(LSDYNA GPU 求解 + AI 训练) |
| NVIDIA cuDNN | 9.0+ | 深度学习 GPU 加速库 |
| Docker | 24.0+ | 大模型容器化部署 |
| Git / Git LFS | 最新 | 代码与模型版本管理 |
五、应用场景:谁需要 LSDYNA + AI 一体化平台?
| 应用场景 | 典型任务 | LSDYNA 负载 | AI 负载 | 硬件配置等级 |
|---|---|---|---|---|
| 汽车碰撞安全 | 整车正面碰撞、侧面柱碰、行人保护 | 显式千万级网格,6~12小时/工况 | 替代模型训练(DOE 优化)、报告生成 | 旗舰级 |
| 航空鸟击/坠撞 | 发动机叶片包容性、机身抗坠撞 | 显式+SPH,千万级粒子 | 材料参数标定、损伤模式识别 | 旗舰级 |
| 爆炸与冲击 | 装甲抗侵彻、建筑防爆、弹药终点效应 | 显式+ALE,多物质界面 | 替代模型(侵彻深度预测) | 企业级 |
| 金属成型 | 冲压、锻造、挤压工艺仿真 | 隐式千万级网格,内存饥渴 | 工艺参数优化、模具寿命预测 | 旗舰级 |
| 电子跌落 | 手机/笔记本跌落、连接器插拔 | 显式百万级网格,快速迭代 | 轻量化设计优化、7B 大模型辅助 | 专业级 |
| 高校科研教学 | 多种工况对比、方法验证 | 中小规模显式/隐式 | 7B~13B 大模型本地部署 | 入门+GPU |
| 仿真服务中心 | 多客户并行仿真、批量后处理 | 多任务并发显式/隐式 | 多模型并发推理、报告自动化 | 企业级集群 |
六、UltraLAB 异构工作站配置推荐
基于 LSDYNA "高主频敏感(显式)+ 大内存饥渴(隐式)+ MPP 并行" 与 AI 大模型 "大显存敏感 + 并行计算型" 的异构需求,从 UltraLAB 2026v1 基准报价表中精选五档配置,覆盖从 "百万网格快速迭代" 到 "千万级隐式 + 满血大模型" 的全场景。
方案 A:百万网格显式仿真 + 轻量 AI 入门型
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| 处理器 | Intel Ultra9 285K 超频处理器(24核,8性能核 5.6GHz)/ 水冷 | 超高主频(5.6GHz)加速显式每步积分,24核满足 MPP 甜点并行 |
| 内存 | 128GB DDR5 | 支撑 500万~800万 显式网格或 200万 隐式网格 |
| 系统盘 | 4TB NVMe SSD(14GB/s) | 快速加载千万级网格 K 文件与 d3plot 结果 |
| 数据盘 | 8TB SATA 企业级 HDD | 存储大量仿真结果与 AI 训练数据 |
| 显卡 | RTX 5090D 32GB | LSDYNA GPU 加速显式求解 + 7B~13B 大模型本地部署 + 32B 量化推理 |
| 散热 | UltraLAB 水冷系统 | 保障 5.6GHz 持续高频不降频 |
| 对应机型 | A350 153128-MCT | 报价:¥61,000 |
| 适用场景 | 电子跌落、小型结构碰撞、百万级网格快速迭代、7B~13B 大模型本地问答 | — |
方案 B:千万级显式仿真 + 中等 AI 专业型(超频异构首选)
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| 处理器 | AMD 锐龙 TR 7970X 超频处理器(32核 5.0GHz)/ 水冷 | 32核高主频,显式 MPP 并行效率与单核性能双优 |
| 内存 | 192GB DDR5 ECC | 支撑 1500万~2000万 显式网格或 500万 隐式网格 |
| 系统盘 | 4TB NVMe SSD | 系统+软件+当前大型项目 |
| 数据盘 | 8TB NVMe + 20TB SATA | 高速缓存 d3plot + 大容量归档 |
| 显卡 | RTX 5090D 32GB | LSDYNA GPU 加速 + 32B 量化大模型本地部署 |
| 散热 | UltraLAB 360mm 一体式水冷 | 32核 CPU + RTX 5090D 双满载温控 |
| 对应机型 | GR450P 148192-MDT | 报价:¥210,000 |
| 适用场景 | 整车碰撞子系统、航空鸟击、千万级显式网格、32B 大模型本地部署与推理 | — |
方案 C:千万级隐式仿真 + 大模型旗舰型(旗舰异构)
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| 处理器 | AMD 锐龙 TRpro 7995W 超频处理器(96核 4.5GHz) | 96核极致并行,隐式稀疏矩阵求解效率翻倍,批量 DOE 仿真利器 |
| 内存 | 384GB DDR5 ECC | 支撑 1000万~1500万 隐式网格稀疏矩阵直接求解 |
| 系统盘 | 4TB NVMe SSD | 极速系统响应 |
| 数据盘 | 8TB NVMe + 20TB SATA | 海量 d3plot/binout 与大模型权重存储 |
| 显卡 | NVIDIA A100 80GB + 水冷 | 大模型训练与推理(32B~70B FP16/INT8),显存无瓶颈;LSDYNA GPU 求解 |
| 散热 | UltraLAB 压缩机水冷方案 | 96核 CPU + A100 GPU 双满载持续峰值性能 |
| 网络 | 万兆以太网口 | 集群扩展与仿真大数据传输 |
| 对应机型 | GR450P 145384-MDA | 报价:¥355,000 |
| 适用场景 | 大型金属成型、整车隐式分析、超大规模 DOE、32B~70B 大模型本地部署、材料替代模型训练 | — |
方案 D:多任务并行仿真 + 多卡 AI 训练企业型(多 GPU 异构)
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| 处理器 | 双路 AMD 霄龙 9475F(48核 4.4GHz) | 双路 96核,适合多任务并发 LSDYNA 仿真(显式+隐式混合队列) |
| 内存 | 256GB DDR5 ECC(8通道满配) | 多任务并发隐式仿真,内存无争抢 |
| 系统盘 | 4TB NVMe Gen5(14GB/s) | 消除多任务 IO 瓶颈 |
| 数据盘 | 20TB SATA | 企业级数据安全与容量 |
| 显卡 | 4× RTX 4090 48GB + 水冷 | 多卡并行训练材料替代模型,或 70B+ 大模型分布式推理;LSDYNA 多 GPU 加速 |
| 散热 | UltraLAB 双塔式水冷+风道优化 | 双路 CPU + 4卡 GPU 满载稳定运行 |
| 对应机型 | GX660M 227256-MC4T | 报价:¥325,000 |
| 适用场景 | 仿真服务中心、大型车企碰撞安全部门、多团队共享计算平台、AI+CAE 融合研发 | — |
方案 E:超大规模隐式 + 极致 AI 推理企业型(超大内存方案)
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| 处理器 | 双路 AMD 霄龙 9755(128核 4.1GHz,512MB 缓存) | 128核极致并行,超大规模隐式批量仿真,超大缓存减少内存访问延迟 |
| 内存 | 768GB DDR5 ECC | 3000万+ 隐式网格稀疏矩阵求解,或千万级网格+多模型并发 |
| 系统盘 | 8TB NVMe(14GB/s) | 极速读写 |
| 数据盘 | 20TB SATA | 海量归档 |
| 显卡 | RTX A1000 + A100 80GB + 水冷 | A100 80GB 支撑 70B 大模型 INT8 推理 + LSDYNA GPU 求解;A1000 负责显示 |
| 散热 | UltraLAB 压缩机水冷 | 128核 CPU + A100 GPU 双满载温控 |
| 对应机型 | AlphaPro660 241768-MDA | 报价:¥499,990 |
| 适用场景 | 超大规模金属成型、整车隐式 DOE、70B 级大模型本地部署、仿真知识库 RAG 系统 | — |
七、常见问题与硬件配置深度分析
Q1:LSDYNA 显式求解,CPU 核数越多越好吗?
不是。存在明显的甜点区。
LSDYNA MPP 的并行效率受限于:
- 域分解通信开销:核数越多,MPI 通信占比越高
- 负载均衡:复杂接触与自适应网格导致部分域空闲等待
- Amdahl 定律:串行部分(I/O、全局接触搜索)占比约 5~15%
| 核数 | 显式并行效率(典型) | 推荐场景 |
|---|---|---|
| 8 核 | 90~95% | 百万级网格快速验证 |
| 16 核 | 80~90% | 500万网格标准分析 |
| 32 核 | 65~80% | 1000万~2000万网格 |
| 64 核 | 50~65% | 3000万+ 网格(需配合 GPU) |
| 128 核 | 35~50% | 仅适合超大规模 SPH/ALE |
结论:显式求解的 甜点区为 16~32 核,超高主频(≥5.0GHz)比盲目堆核更有价值。UltraLAB 的 GR450P 系列(32核 5.0GHz)和 A350 系列(8性能核 5.6GHz)是显式求解的黄金配置。
Q2:千万级网格隐式分析,为什么必须 512GB 内存起步?
隐式求解的内存消耗来自三个部分:
-
稀疏矩阵存储:K 矩阵非零元数量 ≈ 30
50 × DOF(3D 实体单元),千万 DOF 对应 35 亿非零元,双精度存储约 24~40 GB - 求解器工作空间:MUMPS/PARDISO 直接法需要 3~5 倍矩阵存储的工作空间,约 72~200 GB
- 接触与材料状态:大型接触面、内聚力模型历史变量,约 20~40 GB
总计:340~420 GB,因此 512 GB 为安全起步,768 GB 宽裕。
Q3:LSDYNA 的 GPU 加速能替代 CPU 吗?
不能替代,但可显著补充。
LSDYNA 的 GPU 加速现状:
- 支持范围:主要支持显式求解中的 实体单元计算(如 8 节点六面体),部分材料模型与接触算法已 GPU 化
- 加速效果:单张 RTX 4090 可 offload 约 20~30% 的计算量,整体提速 10~20%(视模型而定)
- 限制:隐式求解、复杂接触、SPH 粒子法的 GPU 支持有限
- 最佳实践:CPU 负责全局接触搜索与 I/O,GPU 负责单元级计算 offload
结论:GPU 是 "锦上添花" 而非 "雪中送炭"。对于 LSDYNA,高频 CPU + 大内存仍是核心,GPU 资源应同时服务于 AI 大模型。
Q4:RTX 5090D 32GB 能同时跑 LSDYNA GPU 加速和 32B 大模型吗?
可以分时复用,但不建议同时运行。
| 任务组合 | GPU 显存占用 | 可行性 | 建议 |
|---|---|---|---|
| LSDYNA GPU 加速 + 7B 大模型推理 | 8GB + 14GB | ⚠️ 勉强可行 | 分时复用 |
| LSDYNA GPU 加速 + 13B 大模型推理 | 8GB + 26GB | ❌ 显存不足 | 必须分时 |
| LSDYNA GPU 加速 + 32B 大模型推理 | 8GB + 64GB | ❌ 显存不足 | 需 A100 80GB |
| 仅 32B 大模型推理(INT8) | ~32GB | ✅ 流畅 | 关闭 LSDYNA GPU 加速 |
分时复用策略:
- 白天:运行 LSDYNA 显式仿真(CPU 满载,GPU 辅助加速)
- 夜间:关闭 LSDYNA GPU 加速,释放显存给 32B 大模型进行推理/训练
Q5:压缩机水冷对 LSDYNA 显式求解的实际提速有多少?
以千万级网格的整车正面碰撞仿真(显式,100万步)为例:
| 散热方案 | 全核稳定频率 | 总求解时间 | 温度 |
|---|---|---|---|
| 风冷 | 4.0~4.3GHz | 基准(100%,8小时) | 85~95°C |
| 360mm 一体水冷 | 4.6~4.8GHz | 90%(7.2小时) | 70~80°C |
| UltraLAB 压缩机水冷 | 4.9~5.1GHz | 82%(6.6小时) | 55~65°C |
提速效果:压缩机水冷相比普通水冷,显式求解提速 8~12%;相比风冷,提速 15~20%。对于需要数百次仿真的 DOE 优化项目,累计节省数天至数周时间。
Q6:AI 替代模型训练需要多大的 GPU 显存?
| 替代模型类型 | 训练数据量 | 网络规模 | 推荐显存 | 推荐 GPU |
|---|---|---|---|---|
| 全连接神经网络(FNN) | 1万~10万组 | 5~10层 | 8~16 GB | RTX 5080 16GB |
| 卷积神经网络(CNN) | 10万~100万组 | ResNet-50 级 | 16~24 GB | RTX 4090 24GB |
| Transformer 替代模型 | 100万+ 组 | ViT/Swin 级 | 40~80 GB | A100 40GB/80GB |
| 大模型微调(LoRA) | 10万+ 指令对 | 7B~13B 参数 | 24~40 GB | RTX 4090 / A100 40GB |
| 70B 大模型本地部署 | — | INT8 量化 | 40~80 GB | A100 80GB |
对于 LSDYNA 的替代模型(应力-应变响应预测),通常 FNN/CNN 级别 即可满足,RTX 5090D 32GB 绰绰有余。若需同时部署 32B+ 大模型 进行报告生成,则建议 A100 80GB。
Q7:LSDYNA 仿真数据如何高效喂给 AI 模型?
典型数据流如下:
- 数据生成:LSDYNA 输出 d3plot(二进制结果文件)、binout(ASCII 数据)、K 文件(输入文件)
- 特征提取(CPU + 大内存):Python 脚本(PyDyna 或自研)提取关键曲线(力-位移、加速度-时间、应力云图特征)
- 数据集构建(高速 SSD):将(几何参数 + 材料参数 + 载荷参数 → 响应指标)映射为监督学习数据集
- 模型训练(GPU):PyTorch 训练神经网络替代模型
- 大模型融合(GPU):将替代模型封装为 API,供本地部署的 DeepSeek/LLaMA 调用,实现自然语言问答与报告生成
硬件瓶颈:d3plot 文件可达 数十 GB 至数百 GB,特征提取阶段需频繁随机读取,高速 NVMe SSD(≥7GB/s) 可显著缩短预处理时间。UltraLAB 全系配置的 14GB/s NVMe Gen5 SSD 为此提供了充足保障。
八、结语:让碰撞仿真与 AI 智能同频共振
LSDYNA 的每一次显式时间积分,都是对物理极限的精确追踪;AI 大模型的每一次推理,都是对设计效率的指数级释放。两者的融合,正在让汽车安全、航空航天、国防装备的研发从 "经验试凑" 走向 "数据+物理双驱动"。
UltraLAB 异构超算工作站的核心价值,在于为这一融合提供 "无短板"的硬件底座:
- 高频超频 CPU:让显式求解的千万步积分不再等待,让隐式求解的稀疏矩阵快速收敛
- 大容量多通道内存:为千万级网格的隐式分析提供充足"弹药",避免 Out-of-Core 降速
- 大显存多卡 GPU:让 32B~70B 大模型在本地流畅运行,替代模型训练效率倍增,LSDYNA GPU 加速锦上添花
- 水冷系统:保障 CPU/GPU 双满载下的持续峰值性能,白天跑仿真、夜间训模型无缝切换
如需获取 LSDYNA 千万级网格仿真 + AI 大模型一体化工作站的详细报价与实测数据,欢迎联系 UltraLAB 技术顾问
- 官网:www.xasun.com
- 咨询热线:400-705-6800
- 微信公众号:100369800 或 xasun001
- 远程测试:支持 LSDYNA 显式/隐式实测与 AI 大模型部署演示


