






在先进工艺节点(7nm、5nm、3nm甚至2nm)的芯片设计战场上,物理实现(Physical Implementation)是最"烧钱、烧时间、烧机器"的环节之一。Synopsys Fusion Compiler 作为业界首款将逻辑综合(Synthesis)与布局布线(Place & Route)融合在同一数据模型上的 RTL-to-GDSII 一体化平台,已经成为全球顶级芯片设计公司流片的主力军——从 Arm Cortex/Neoverse 处理器核、AI加速芯片,到5G基带、车载SoC,背后几乎都有它的身影。
本文将系统拆解 Fusion Compiler 的主要软件模块、每个模块的核心功能、典型应用场景,并结合实际计算负载特点,给出 UltraLAB 高性能图形工作站/服务器的硬件配置推荐,以及芯片设计团队最常问的硬件问题分析。
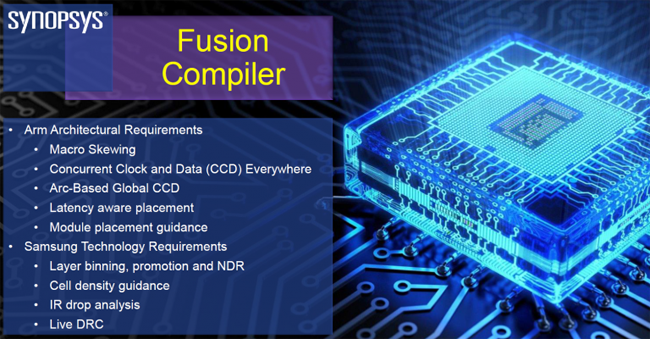
一、Fusion Compiler 是什么?为什么叫"融合(Fusion)"?
传统数字后端流程是"接力赛":Design Compiler 做综合 → IC Compiler II 做布局布线 → PrimeTime 做时序签核 → StarRC 提取寄生参数 → IC Validator 做物理验证……每个工具之间靠文件传递数据,每次迭代都要"导出—转换—导入",数据反复读写,结果反复失配,时序收敛像在拉锯。
Fusion Compiler 的革命性在于:
- 单一数据模型(Unified Data Model):综合、布局、布线、签核共用同一份内存中的设计数据库,消灭工具间的数据搬运与格式转换;
- 共用优化引擎(Common Engines):综合阶段就能看到布局布线后的真实物理效应(线延迟、拥塞、时钟偏移),做到"前方决策、后方不返工";
- 黄金签核内嵌(Golden Sign-off Backbone):PrimeTime、StarRC、PrimePower、IC Validator 等业界签核标准直接"长在"流程内部,实现 In-Design 签核,最终 QoR(结果质量)与签核结果高度一致;
- 官方数据显示:相比传统分立流程,QoR 平均提升约 20%,收敛速度和 TAT(Turn-Around Time)大幅缩短。
一句话:Fusion Compiler 把"多工具接力"变成了"一台引擎跑全程"。
二、Fusion Compiler 主要软件模块及核心功能
2.1 RTL 综合模块(Design Fusion / RTL Synthesis)
核心功能:
- 将 Verilog/VHDL/SystemVerilog 的 RTL 代码综合为门级网表,完整继承 Design Compiler NXT 的顶级综合能力;
- 物理感知综合(Physically-Aware Synthesis):综合阶段即调用布局引擎预估单元位置与走线拥塞,避免"综合时序漂亮、布线后崩溃";
- 拥塞感知重构:如 Congestion-Aware Mux Re-synthesis,自动将 AO 逻辑树重构为 MUX 结构,降低布线拥塞、改善 DRC 收敛;
- PPA 感知 IP 重选:布局后根据真实物理上下文重新选择 DesignWare 运算单元架构,压榨最后一点 PPA;
- 支持多电压域(UPF)、多角多模式(MCMM)约束,直接读入 SDC/UPF 文件。
应用场景: 高性能 CPU/GPU/NPU 核的综合、大规模 SoC 顶层综合、低功耗 IoT 芯片的多电压域设计。
2.2 布图规划与布局模块(Floorplan & Placement)
核心功能:
- 芯片布图规划:宏单元(Macro)摆放、IO/Pad 规划、电源网络(PG Mesh)设计、电压域划分;
- 全局布局(Global Placement)、合法化(Legalization)、增量布局优化;
- 先进的并发时钟与数据优化(CCD, Concurrent Clock & Data Optimization):布局阶段即对时钟偏移(Useful Skew)和数据路径联合优化,这是 Fusion Compiler 压出高频率的杀手锏;
- 支持先进节点规则:FinFET 摆放规则、多重曝光着色(Multi-Patterning Coloring)、Via Ladder 等。
应用场景: 7nm/5nm/3nm 先进节点的 Arm 核硬化、高主频网络处理器、存储控制器宏模块密集设计。
2.3 时钟树综合模块(CTS / Clock Tree Synthesis)
核心功能:
- 构建 H 树、鱼骨(Fishbone)、Mesh、多源时钟树(MSCTS)等多种时钟结构;
- 全局时钟偏移优化(Global Skew Optimization)与 Useful Skew 自动插入;
- 时钟功耗优化:时钟门控(Clock Gating)感知 CTS,降低时钟网络动态功耗(通常占芯片总功耗 30%~50%);
- 先进节点下支持 Via Pillar、时钟屏蔽、片上偏差(OCV/AOCV/POCV)建模。
应用场景: 高频率 CPU 核(3GHz+)、多时钟域复杂 SoC、对时钟抖动敏感的高速 SerDes 接口逻辑。
2.4 布线模块(Routing / Zroute)
核心功能:
- 全局布线(Global Route)、轨道分配(Track Assignment)、详细布线(Detail Route)全流程;
- 内嵌签核级时序与寄生参数模型,布线同时做时序驱动的 ECO 修复;
- 先进节点支持:EUV/多重曝光着色布线、ILS(In-design Litho Sign-off)、自动 DRC 修复(ADR);
- 布线是 Fusion Compiler 中最耗时的环节之一,也是多核并行扩展性最好的环节——官方与 AMD 的联合测试显示,高频 + 大三级缓存(3D V-Cache)的 EPYC 处理器在 Routing 负载上性能提升显著。
应用场景: 超大规模 SoC 全芯片布线(千万门级以上)、高层数金属叠层(13层+)设计、布线资源紧张的 AI 芯片阵列。
2.5 签核融合模块(Signoff Fusion)
这是"Fusion"二字的另一半精华——把 Synopsys 的黄金签核工具直接嵌入实现流程:
| 内嵌签核引擎 | 功能 |
|---|---|
| PrimeTime(静态时序分析 STA) | In-design 精确时序分析、PrimeTime ECO 自动修复(Setup/Hold/DRV/漏电),时序收敛即签核收敛 |
| StarRC(寄生参数提取) | 布局布线中实时寄生参数建模(RC Extraction),时序计算所见即所得 |
| PrimePower / PrimeShield | 动态/静态功耗分析、IR Drop(压降)与 EM(电迁移)分析、PG 网络鲁棒性检查 |
| IC Validator(物理验证) | In-design DRC/LVS 检查、金属填充(Fill)插入、可制造性(DFM)签核 |
| Formality / Formality ECO | 形式验证(等价性检查),确保综合与 ECO 后网表功能不变 |
应用场景: 流片前时序/功耗/物理三重签核、车规芯片(ISO 26262)可靠性签核、低电压近阈值设计的 IR Drop 敏感分析。
2.6 可测试性设计模块(TestMAX DFT Fusion)
核心功能:
- 扫描链插入与压缩(Scan Compression)、DFT 规则的物理感知优化;
- MBIST(存储器内建自测)、边界扫描(Boundary Scan)集成;
- DFT 逻辑在综合阶段即参与物理优化,避免测试逻辑破坏时序。
应用场景: 量产芯片的制造测试设计、良率导向的 DFT 架构、大尺寸 SoC 的测试成本控制。
2.7 AI 驱动设计空间优化(DSO.ai)
核心功能:
- 基于强化学习的设计空间自动探索:AI 自动扫描 PPA 参数组合(约束、floorplan 变体、优化策略),人难以穷尽的组合空间由机器完成;
- 实测案例:在多个先进工艺节点上,DSO.ai 找到的 PPA 点优于资深工程师手工调优结果,且项目人力投入大幅下降;
- 与云/本地计算集群配合,可并发启动数百个探索任务。
应用场景: 激进频率目标的高性能核、PPA 极限压榨、人力紧张但项目节点紧的设计团队。
2.8 3DIC / 多裸片集成(3DIC Compiler 协同)
核心功能:
- Chiplet/2.5D/3D 封装的多裸片协同设计:Die-to-Die 接口规划、TSV/混合键合(Hybrid Bonding)凸点规划;
- 多裸片联合热分析、跨裸片时序签核。
应用场景: AI 训练芯片(HBM + 计算芯粒)、Chiplet 架构服务器 CPU、先进封装(CoWoS/Foveros)项目。
三、典型应用场景一览
| 应用领域 | 设计特点 | Fusion Compiler 关键能力 |
|---|---|---|
| 高性能计算/服务器 CPU | 高频(3~5GHz)、Arm Neoverse/自研核硬化 | CCD 优化、Useful Skew、高频 CTS |
| AI 加速芯片 | 超大阵列、布线拥塞严重、SRAM 密集 | 拥塞感知综合、Macro 自动摆放、DSO.ai |
| 5G/网络通信 | 高吞吐数据通路、多时钟域 | 数据通路优化、MCMM 签核 |
| 汽车电子 | 车规可靠性、功能安全 | PrimeShield EM/IR、DFT、冗余设计 |
| 移动 SoC/IoT | 极致低功耗、多电压域 | UPF 全流程、时钟门控感知 CTS |
| 先进封装 Chiplet | 多 Die 协同 | 3DIC Compiler 联合设计 |
四、计算负载特点分析:Fusion Compiler 到底"吃"什么硬件?
要配好机器,先要理解负载特征。根据 Synopsys 官方与 AMD 联合发布的性能测试报告,以及大量工程实践经验,Fusion Compiler 各阶段对硬件的敏感度如下:
| 流程阶段 | 单核频率敏感度 | 多核扩展性 | 内存容量需求 | 内存带宽敏感度 | 三级缓存敏感度 | 磁盘 IO |
|---|---|---|---|---|---|---|
| RTL 综合 | ★★★★★ | ★★★(8~16核较好) | 中高 | ★★★★ | ★★★★ | 中 |
| 布局(Placement) | ★★★★ | ★★★★ | 高 | ★★★★★ | ★★★★★ | 中 |
| CTS | ★★★★ | ★★★ | 中高 | ★★★★ | ★★★★ | 低 |
| 布线(Routing) | ★★★ | ★★★★★(16~32核扩展好) | 极高 | ★★★★★ | ★★★★★ | 高 |
| STA/签核 | ★★★★★ | ★★★★ | 高 | ★★★★ | ★★★★ | 中 |
关键结论:
- 单核高频永远是第一生产力——EDA 算法大量串行依赖,同核心数下频率高 10%,跑图时间就近乎缩短 10%。AMD 官方测试中,高频 F 系列 EPYC(4.1~4.4GHz 加速频率)在同核心数下表现最优;
- 三级缓存越大越香——千万门级设计的数据结构庞大,3D V-Cache 大缓存型号(768MB~1152MB L3)在 Routing 负载上相比普通型号有两位数的性能优势;
- 内存容量是硬门槛——大型模块(500万门+)布线单任务常需 256GB~512GB,全芯片扁平化实现可达 1TB 以上。内存不够直接 swap,速度崩塌一个数量级;
- 内存通道与带宽至关重要——8/12 通道 DDR5 平台明显优于普通 4 通道桌面平台;
- GPU 加速?基本没有。 Fusion Compiler 是纯 CPU 负载,显卡只需满足显示需求即可,预算应全部投向 CPU 高频、大缓存、大内存;
- NVMe 高速存储不可省——设计库(LIB/LEF/NDM)、网表、波形数据量大,项目数据动辄数百 GB。
五、UltraLAB 硬件配置推荐
UltraLAB(西安坤隆计算机科技有限公司)专注超频定制工作站,针对 Fusion Compiler 这类 EDA 负载的"高频 + 大缓存 + 大内存"特性,提供三档典型方案:
方案一:模块级设计工作站(入门/中小团队)
| 部件 | 配置 |
|---|---|
| CPU | Intel Core Ultra 9 285K(24核,P核5.7GHz,压缩机/360水冷超频,全核锁定5.4GHz+) |
| 内存 | 128GB DDR5 6400(2×64GB,双通道高频低时序) |
| 硬盘 | 4TB NVMe PCIe 4.0 SSD(系统+项目) |
| 显卡 | RTX 2000 Ada 16GB(仅显示需求) |
| 散热 | 定制静音水冷 / 500W 压缩机制冷 |
| 电源 | 1000W 白金 |
适用: 100万~500万门模块级 RTL-to-GDSII、IP 核硬化、教学科研。优势: 极致单核频率,综合/CTS/STA 阶段速度对标昂贵服务器,性价比高。
方案二:主力设计工作站(推荐配置)
| 部件 | 配置 |
|---|---|
| CPU | AMD 锐龙线程撕裂者 9980X(64核,Zen5,水冷超频)或 Intel 至强 w7-3595X(60核) |
| 内存 | 512GB DDR5(8通道插满,4800~5600MT/s) |
| 硬盘 | 2×4TB NVMe PCIe 5.0 SSD(RAID0 项目盘)+ 16TB 企业级 HDD 备份 |
| 显卡 | RTX 4000 Ada 20GB |
| 散热 | 双 360 冷排定制水冷 |
| 电源 | 1600W 钛金 |
适用: 500万2000万门级 SoC 子系统、7nm/5nm 模块物理实现、多任务并发(24 个 Job 并行)。优势: 多通道大内存 + 高核数,布线并发扩展性充分释放。
方案三:旗舰级 EDA 服务器(全芯片/先进节点)
| 部件 | 配置 |
|---|---|
| CPU | AMD EPYC 9684X(96核,1152MB 3D V-Cache 三级缓存)单路,或双路 EPYC 9654(共192核) |
| 内存 | 768GB~1.5TB DDR5 4800(12通道×64GB/128GB 插满) |
| 硬盘 | 4×3.84TB NVMe U.2 企业级 SSD(RAID10) |
| 网络 | 双万兆/25GbE,对接 License 服务器与计算集群 |
| 散热 | 整机柜级静音水冷 / 机房部署 |
适用: 3nm/5nm 全芯片扁平化实现、DSO.ai 大规模并发探索、多项目并行流片冲刺。优势: 超大 L3 缓存 + 12 通道内存带宽,正是 AMD 官方实测 Fusion Compiler Routing 性能最强的平台形态。
UltraLAB 交付承诺: 出厂预装 RHEL/Rocky Linux 及 EDA 运行环境,完成 BIOS 级调优(超频锁定、NUMA 绑定、SMT 开关策略、内存通道验证),可配合 LSF/SLURM 集群调度部署,开机即用,并提供 License 服务器搭建支持。
六、常见问题(FAQ):Fusion Compiler 硬件配置分析
Q1:Fusion Compiler 是吃单核还是多核?预算有限先保哪个?
A:先保单核频率,再谈核数。EDA 核心算法(时序驱动优化、增量修复)存在大量串行依赖,实测单任务高效利用核数约 8~16 核(布线阶段可达 32 核)。16 核 4.4GHz 的机器,跑单任务通常快于 32 核 3.0GHz 的机器。预算分配优先级:高频 CPU > 内存容量 > 核数 > 存储。
Q2:内存到底要配多大?
A:经验公式——每个并发 Job 预留 64GB~256GB。
- 模块级(<500万门):128GB 够用,256GB 从容;
- 子系统级(500万~2000万门):512GB 起步;
-
全芯片扁平化(先进节点):1TB 以上。
宁多勿少:内存耗尽触发 swap 后,跑图时间不是变慢 50%,而是变慢 10 倍以上。
Q3:AMD 3D V-Cache 大缓存对 Fusion Compiler 真的有用吗?
A:真有用,且有官方实测背书。Synopsys 与 AMD 的联合性能报告显示,在 Routing 负载下,采用 3D V-Cache 的 EPYC X 系列(768MB~1152MB L3)相比同代普通型号(256MB L3)有显著的运行时间与吞吐优势。物理实现阶段频繁访问海量图数据结构,大缓存直接减少内存往返。先进节点布线任务,优先选 X 系列缓存型号。
Q4:需要配高端显卡跑 GPU 加速吗?
A:不需要。Fusion Compiler 为纯 CPU + 内存型负载,不参与 GPU 通用计算。显卡按显示与版图查看需求(GDS 版图浏览)配 RTX 2000/4000 Ada 级别即可。把显卡预算挪给内存和 CPU,收益大得多。
Q5:桌面超频工作站 vs 传统服务器,怎么选?
A:看团队规模与任务形态——
- 个人/小组、模块级为主:Ultra 9 285K 超频水冷工作站,单核频率碾压同价服务器,综合/签核类任务速度惊人;
- 5~20 人团队、子系统级:线程撕裂者/至强 W 单路工作站,兼顾频率、通道数与扩展;
-
流片冲刺、多项目并发、DSO.ai:EPYC 服务器 + LSF 集群是标准答案。
很多客户的真实形态是"超频工作站做日常迭代 + EPYC 服务器做最终收敛"的混合架构,UltraLAB 可提供整体方案。
Q6:操作系统用 Windows 还是 Linux?
A:必须 Linux(RHEL 8.x/Rocky Linux 为主流认证环境),Fusion Compiler 不提供 Windows 版本。UltraLAB 出厂预装认证兼容的 Linux 发行版及依赖库,并可选配 Windows 虚拟机用于办公文档。
Q7:存储怎么配?项目数据放在哪?
A:三层结构——
- 工作层:NVMe PCIe 4.0/5.0 SSD(NDM 库、当前项目,随机读写密集);
- 归档层:企业级 SATA HDD 或 NAS(历史版本、GDS 存档);
-
备份层:异地/磁带(流片数据无价,RAID 不是备份!)。
单项目先进节点全流程数据量约 200GB~1TB,按并发项目数×3 倍冗余规划容量。
Q8:BIOS 层面有什么需要特别注意的?
A:三个关键项——
- SMT/超线程:EDA 物理实现负载建议关闭 SMT(物理核满载场景超线程反而引入调度抖动,AMD 官方测试配置即为 SMT=OFF);
- NUMA:多路/多 CCD 平台设置 NPS=2 或按 Job 做 NUMA 绑定,减少跨节点内存访问;
-
电源策略:设为 Performance/throughput-performance,锁定全核频率,避免 DVFS 降频。
UltraLAB 出厂机器均已完成上述调优并附测试报告。
七、结语
Fusion Compiler 用"融合"消灭了工具间的鸿沟,把芯片物理实现带进了 RTL-to-GDSII 一体化时代;而要让这台融合引擎全速运转,硬件必须精准匹配其"高单频、大缓存、大内存、高带宽"的胃口。
UltraLAB 深耕超频工作站与 EDA 计算平台多年,从模块级设计工作站到全芯片流片服务器,提供出厂预调优、开机即用的完整解决方案,让您的每一次跑图都快人一步。
关键词: Synopsys Fusion Compiler、RTL-to-GDSII、物理实现、布局布线、PrimeTime 签核、DSO.ai、EDA 工作站、UltraLAB、超频工作站、芯片设计硬件配置、先进工艺节点流片
(本文部分技术参数参考 Synopsys 官方资料及 AMD/Synopsys 联合性能测试报告,实际配置请结合设计规模与工艺节点咨询 UltraLAB 技术团队。)


