






一、从微电子所最新突破看TCAD的战略价值
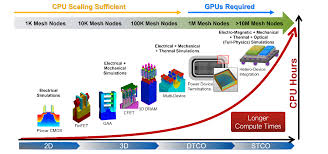
近日,中国科学院微电子研究所EDA中心在二维存储器与先进逻辑器件TCAD仿真领域取得系列重要进展,相关成果连续发表于IEEE Electron Device Letters和IEEE Transactions on Electron Devices等国际顶刊。这些研究围绕后摩尔时代器件-电路协同设计的核心痛点——界面量子输运、亚1nm节点互连架构、纳米尺度非傅立叶热效应——展开,标志着我国在先进工艺仿真自主工具链建设上迈出关键一步。
对于高校教授、集成电路设计工程师和EDA领域科研人员而言,一套能够同时覆盖量子尺度输运模拟、三维器件电热耦合分析、工艺-器件-电路协同优化的TCAD(Technology Computer Aided Design)仿真平台,已成为突破2nm以下节点技术瓶颈的必备基础设施。
二、软件定位与主要应用场景
该TCAD仿真平台定位于后摩尔时代器件-电路协同设计,核心解决传统TCAD工具在二维材料、三维堆叠结构、量子限域效应下的建模盲区。其主要应用场景包括:
1. 二维存储器高速编程机理仿真 针对二维材料闪存(2D Flash Memory)亚纳秒级编程速度需求,平台建立含时量子输运模拟框架,精确复现热载流子注入、隧穿及电荷捕获全过程,为浮栅/隧穿氧化层界面优化提供原子级设计依据。
2. CFET互补场效应晶体管架构设计 面向亚1nm逻辑节点,平台支持新型混合沟道互补FET(HC-CFET)的器件-互连协同仿真。通过三维电磁场与载流子输运耦合分析,优化源漏通孔布局与信号互连方案,在垂直堆叠密度提升的同时抑制寄生电容与RC延迟。
3. 纳米尺度瞬态热管理建模 针对CFET等三维堆叠结构的自热效应,平台突破传统傅立叶传热模型的尺度限制,引入非傅立叶瞬态热模型(如双相滞后模型DPLM),精确捕捉热点温度演化与金属连接结构的热阻调控规律,为先进封装热设计提供量化支撑。
三、核心算法与计算特点
该平台的计算复杂度远超传统漂移-扩散仿真,其技术内核呈现以下鲜明特征:
1. 含时量子输运算法(第一性原理+NEGF) 采用第一性原理密度泛函理论(DFT)提取二维材料能带结构与界面势垒参数,结合非平衡格林函数(NEGF)方法求解开放边界条件下的含时薛定谔方程。该算法需在实空间与能量空间进行双重离散化,生成超大规模稀疏哈密顿矩阵,对内存容量和稀疏矩阵求解器效率提出极高要求。
2. 非傅立叶瞬态热模型(多物理场耦合) 在纳米尺度下,声子弹道输运效应显著,传统傅立叶定律失效。平台采用双相滞后(Dual-Phase-Lag, DPL)热传导模型或声子玻尔兹曼输运方程(BTE),将器件电学仿真(自热功耗提取)与瞬态热仿真强耦合,时间步长需精确到皮秒量级,空间网格需适配三维Fin/CFET的纳米级曲率。
3. 器件-电路协同优化框架 支持从TCAD器件级仿真结果(IV特性、CV特性、噪声参数)自动提取紧凑模型(Compact Model),并导入SPICE电路级仿真进行单元级(Standard Cell)与互连级(Interconnect)协同优化。该流程涉及多尺度跨层次数据传递,对存储I/O吞吐和脚本自动化处理能力要求严苛。
4. 计算负载特征总结
表格
| 计算维度 | 特征描述 | 硬件敏感点 |
|---|---|---|
| 内存占用 | NEGF矩阵维度随原子数平方增长,单器件模型常需数十至数百GB内存 | 大容量ECC内存 |
| 并行模式 | 稀疏矩阵LU分解/迭代求解以多线程共享内存并行为主;多器件参数扫描可扩展至多进程/多节点 | 高频多核CPU |
| 存储I/O | 三维网格划分文件、能带数据、瞬态热分布场数据量大,单次仿真输出可达数十GB | 高速NVMe企业级SSD |
| 数值精度 | 量子隧穿概率计算涉及指数小量,需双精度浮点(FP64)保障 | CPU FP64性能优先 |
四、UltraLAB图形工作站硬件配置推荐
基于上述算法特征,TCAD仿真并非简单"堆核"即可,而是对单核频率、内存带宽、ECC纠错、存储稳态IOPS有均衡且严苛的要求。以下针对不同仿真规模给出UltraLAB定制图形工作站配置方案:
方案A:单器件量子输运仿真工作站(个人/课题组级)
相关机型 UltraLAB A350
表格
| 组件 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | Intel Core Ultra 9 275K Plus(24核,125W TDP)或 Xeon W7-2495X(24核,4.8GHz睿频) | TCAD求解器对单核频率敏感,高频可加速稀疏矩阵分解;24核满足NEGF并行需求 |
| 芯片组 | W880芯片组 | 支持DDR5 ECC UDIMM,保障长时间仿真数据完整性 |
| 内存 | 128GB DDR5-5600 ECC UDIMM(4×32GB) | 单器件NEGF仿真峰值内存占用约80-100GB,128GB留有裕量 |
| 存储 |
系统盘:3.84TB U.2 NVMe(企业级,PLP掉电保护) 数据盘:8TB SATA |
NVMe主盘承载频繁读写的大型网格文件;SATA大容量盘归档历史项目 |
| 显卡 | RTX PRO 5000 48GB | 三维器件结构可视化、大版图渲染;72GB显存可加载整颗CFET的GDS版图 |
| 网络 | 双千兆 | 多机协同仿真时保障节点间时钟同步与数据一致性 |
| 散热 | 360mm一体式水冷 + 机箱风道优化 | 保障CPU在密集矩阵运算时持续高频不降频 |
方案B:多器件参数扫描/工艺角仿真集群节点(实验室/企业级)
相关机型 UltraLAB GA660M
表格
| 组件 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | 双路 AMD EPYC 9684X(96核×2,3D V-Cache)或 Intel Xeon Platinum 8490H(60核×2) | 工艺角扫描需同时运行数十个器件实例,超多核实现高吞吐并行 |
| 内存 | 512GB~1TB DDR5-4800 RDIMM ECC | 多实例并发时总内存需求线性增长,RDIMM支持大容量扩展 |
| 存储 | 7.68TB U.2 NVMe | 多实例并发读写对随机IOPS和稳态QoS要求极高,D7-P5520随机写220K IOPS |
| 网络 | 10GbE/25GbE 光纤网卡 + RoCE v2 | 集群节点间低延迟RDMA通信,加速分布式参数优化 |
| 系统 | Ubuntu 22.04 LTS / CentOS Stream 9 + Intel oneMKL + 自研TCAD求解器 | Linux环境对稀疏矩阵库(PARDISO、MUMPS)支持更完善 |
五、选型特别提示
-
ECC内存不可妥协:TCAD仿真常连续运行数天,单比特翻转即可导致数月迭代收敛的矩阵解作废。X14SAE/W880平台支持DDR5 ECC UDIMM,是保障科研数据完整性的底线配置。
-
NVMe必须带PLP:非傅立叶瞬态热仿真涉及皮秒级时间步长的海量状态保存,意外断电将导致整个瞬态序列重建。Intel P5530 / Solidigm D7-P5520 等企业级U.2盘内置增强型掉电保护,远超消费级M.2 SSD。
-
FP64性能优先于GPU加速:当前主流TCAD核心求解器(如NEGF、Poisson方程迭代)仍以CPU密集型稀疏线性代数为主,GPU加速收益有限。投资应优先倾斜至高主频CPU与大容量内存,显卡主要用于后处理可视化。
-
PTP时钟同步:若部署多机集群进行工艺-器件-电路跨尺度协同仿真,建议利用X14SAE板载Intel I226LM网口的IEEE 1588 PTP硬件时间戳功能,确保分布式日志与数据时间戳一致性。
结语
从二维闪存的亚纳秒量子隧穿,到CFET垂直堆叠的互连寄生优化,再到纳米尺度声子弹道热输运——后摩尔时代的每一次工艺突破,都离不开TCAD仿真平台在原子级精度与系统级效率之间的艰难平衡。一套匹配算法特征的高性能图形工作站,不仅是缩短仿真周期的工具,更是决定科研团队能否在亚1nm竞赛中抢占先机的战略基础设施。
UltraLAB定制图形工作站,基于Supermicro企业级主板平台,针对TCAD仿真的内存密集型、ECC敏感、高IOPS并发特征进行深度优化,为微电子、集成电路、EDA领域的教授与工程师提供从单器件量子输运到全芯片电热耦合分析的算力底座。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


