






导读:当英伟达B300单颗芯片功耗突破1500W,当8路GPU服务器整机功耗飙至15kW,传统有机基板在500次热循环后微凸点开裂比例超过3.2%——这不是简单的材料问题,而是热-机械-电磁三场耦合的极限挑战。璃晶智能科技在杭州萧山中试线上攻克的玻璃基板封装,需要将TGV(玻璃通孔)直径控制在10μm以内、互连密度提升10倍、10GHz信号损耗降低45%,同时承受-40°C到125°C的极端热循环。这些指标的背后,是有限元热应力仿真、计算流体力学散热分析、高频电磁信号完整性仿真、多物理场耦合可靠性评估的密集算力支撑。你的图形工作站,能否撑起玻璃基封装的数字孪生?
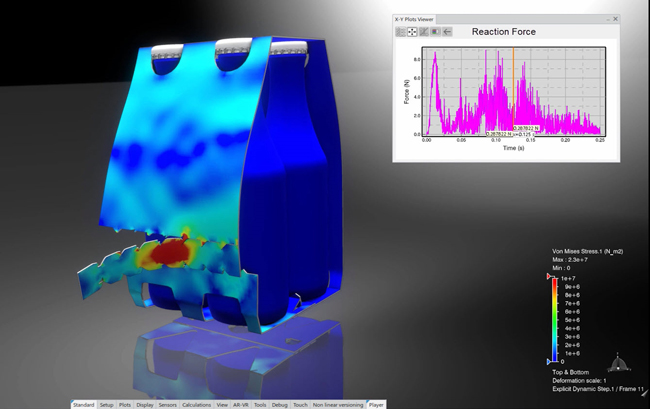
一、五大核心技术环节:玻璃基封装的仿真全链路
玻璃基板(Glass Substrate)封装不是单一技术突破,而是从材料特性到系统集成的全链条创新。每个环节都对应特定的仿真算法与算力需求:
1. TGV(玻璃通孔)微结构设计与工艺仿真
在玻璃晶圆上打出直径≤10μm的通孔,填充铜金属形成垂直互连。需仿真激光诱导刻蚀/等离子体刻蚀的形貌、电镀铜填充的均匀性、通孔边缘的应力集中。
2. 热-机械可靠性仿真(CTE匹配核心)
玻璃基板的核心优势在于热膨胀系数(CTE)可定制至3~5 ppm/°C,与硅芯片(~3 ppm/°C)几乎无缝匹配。需仿真热循环(-40°C↔125°C)下的翘曲、微凸点剪切应力、界面分层风险。
3. 高频信号完整性(SI)与电源完整性(PI)仿真
在100GHz超高频下,玻璃基板的信号损耗比硅中介层低2~3个数量级(从1 dB/cm降至0.01 dB/cm)。需精确仿真TGV-铜互连-微凸点链路的高频S参数、串扰、阻抗匹配。
4. 共封装光学(CPO)光耦合仿真
玻璃透明特性使光引擎可直接贴芯片运行。需仿真光波导在玻璃基板中的传输损耗、光-电接口耦合效率、多通道并行光链路串扰。
5. 晶圆级系统级封装(WL-SiP)多物理场耦合
将Logic芯片、HBM高带宽内存、光引擎、无源元件集成于单块玻璃基板上,需同时考虑电热耦合(焦耳热+芯片功耗)- 机械应力(CTE失配+热梯度)- 电磁干扰(高速信号+电源噪声)的相互影响。
二、四大核心算法解析:玻璃基封装仿真的数值内核
1. 有限元热-机械耦合分析(FEA)——翘曲与可靠性核心
算法原理:基于虚功原理,将玻璃基板、硅芯片、铜互连、微凸点离散为三维实体/壳体单元,求解热弹性力学方程:
plain
∇·σ + f = 0  (平衡方程)
σ = C : (ε - α·ΔT) (本构关系,含CTE热应变)-
计算瓶颈:
-
多尺度网格矛盾:晶圆级尺寸(300mm)与TGV微结构(10μm孔径)相差4个数量级,需局部加密+子模型技术
-
接触非线性:微凸点与焊盘的摩擦接触、大变形几何非线性
-
材料非线性:铜的弹塑性、玻璃的温度相关CTE、界面内聚力(Cohesive Zone)分层
-
-
算力特征:内存密集型,百万自由度模型峰值可达64~128GB;多核并行友好,ANSYS Mechanical支持32~64核并行直接求解器
2. 计算流体力学(CFD)散热仿真——1500W芯片的热管理
算法原理:求解Navier-Stokes方程与能量方程,模拟芯片-基板-散热器系统的稳态/瞬态温度场,评估微通道液冷、热电制冷(TEC)等方案。
-
计算特征:
-
多相流与相变:部分先进方案涉及两相流冷板或浸没式冷却
-
共轭传热(CHT):固体导热+流体对流耦合,界面热阻建模关键
-
瞬态热循环:-40°C↔125°C循环仿真需追踪温度梯度引起的瞬态热应力
-
-
算力映射:多核CPU(32~96核)加速每步迭代;大内存承载精细网格(微通道尺度μm级)
3. 高频电磁仿真(HFSS/FDTD)——100GHz信号完整性
算法原理:
-
有限元法(FEM):ANSYS HFSS求解Maxwell方程组,提取TGV互连的S参数、眼图、阻抗
-
时域有限差分(FDTD):Lumerical FDTD Solutions仿真光波导在玻璃基板中的传输特性
-
计算瓶颈:
-
频率墙:100GHz下波长仅3mm,网格尺寸需<λ/10(300μm),但TGV孔径10μm要求局部加密至1μm以下
-
满阵内存:HFSS频域求解器产生稠密或半稠密矩阵,万端口模型峰值内存128GB+
-
长时程瞬态:FDTD光仿真需追踪光脉冲在玻璃波导中的传播,时间步长受CFL条件限制
-
-
算力映射:高主频CPU加速稀疏/稠密矩阵迭代;多核加速频域扫描;大内存承载端口激励矩阵
4. 多物理场耦合(热-电-机械-电磁)——系统级数字孪生
算法原理:COMSOL或ANSYS Workbench耦合平台,通过顺序耦合(Sequential)或全耦合(Fully Coupled)方式,将各物理场方程联立求解。
-
计算特征:
-
矩阵规模爆炸:全耦合时,热自由度+机械自由度+电磁自由度叠加,系统矩阵维度为单物理场的3~5倍
-
内存峰值极高:玻璃基板CPO系统级模型峰值可达256GB+
-
收敛困难:强耦合非线性系统需大量牛顿-拉夫森迭代,每步需重构雅可比矩阵
-
三、计算特点总结:玻璃基封装仿真的五大算力画像
| 计算维度 | 具体表现 | 硬件影响 |
|---|---|---|
| 多尺度网格墙 | 300mm晶圆 vs 10μm TGV,局部加密导致网格量指数增长 | 大内存承载百万~千万级自由度;多核加速网格生成 |
| 多物理场内存墙 | 热-机械-电磁三场耦合,系统矩阵规模单场的3~5倍 | 内存容量为首要瓶颈,建议≥256GB |
| 高频电磁频率墙 | 100GHz要求网格<1μm,模型文件可达10GB+ | 高主频CPU加速HFSS/FDTD迭代;NVMe SSD秒级加载 |
| 热循环长时程 | -40°C↔125°C循环仿真需追踪数百个载荷步 | ECC内存防长时程数据翻转;液冷防满载降频 |
| 批量参数扫描 | CTE取值、玻璃厚度、铜填充率、凸点间距的DOE优化 | 多核并发(任务级并行)优于单任务堆核 |
核心结论:玻璃基封装仿真是"多物理场耦合吃内存、高频电磁吃主频、热循环长时程吃稳定性、批量DOE吃并发"的复合型重载。GPU对FEA/CFD核心求解加速有限,但专业显卡对复杂封装3D可视化至关重要。
四、软件工具链:从微结构到系统级
| 仿真环节 | 软件工具 | 核心功能 |
|---|---|---|
| TGV工艺仿真 | ANSYS Mechanical / COMSOL Solid Mechanics | 刻蚀形貌应力、电镀填充缺陷、通孔边缘应力集中 |
| 热-机械可靠性 | ANSYS Mechanical + Steady-State/Thermal | CTE匹配翘曲、热循环疲劳、微凸点剪切、界面分层(Cohesive) |
| 散热CFD | ANSYS Fluent / Icepak / COMSOL CFD | 芯片-基板-散热器共轭传热、微通道液冷、瞬态热循环 |
| 高频电磁SI/PI | ANSYS HFSS / Cadence Sigrity / CST Studio | TGV互连S参数、100GHz损耗、阻抗匹配、电源噪声 |
| CPO光学仿真 | Lumerical FDTD / INTERCONNECT | 玻璃波导传输、光-电耦合、多通道串扰、眼图分析 |
| 多物理场耦合 | COMSOL Multiphysics / ANSYS Workbench System Coupling | 热-电-机械-电磁全耦合、参数化扫描、优化设计 |
| EDA版图验证 | Cadence Allegro / Mentor Xpedition | 玻璃基板布线、TGV阵列版图、DRC/LVS |
五、硬件配置推荐:按封装仿真规模精准匹配
基于玻璃基封装仿真的算法特性,结合UltraLAB图形工作站产品体系,给出三档配置方案:
【方案A】TGV微结构/单芯片热应力仿真工作站
适用场景:TGV通孔应力分析、单芯片-基板热翘曲、材料参数标定、教学科研
| 硬件模块 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | Intel Core i9-14900K 超频版 (24核32线程, 5.8GHz+) | 高睿频加速ANSYS Mechanical单步牛顿迭代;24核支撑局部模型并行 |
| 内存 | 128GB DDR5-5600(4×32GB) | 覆盖TGV局部精细模型(百万自由度)+热循环多载荷步缓冲 |
| 存储 | 2TB NVMe Gen4 SSD | 秒级加载大型封装几何(.step/.igs),秒存百万网格 |
| 显卡 | NVIDIA RTX Pro 5000 32GB | 32GB显存支撑封装3D实体模型流畅旋转、TGV阵列剖面可视化、多窗口4K显示 |
| 系统 | Windows 11 Pro / Ubuntu 22.04 LTS | ANSYS/COMSOL/Lumerical官方双平台支持 |
| 显示器 | 27英寸 4K IPS | 几何窗口+网格窗口+应力云图+曲线窗口四栏同屏 |
推荐机型:UltraLAB A330 超频图形工作站(全核5.5GHz+水冷稳定输出,静音桌面级)
【方案B】晶圆级多物理场/高频SI仿真工作站(性能甜点)
适用场景:晶圆级玻璃基板翘曲分析、HBM-Logic堆叠热管理、100GHz TGV互连SI仿真、CPO光耦合分析
| 硬件模块 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | Intel Xeon W7-3465X (28核56线程, 2.5~4.8GHz) 或 AMD Threadripper PRO 7995WX (96核192线程) | Xeon W系列ECC内存保障72小时热循环仿真不宕机;Threadripper 96核在多物理场参数扫描(如CTE梯度DOE)时效率碾压 |
| 内存 | 256GB DDR5-4800 ECC RDIMM(8×32GB) | 晶圆级全耦合模型(热+机械+电磁)峰值可达180GB+;256GB为安全线 |
| 存储 | 2TB NVMe Gen4 SSD(系统+活跃项目)+ 8TB SATA企业级HDD(历史算例归档) | 企业级SSD sustained write保障频繁保存大型结果文件(.rst/.mph) |
| 显卡 | RTX Pro 6000 96GB ×1 | 96GB显存可加载完整晶圆级封装3D模型+多物理场结果叠加;支撑HFSS大型端口模型后处理 |
| 网络 | 双万兆以太网 | 远程License服务器连接(ANSYS/Cadence浮动授权),降低license冲突 |
| 散热 | 360mm液冷+机箱风道优化 | Xeon W/Threadripper满载功耗350W+,液冷确保全核睿频不降频 |
推荐机型:UltraLAB AX430 液冷图形工作站(支持8通道DDR5,最大2TB内存扩展)
【方案C】企业级封装研发/多用户CPO与系统级仿真平台(高通量)
适用场景:玻璃基板中试线工艺验证、多芯片SiP系统级数字孪生、CPO光引擎集成仿真、5~10人研发团队共享算力
| 硬件模块 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | 2× AMD EPYC 9654 (96核192线程×2, 2.4~3.7GHz) 或 2× Intel Xeon Gold 6548Y+ (32核64线程×2) | 双路提供192+物理线程,支持同时运行6~8个独立仿真Session(如不同玻璃厚度/CTE组合的DOE),实现真正的"任务级并行" |
| 内存 | 512GB DDR5-4800 ECC(16×32GB) | 多Session并发内存叠加:8个Session × 48GB = 384GB峰值,512GB预留系统与缓存 |
| 存储 | 2× 3.84TB U.2 NVMe SSD(RAID 1,系统+活跃项目)+ 16TB SATA HDD(工艺数据库) | RAID 1保障中试线仿真数据安全;U.2企业级SSD应对多用户并发读写 |
| 显卡 | RTX Pro 5000 32GB ×2 | 双卡支持多用户GPU资源隔离(vGPU),各工程师独立后处理不抢显存 |
| 系统 | Windows Server 2022 + 远程桌面服务(RDS)预配置 | 5~10人远程桌面并发,各用户独立运行ANSYS/COMSOL/Lumerical,开机即用 |
| 许可证管理 | 预配置ANSYS/Cadence License Manager浮动授权环境 | 支持多用户分时共享网络license,避免单机license浪费 |
推荐机型:UltraLAB GA660 机架式图形工作站(4U双路,支持4×双宽GPU,企业级可靠性)
六、关键选型建议:玻璃基封装仿真硬件的"三要三不要"
三要
-
要大内存+ECC,不要只看CPU主频:多物理场耦合模型内存峰值是单场的3~5倍,ECC内存是72小时热循环仿真不中断的底线,512GB容量是晶圆级全耦合的安全线
-
要高主频+多核平衡,不要纯堆低频核:HFSS电磁仿真单步迭代吃主频,ANSYS Mechanical多核并行吃线程数——全核睿频≥4.5GHz+物理核≥32核为甜点配置
-
要企业级NVMe+专业显卡+液冷:大型封装模型文件(.cas/.mph)频繁读写,NVMe保障I/O不卡;RTX Pro通过ANSYS/COMSOL官方认证;液冷确保96核满载不降频
三不要
-
不要为多物理场FEA投资多卡GPU:ANSYS Mechanical/CFD核心求解纯CPU计算,GPU加速覆盖范围有限,单卡RTX Pro已足够后处理,多卡预算应全部投入CPU+内存
-
不要忽视网格质量对内存的影响:TGV微结构网格若存在劣质单元,会导致求解器发散、内存峰值异常膨胀——硬件再强也救不了坏网格
-
不要省略远程多用户环境:封装研发团队通常5~10人共享算力做不同工艺方案对比,预装RDS+会话隔离是"开机即用"的核心价值
结语:让算力匹配封装的物理极限
玻璃基板封装的本质,是在数字空间中预演10μm TGV微结构、300mm晶圆尺度、-40°C到125°C极端环境、100GHz高频信号的复杂相互作用。当英伟达B300的1500W功耗将有机基板逼入绝境,当璃晶智能在杭州萧山中试线上验证玻璃基板的可行性——算力不再是后台支撑,而是决定封装方案能否从"实验室数据"走向"工业级量产"的前置条件。
一台高主频的CPU让HFSS的电磁迭代秒级收敛,一组大容量的ECC内存让晶圆级多物理场耦合不触碰虚拟内存的悬崖,一块专业级显卡让TGV阵列的三维应力云图实时旋转——这才是玻璃基封装数字孪生真正"可用"起来的物理底座。
UltraLAB先进封装仿真图形工作站,基于Core i9/Xeon W/Threadripper/EPYC全平台架构,提供从128GB到2TB ECC内存、从静音桌面到机架远程并发的全栈算力方案,助力半导体封装企业、高校微电子实验室、CPO研发团队,在玻璃基板设计、TGV工艺验证、热机械可靠性、高频信号完整性、共封装光学的赛道上,算清每一根通孔的应力,优化每一分贝的损耗,守住每一次热循环的边界。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


