






导读:高频电磁仿真是射频、微波及高速电子系统设计的核心支柱。本文基于全球6大主流电磁仿真软件的技术特性,深度解析有限元法(FEM)、时域有限差分法(FDTD)、矩量法(MoM)等核心算法差异,结合AI大模型本地部署的最新趋势,提供从入门到国家级的UltraLAB硬件配置全方案,帮助工程师与科研团队实现"算法-软件-算力"三位一体的最优选型。
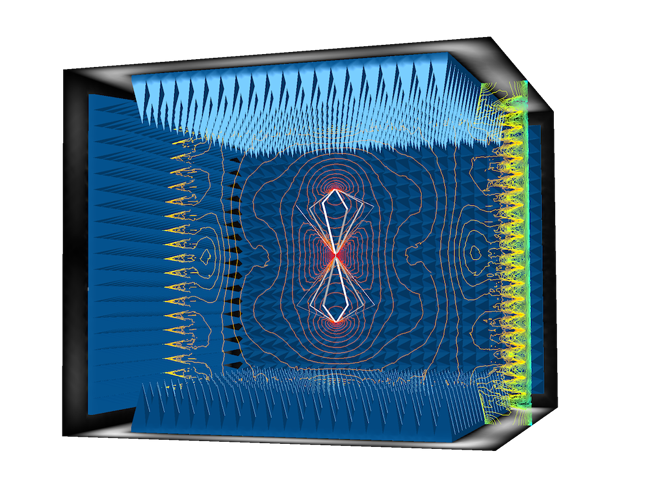
一、电磁仿真典型应用场景
高频电磁仿真利用电磁场理论和数值计算方法,对电磁波传播、辐射、散射及电磁耦合现象进行模拟分析,广泛应用于以下领域:
| 应用领域 | 典型仿真对象 | 核心关注点 | 常用算法 |
|---|---|---|---|
| 5G/6G通信 | 基站天线、毫米波阵列、Massive MIMO | 辐射方向图、S参数、效率 | FEM、FDTD、MLFMM |
| 汽车电子 | 车载雷达、智能天线、线束EMC | 电磁兼容、信号完整性 | FIT、MoM、PO |
| 航空航天 | 整机RCS、卫星载荷、隐身涂层 | 散射截面、吸波性能 | MLFMM、PO、GTD |
| 半导体封装 | 高速连接器、芯片封装、PCB SI/PI | 阻抗匹配、串扰、电源完整性 | FEM、FDTD、PEEC |
| 生物电磁 | 人体SAR、植入设备、MRI线圈 | 比吸收率、场强分布 | FDTD、FEM |
| 能源电力 | 变压器、电机、超导磁体 | 涡流损耗、多物理场耦合 | FEM、瞬态电磁 |
二、核心算法解析:从麦克斯韦方程到数值求解
不同电磁仿真软件的核心差异源于其底层数值算法。理解算法特性是硬件选型的前提:
2.1 有限元法(FEM, Finite Element Method)
- 代表软件:Ansys HFSS、COMSOL Multiphysics、EMPro
- 原理:将求解域离散为四面体/六面体网格,通过变分原理求解频域麦克斯韦方程
- 优势:精度高,适配复杂几何、各向异性材料、精细结构
- 瓶颈:稀疏矩阵求逆,内存占用大(约网格数×0.5KB),并行效率受限
- 硬件偏好:高主频CPU + 大内存容量 + 高内存带宽
2.2 时域有限差分法(FDTD, Finite-Difference Time-Domain)
- 代表软件:XFdtd、CST(时域求解器)、EMPro
- 原理:直接在时域离散麦克斯韦旋度方程,显式迭代推进
- 优势:天然宽带、瞬态分析能力强、GPU加速效率高
- 瓶颈:时间步长受CFL条件限制,精细结构需极小网格
- 硬件偏好:多核CPU + 高端NVIDIA GPU(CUDA核心)+ 中等内存
2.3 矩量法(MoM, Method of Moments)
- 代表软件:Altair Feko、CST(积分方程求解器)
- 原理:将表面积分方程离散为稠密矩阵,通过基函数展开求解
- 优势:开放域问题(天线、RCS)精度极高,无需吸收边界
- 瓶颈:内存杀手——稠密矩阵存储复杂度O(N²),10万面元约需80GB内存
- 硬件偏好:大内存 + MLFMM加速 + GPU辅助
2.4 有限积分法(FIT, Finite Integration Technique)
- 代表软件:SIMULIA CST Studio Suite
- 原理:在积分形式下离散麦克斯韦方程,兼容时域与频域
- 优势:多求解器协同(时域/频域/本征模/积分方程),EDA协同强
- 硬件偏好:多核CPU + 多GPU并行 + 大内存
2.5 物理光学法(PO, Physical Optics)
- 代表软件:Altair Feko、CST
- 原理:高频近似,将电流近似为几何光学反射场
- 优势:电大目标(整机、舰船、城市)计算效率极高
- 瓶颈:精度低于全波算法,边缘绕射需UTD/GTD修正
- 硬件偏好:多核CPU即可,GPU需求低
三、全球主流电磁仿真软件工具清单
基于软服之家软件库及行业实践,梳理全球主流高频电磁仿真软件:
| 软件名称 | 厂商 | 核心算法 | 最强优势 | 最新版本亮点 | 适用场景 |
|---|---|---|---|---|---|
| Ansys HFSS | Ansys | FEM(频域) | 精度标杆,自适应网格 | 2026 R1:GPU加速求解、Omega网格划分器、电源完整性分析 | 滤波器、相控阵、PCB SI/PI、芯片封装 |
| CST Studio Suite | Dassault SIMULIA | FIT + FEM + 时域 + MLFMM | 多求解器协同,EDA一体化 | 2026:多GPU求解、PCB分析增强、天线库优化 | 天线、EMC、宽带雷达、多物理场 |
| Altair Feko | Siemens (原Altair) | MoM + FEM + PO + MLFMM | 天线与RCS分析专家 | 2026:互易激励、多层介质涂层、自适应频率采样 | 航空航天、汽车雷达、天线阵列 |
| COMSOL Multiphysics | COMSOL | FEM + 多物理场耦合 | 多物理场耦合能力最强 | 6.4:瞬态感应边界、远场辐射、开关电弧优化 | 科研、多物理场、自定义方程 |
| PathWave EM Design (EMPro) | Keysight | FEM + FDTD | 与ADS射频电路深度协同 | 2026:3D组件库、Python API增强、量子计算仿真 | 射频器件、封装、电路-电磁联合仿真 |
| XFdtd | Remcom | FDTD | 生物电磁、城市传播、瞬态分析 | 7.11.1:远场相位差、XACT波导端口、大型PCB导入 | 生物SAR、5G城市传播、毫米波 |
四、AI赋能电磁仿真:从代理模型到数字孪生
AI大模型正在重塑电磁仿真的工作流,核心应用方向包括:
4.1 物理信息神经网络(PINN)
将麦克斯韦方程作为约束嵌入神经网络损失函数,实现"物理保真"的电磁场预测,训练数据需求低至1,000–10,000样本。
4.2 傅里叶神经算子(FNO)
学习函数空间到函数空间的映射,实现从几何参数到电磁场分布的秒级推理,替代数小时的有限元求解。
4.3 Transformer时序模型
用于失超预警、EMC实时监测等场景,处理多通道电压/温度/磁场时序数据,实现毫秒级异常检测。
4.4 生成式AI设计
基于GAN/VAE的拓扑优化,自动生成天线/超表面结构,再由传统仿真器物理验证,形成"生成-验证-筛选"闭环。
图5:电磁仿真AI代理模型工作流——从小时级仿真到秒级推理五、大模型本地部署方案与软件栈
电磁仿真大模型(如EMA3D Connect ML、自研PINN/FNO)的本地部署需要专门的软硬件栈:
5.1 推荐软件栈组合
| 层级 | 组件 | 推荐选择 |
|---|---|---|
| AI框架 | 深度学习引擎 | PyTorch + DeepSpeed + NVIDIA Modulus |
| 模型类型 | 代理模型/大模型 | PINN / FNO / Transformer / GNN |
| 数据生成 | 训练数据来源 | HFSS/CST/FEKO参数化扫描输出 |
| 训练优化 | 分布式策略 | DeepSpeed ZeRO-3 + 多GPU并行 |
| 推理部署 | 服务化框架 | TensorRT + ONNX Runtime + vLLM/TGI |
| 容器化 | 环境隔离 | Docker + Kubernetes |
| 操作系统 | 底层平台 | Ubuntu 22.04 LTS / CentOS 8+ |
5.2 大模型显存需求速查
| 模型类型 | 参数规模 | 显存需求 | 推荐GPU |
|---|---|---|---|
| MLP代理模型 | <1M | 8–16GB | RTX 4070 Ti / RTX 5080 |
| CNN/FNO-medium | 1M–10M | 16–24GB | RTX 4090 / RTX 5090D |
| FNO-large / Transformer | 10M–100M | 48–80GB | RTX A6000 / A100 80GB |
| 多物理场大模型 | 100M–1B | 80GB×2–4 | H100 80GB NVLink |
| 电磁基础大模型 | >1B | 96GB+ | RTX Pro 6000 96GB / H100×8 |
六、UltraLAB硬件配置选型指南
电磁仿真AI是"CPU有限元密集 + GPU训练密集 + 存储时序数据密集"的三重叠加场景。UltraLAB提供从入门到国家级的全产品矩阵:
6.1 个人工程师/教学入门型(预算 2–4万)
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| 机型 | UltraLAB A350 | 静音塔式,办公友好 |
| CPU | Intel i9-14900KS(24核,睿频6.0GHz) | 高主频加速HFSS网格剖分与矩阵分解 |
| GPU | NVIDIA RTX 4070 Ti SUPER 16GB | CST时域3–5倍加速,轻量AI训练 |
| 内存 | 128GB DDR5-5600 | 50万网格HFSS模型 + AI小样本训练 |
| 存储 | 2TB NVMe SSD + 8TB HDD | 热数据SSD,归档HDD |
| 适用场景 | 小型天线、滤波器、PCB SI/PI、教学演示 | — |
6.2 企业研发/中型系统型(预算 8–15万)
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| 机型 | UltraLAB A550 | 企业级工作站,7×24稳定运行 |
| CPU | Intel Xeon W-3495X(56核,4.8GHz) | 多核并行支撑CST时域 + HFSS参数扫描 |
| GPU | NVIDIA RTX 4090 24GB ×2(NVLink) | CST时域3–10倍加速,AI中等规模训练 |
| 内存 | 256GB–512GB DDR5 ECC RDIMM | 200万网格模型 + 多任务并发 |
| 存储 | 2TB NVMe(系统)+ 8TB NVMe(工作)+ 20TB NAS | 分层存储,热/温/冷分离 |
| 适用场景 | 5G基站天线、车载雷达、EMC分析、AI代理模型百万样本训练 | — |
6.3 大型通信/军工/相控阵型(预算 30–80万)
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| 机型 | UltraLAB GA660M | 双路服务器级平台 |
| CPU | 双路 AMD EPYC 9684X(192核) | 高核数支撑矩量法/PO大规模并行 |
| GPU | NVIDIA A100 80GB ×4(NVLink互联) | 10–30倍加速,电大目标 + AI大模型 |
| 内存 | 1TB–2TB DDR5 ECC RDIMM(8通道满配) | 千万网格 + AI大模型权重 + KV缓存 |
| 存储 | 4TB NVMe(系统)+ 20TB NVMe阵列 + 100TB并行存储 | 高速读写大模型文件 |
| 网络 | 100G/200G InfiniBand | 多节点集群扩展 |
| 适用场景 | 相控阵系统、整机RCS、卫星载荷、AI大模型本地部署(70B参数级) | — |
6.4 电磁仿真大模型本地部署专用型(预算 40–80万)
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| 机型 | UltraLAB A660-AI | AI训练专用静音平台 |
| CPU | AMD Threadripper PRO 7995WX(96核) | 高核数数据预处理 + 多任务并发 |
| GPU | RTX Pro 6000 96GB / A100 80GB ×2 | 96GB显存,大模型权重 + 电磁场数据 |
| 内存 | 256GB–512GB DDR5 ECC | 大模型并发 + 电磁数据集缓存 |
| 存储 | 8TB NVMe U.2 ×2(RAID0)+ 32TB HDD | 高速读写大模型文件 |
| 系统 | Ubuntu 22.04 LTS + Docker | 容器化多模型隔离 |
| 适用场景 | EMA3D Connect ML框架、PINN电磁求解、十亿参数级代理模型 | — |
6.5 旗舰科研/国家级平台型(预算 50–200万+)
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| 机型 | UltraLAB AlphaPro660 / GX880M | 超级图形工作站/多节点集群 |
| CPU | 2× AMD EPYC 9655(192核,4.1GHz) | 千万DOF模型的极致平台 |
| GPU | RTX Pro 6000 96GB / H100 80GB SXM5 ×8 | NVLink全互联,FP32 500 TFlops+ |
| 内存 | 768GB–2TB+ DDR5 ECC | 超大规模多物理场耦合 |
| 存储 | 8TB NVMe Gen5(14GB/s)+ PB级并行文件系统 | 超高速缓存 + 海量归档 |
| 网络 | 400G/800G InfiniBand全互联 | 超低延迟分布式训练 |
| 适用场景 | ITER级磁体设计、数字孪生、电磁基础大模型预训练、国家级仿真中心 | — |
七、软件清单与兼容性速查
7.1 按场景推荐的软件栈组合
| 场景 | 电磁仿真 | 电路/系统 | 多物理场 | AI优化 | 操作系统 |
|---|---|---|---|---|---|
| 射频器件设计 | Ansys HFSS | Keysight ADS | — | optiSLang | Windows/Linux |
| 天线与RCS | CST + Feko | — | — | Feko优化器 | Windows/Linux |
| PCB SI/PI | HFSS 3D Layout / CST PCB | ADS / SIwave | — | — | Windows |
| 多物理场耦合 | COMSOL RF Module | — | COMSOL结构/热 | MATLAB联动 | Windows/Linux |
| 电磁仿真+AI | HFSS/CST/FEKO | — | — | PyTorch + Modulus | Linux (推荐) |
| 国产信创环境 | iW-Sim / EastWave | — | — | MindSpore + CANN | 麒麟/UOS |
7.2 开源/免费工具补充
| 工具名称 | 类型 | 特点 |
|---|---|---|
| Meep | FDTD | MIT开发,支持并行,适合科研 |
| OpenEMS | FDTD | 开源,MATLAB/Python接口 |
| NEC-2 | MoM | 经典线天线分析,免费 |
| Scikit-rf | 电路 | Python射频网络分析库 |
八、常见问题硬件配置分析(FAQ)
Q1:HFSS和CST对硬件需求为何差异巨大?
| 维度 | HFSS(频域FEM) | CST(时域FIT) |
|---|---|---|
| 核心算法 | 稀疏矩阵求解 | 显式时域迭代 |
| CPU需求 | 高主频 > 多核(16–28核甜点) | 多核并行 + GPU加速 |
| 内存需求 | 高(网格数×0.5KB) | 中等(核数:内存=1:4–6) |
| GPU支持 | 有限(部分求解器) | 完整(3–30倍加速) |
| 最佳配置 | i9-14900KS / Xeon W-3495X | Threadripper + RTX 4090/A100 |
| 扩展性 | 多节点并行效率低 | 多节点+多GPU扩展性好 |
结论:HFSS用户投资高主频CPU + 大内存;CST用户投资多核CPU + 高端GPU。
Q2:为什么矩量法(MoM)是"内存杀手"?
矩量法求解的是稠密矩阵(非稀疏):
- 有限元(FEM):稀疏矩阵,内存复杂度 O(N)
- 矩量法(MoM):稠密矩阵,内存复杂度 O(N²)
- 100万网格FEM ≈ 500MB内存
- 10万面元MoM ≈ 80GB内存(稠密矩阵存储)
解决方案:
- MLFMM(快速多极子):O(N log N)复杂度
- PO(物理光学):高频近似,大幅降低计算量
- GPU加速MLFMM:FEKO支持,A100可加速5–10倍
Q3:消费级GPU(RTX 4090)能否用于电磁仿真AI?
| 对比项 | RTX 4090 24GB | RTX A6000 48GB |
|---|---|---|
| 显存 | 24GB | 48GB |
| ECC纠错 | 无 | 有 |
| 驱动稳定性 | 游戏驱动 | 专业驱动 |
| 7×24运行 | 不推荐 | 推荐 |
| 价格 | ~1.5万 | ~3万 |
结论:
- 个人研究/教学:RTX 4090足够,CST时域加速3–5倍
- 企业生产环境:必须用A6000/RTX Pro系列(ECC + 专业驱动 + 7×24稳定)
- AI大模型训练:A100/H100更优(显存大 + NVLink + Tensor Core)
Q4:电磁仿真AI代理模型需要多少训练数据?
| 代理模型类型 | 训练样本数 | 训练时间 | 预测速度 | 精度 |
|---|---|---|---|---|
| MLP(全连接) | 1,000–10,000 | 分钟级 | 毫秒级 | 中 |
| CNN(卷积) | 10,000–100,000 | 小时级 | 毫秒级 | 中高 |
| Transformer | 100,000–1,000,000 | 天级 | 毫秒级 | 高 |
| PINN | 1,000–10,000(+物理约束) | 小时级 | 毫秒级 | 高(物理保真) |
核心价值:AI代理模型用秒级预测替代小时级仿真,传统仿真器的参数扫描数据生成是主要时间成本。
Q5:大模型本地部署 vs 云端训练如何选择?
| 维度 | 本地部署(UltraLAB工作站) | 云端训练(AWS/Azure) |
|---|---|---|
| 数据安全 | 物理隔离,军工/涉密首选 | 需加密传输与存储 |
| 长期成本 | 2–3年ROI优于云端 | 按需付费,短期灵活 |
| 延迟响应 | <1ms实时推理 | 网络依赖,10–100ms |
| 硬件定制 | 可按算法定制CPU/GPU配比 | 固定实例规格 |
| 维护难度 | 需专业IT支持 | 托管服务,门槛低 |
建议:涉密项目、实时推理场景、长期稳定需求——选本地UltraLAB工作站;探索性研究、短期爆发需求——选云端。
Q6:内存不足时有哪些应急优化手段?
- HFSS:关闭超线程减少内存占用;切换迭代求解器;使用Mesh Fusion降低网格数
- CST:启用GPU加速减少CPU内存压力;使用PBA网格减少离散误差
- 通用:工程文件全部存放NVMe SSD,避免机械硬盘的磁盘交换;Linux系统内存管理优于Windows
- 终极方案:升级内存至主板满配,电磁仿真中内存的ROI远高于CPU代际升级
九、UltraLAB 推荐机型速查表
| 预算区间 | 机型 | 核心配置 | 适用场景 |
|---|---|---|---|
| 2–4万 | UltraLAB A350 | i9-14900KS + RTX 4070 Ti 16GB + 128GB | 个人工程师/小型器件/HFSS |
| 8–15万 | UltraLAB A550 | Xeon W-3495X + RTX 4090×2 + 512GB | 企业研发/中型系统/CST+AI |
| 20–40万 | UltraLAB A550-GPU | 7970X + A100×2 + 128GB | CST GPU专用节点 |
| 30–80万 | UltraLAB GA660M | 双EPYC 9684X + A100×4 + 2TB | 大型通信/军工/相控阵/大模型 |
| 40–80万 | UltraLAB A660-AI | 7995WX + RTX Pro 6000 96GB + 512GB | 电磁大模型本地部署 |
| 200万+ | UltraLAB GX880M | 多节点H100×8 + InfiniBand | 国家级电磁仿真中心 |
结语:构建电磁仿真的"算力护城河"
从Ansys HFSS的频域精度标杆,到CST的多求解器协同;从Altair Feko的RCS专家,到COMSOL的多物理场耦合——每一款电磁仿真软件都在特定领域构筑了技术壁垒。而AI大模型的介入,正在将"小时级仿真"压缩至"秒级推理",为5G/6G、自动驾驶、隐身设计等领域带来指数级效率提升。
然而,算法与软件的潜力释放,始终受限于硬件平台的边界。UltraLAB针对电磁仿真"CPU有限元密集、GPU训练密集、存储时序数据密集"的独特需求,提供了从128GB入门到768GB旗舰的完整产品矩阵。无论是高校实验室的第一台AI代理模型工作站,还是国家级聚变装置的数字孪生平台,选择与之匹配的算力底座,是实现技术突破的战略必需。
选型金律:模型规模决定内存下限,仿真算法匹配CPU规格,AI需求定义GPU等级,数据规模规划存储架构。
关于UltraLAB
西安坤隆计算机科技有限公司(UltraLAB)专注为科学计算、工程仿真、AI训练等场景提供超频硬件配置方案。产品线涵盖极致超频工作站、多GPU静音计算平台、超级图形服务器及分布式集群,服务国内数百家科研院所与高新技术企业。
- 官网:www.xasun.com
- 咨询热线:400-705-6800
- 技术支持:微信号 100369800
承诺:与"三最"不符(最先进 + 最快 + 最优配置),直接退货。


