






摘要:Gmsh 是开源的三维有限元网格生成器,内置 CAD 引擎与后处理器,广泛用于科研与工程前处理。本文解析其几何—网格—求解器—后处理四模块架构、二维/三维网格算法(Delaunay、Frontal、HXT 并行 Delaunay)的负载差异,指出网格生成是"高主频单线程为主、部分并行"的特殊负载,给出 UltraLAB 工作站三档选型方案。
适用读者:有限元分析工程师、计算力学/电磁/地球物理方向研究生、需要为开源求解器(FEniCSx、Code_Aster、Elmer、MOOSE 等)配套前处理平台的团队。
资料背景与核心观点
本文参考以下公开资料:
- Gmsh 官方网站(gmsh.info)与引用文献:C. Geuzaine 与 J.-F. Remacle,《Gmsh: a three-dimensional finite element mesh generator with built-in pre- and post-processing facilities》, International Journal for Numerical Methods in Engineering 79(11), 2009。该文确立了 Gmsh 的设计目标:快速、轻量、用户友好,参数化输入与高级可视化能力。
-
Gmsh Reference Manual(稳定版与开发版)。手册定义了四大模块:几何(Geometry)、网格(Mesh)、求解器(Solver)与后处理(Post-processing);输入可通过图形界面、
.geo脚本语言或 C++/C/Python/Julia/Fortran API 完成;内置 CAD 内核同时支持 OpenCASCADE 工业级 B-rep 建模与布尔运算。 - 手册中的算法选项文档:二维网格可选 Delaunay、Frontal-Delaunay、Frontal-Delaunay for Quads 等;三维网格可选 Delaunay、Frontal、HXT(并行 Delaunay,支持多线程)、MMG3D(各向异性再划分)等。
核心观点:
- Gmsh 是单机交互式前处理工具:绝大多数网格算法历史上以单线程/少线程实现,高 CPU 主频比多核心更重要;HXT 三维算法的引入改变了纯串行格局,但默认 Delaunay 路径仍以串行为主。
- 内存需求与单元数近似线性相关,千万级四面体网格需要数十 GB 内存;超大规模网格应配合分块/分层网格策略。
- 后处理与交互依赖 OpenGL 图形加速,大规模网格旋转/剖切操作的流畅度由显卡决定,而非 CPU。
主要功能模块与核心算法
几何模块
参数化脚本建模(自底向上:点→线→面→体)+ OpenCASCADE 内核(STEP/IGES/BRep 导入、布尔运算、特征修复)。CAD 内核运算(布尔、缝合、容差修复)多为单线程、对主频敏感。
网格模块
- 一维/二维:曲线离散化(按曲率自适应)、三角化(Delaunay、Frontal-Delaunay)、四边形占优(Blossom-Quad 重组)。
- 三维:Delaunay(内置四面体化)、Frontal(推进阵面)、HXT(外部并行 Delaunay 库,多线程扩展性好)、边界层(棱柱层)与各向异性再划分(MMG3D)。
- 高阶网格:1—5 阶单元生成与曲边优化(优化雅各比行列式),高阶网格生成内存占用显著高于一阶。
求解器模块
提供与外部求解器(GetDP、Code_Aster 等)的接口框架,可调用外部求解并回传结果;本身不含通用有限元求解内核。
后处理模块
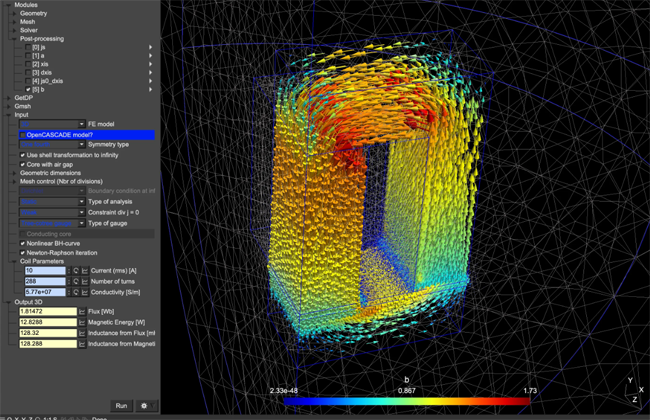
标量/矢量/张量场的等值面、流线、切面、动画与视图插值;基于 OpenGL 渲染,支持离屏批量出图。
计算特点与性能瓶颈
计算/内存密集特征
- 网格生成是典型的不规则内存访问 + 分支密集负载,SIMD 与 GPU 几乎无用武之地;CPU 主频、单核 IPC 与缓存容量决定速度。
- 内存占用约与单元数成正比:经验上数百万四面体数 GB,千万级四面体可达数十 GB(含高阶与边界层会更高)。原文未提供精确公式,以上为用户社区经验量级。
串并行特征
- 默认三维 Delaunay/Frontal 算法:基本单线程。
- HXT:多线程并行 Delaunay,是官方文档中明确的并行选项。
-
多物理域/多几何区域网格可按区域脚本化分批生成,间接利用多核;批处理模式(
-命令行)适合多任务并发。
I/O 与交互特点
- STEP/IGES 导入与 .msh 写出为大块顺序 I/O,SSD 改善明显但不是主要瓶颈。
- 交互操作(旋转、剖切、隐藏面)由 OpenGL 显卡承担,大网格需要支持新版本 OpenGL 的显卡与足够显存。
瓶颈排序
CPU 单核性能 > 内存容量 > OpenGL 显卡(交互阶段)> 存储。
典型应用场景
-
科研前处理流水线:Python API(
pygmsh/gmsh SDK)批量参数化建模 + 网格生成,脚本驱动、多任务并发,吃 CPU 主频与内存。 - 复杂 CAD 装配体网格:STEP 导入 + 布尔/修复 + 多面体网格,交互式操作多,需要均衡配置。
- 高阶曲边网格(谱元/DG 方法配套):内存需求数倍于一阶网格,需大内存余量。
- 大规模后处理可视化:对数亿自由度结果文件做切片与动画,显卡与内存共同决定体验。
UltraLAB 硬件配置建议
分档配置表
| 项目 | 入门配置(教学/中小模型) | 主流配置(工程前处理主力) | 高性能配置(大规模/高阶网格) |
|---|---|---|---|
| CPU 选型思路 | 8—12 核高主频桌面 CPU(酷睿 i7/i9 或锐龙 7/9,睿频优先) | 16—24 核高频 CPU(至强 W 高频率型号或 Threadripper 入门档),兼顾 HXT 并行与批处理并发 | 24—32 核高频工作站 CPU(Threadripper / 至强 W 满血频率档),多实例并发网格化 |
| 内存 | 32—64GB | 128GB | 256—512GB ECC(高阶曲边网格、千万级单元) |
| GPU 与显存 | 主流 OpenGL 显卡(GeForce RTX 4060 级,8GB+) | RTX A2000/RTX 4070 级 12GB+,大网格交互流畅 | 专业卡 RTX 4000 Ada 20GB 级,多显示器+大场景渲染 |
| 系统盘 | 512GB—1TB NVMe SSD | 1TB NVMe SSD | 1TB NVMe SSD |
| 项目盘 | 1—2TB NVMe SSD | 2TB NVMe SSD(CAD+网格+结果) | 4TB NVMe SSD |
| 数据盘 | 可选 | 4TB HDD | 8TB HDD 归档 |
| 散热/电源/扩展 | 风冷,650W | 风冷/水冷,850W | 工作站风道,1000W,预留大内存插槽 |
| 适用场景 | 百万级单元、教学与科研入门 | 数百万—千万级单元、交互式前处理主力 | 高阶/大规模网格、批量参数化流水线 |
推荐理由与升级方向
- 把钱花在主频与内存上,而不是核心数:除 HXT 外网格算法并行度有限,16 核高频 CPU 往往优于 32 核低频型号。
- 显卡看 OpenGL 不看 CUDA:Gmsh 无 GPU 计算;交互流畅度由 OpenGL 性能与显存决定,专业卡在多屏与稳定驱动上有优势。
- 升级路径:内存是第一升级位(网格规模增长时直接受益);需要并行网格化时改用 HXT 或多实例脚本并发,而非升级更多核的单实例。
软件清单
| 类别 | 软件 | 作用 | 必需性 |
|---|---|---|---|
| 网格生成 | Gmsh(GUI/CLI/SDK) | 几何、网格、后处理核心 | 必需 |
| CAD 内核 | OpenCASCADE(Gmsh 已内置集成) | STEP/IGES 导入与布尔运算 | 必需(随 Gmsh 提供) |
| 并行算法 | HXT(Gmsh 内置选项) | 多线程三维 Delaunay | 推荐(大规模) |
| 配套求解器 | FEniCSx / Code_Aster / GetDP / Elmer / MOOSE | 有限元求解 | 可选 |
| 编程接口 | gmsh Python API、pygmsh | 脚本化参数建模 | 推荐 |
| 后处理 | Gmsh 内置视图;可选 ParaView | 结果可视化 | 必需/可选 |
| 版本与环境 | Git、Conda/venv | 环境与脚本管理 | 推荐 |
常见问题(FAQ)
Q1:Gmsh 支持 GPU 加速吗?
不支持网格计算的 GPU 加速。GPU 只用于 OpenGL 交互渲染。选购时无需考虑 CUDA 性能,但要保证显卡 OpenGL 版本与显存。
Q2:网格生成很慢,加核有用吗?
先确认算法:默认三维 Delaunay 基本单线程,加核无效,应换高主频 CPU 或改用 HXT 并行算法;二维网格与 CAD 布尔运算也以串行为主。批量任务则用多进程并发吃满多核。
Q3:内存要多大?
与单元数近似线性:百万级单元数 GB 足够;千万级四面体建议 64—128GB 起步;高阶(3 阶以上)曲边网格建议再加倍。最准确的依据是目标模型的实际占用报告。
Q4:Gmsh 与商业前处理(HyperMesh、ANSA)相比定位如何?
Gmsh 强项是开源、可脚本化、与科研求解器生态无缝衔接;超复杂工业装配体的高效交互式六面体/混合网格仍是商业工具优势。两者常以"Gmsh 处理科研几何 + 商业工具处理量产 CAD"共存。
Q5:Linux 还是 Windows?
Gmsh 跨平台。批量流水线与集群求解器配套建议 Linux;交互式建模 Windows 亦可。性能差异主要在文件系统与脚本环境,不在 Gmsh 本身。
总结与选型建议
Gmsh 工作站的选型反常识之处在于:核心数不是关键,单核频率、内存容量与 OpenGL 显卡才是。入门档 8—12 核高频 + 32—64GB 内存即可覆盖大多数科研网格;千万级单元与高阶网格上 128—512GB 内存;并行需求通过 HXT 算法或多实例脚本解决,而非堆核心。搭配 UltraLAB 高主频工作站与适中的专业显卡,即可获得流畅的前处理与后处理交互体验。
边界与核实事项
- 网格内存占用随算法、单元阶数与几何复杂度变化大,文中数值为社区经验量级,请以实际模型报告为准。
- HXT 的并行效率随版本演进,使用前建议以当前稳定版实测。
- Gmsh 采用 GPL 许可(含便于链接外部库的例外条款),二次开发集成时需遵守相应条款。
参考来源
- Gmsh 官方网站(含文献引用与下载) — https://gmsh.info
- Gmsh Reference Manual(稳定版,MIT 镜像 PDF) — https://web.mit.edu/gmsh_v3.0.1/gmsh.pdf
- Gmsh Reference Manual(开发版) — https://gmsh.info/dev/doc/texinfo/gmsh.pdf
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



