






——Fluent GPU原生求解器、CFX旋转机械黄金标准、Rocky多GPU颗粒仿真,如何匹配硬件释放极致性能?
一、引言:CFD仿真的"算力革命"已来
计算流体力学(CFD)是现代工程设计的核心工具——从火箭发射的喷流羽焰,到汽车外形的空气动力学优化;从燃气轮机叶片的冷却通道,到电池包的热失控防护;从制药行业的混合搅拌,到食品包装的颗粒填充——流体无处不在,CFD仿真的重要性也日益凸显。
但传统CFD面临一个根本矛盾:模型精度越高,网格越精细,计算量呈指数级增长。一个整车外流场仿真可能需要数亿网格单元,一个瞬态燃烧模拟可能需要数百万时间步。没有与之匹配的算力平台,再先进的物理模型也只能停留在"理论上可行"。
Ansys Fluids 产品系列在2026 R1版本中给出了系统性答案:Fluent GPU原生求解器让通用CFD进入GPU加速时代,CFX 持续巩固旋转机械仿真黄金标准地位,Rocky 凭借多GPU技术将颗粒动力学仿真推向数千万颗粒规模,TurboGrid 实现旋转机械叶片网格全自动生成。本文将从模块组成、计算特点、应用场景到硬件配置,为您全面拆解。
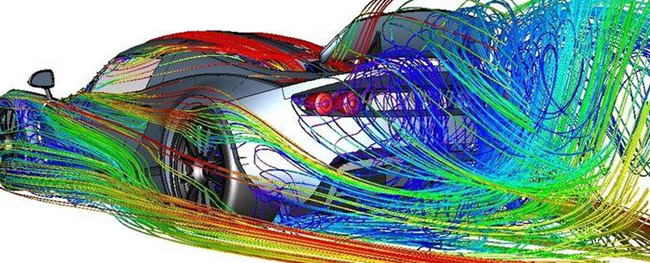
二、Ansys Fluids 核心软件模块详解
模块一:Ansys Fluent — 通用CFD黄金标准
主要功能:
-
通用流体流动、传热、质量交换、化学反应仿真
-
湍流模型(RANS、LES、DES):k-ε、k-ω、SST、Transition SST、SA等
-
多相流:VOF、Mixture、Eulerian、DPM
-
燃烧与反应流:有限速率/涡耗散、PDF、火焰面模型
-
电池电化学与热管理
-
流固耦合(FSI)
-
GPU原生求解器(2026 R1重点增强)
-
基于压力的CPU求解器(低速至高超音速)
-
基于密度的CPU求解器(可压缩/高超音速)
计算特点:
表格
| 求解类型 | 核心算法 | 计算瓶颈 | 硬件依赖 |
|---|---|---|---|
| 稳态RANS | 有限体积法,迭代求解 | 网格规模 × 非线性迭代 | CPU多核 + 内存带宽 |
| 瞬态LES/DES | 大涡模拟,时间推进 | 网格规模 × 时间步数 | CPU多核 + 大内存 |
| GPU原生求解 | CUDA加速有限体积法 | GPU显存 + CUDA核心数 | GPU显存容量 + 核心数 |
| 多相流VOF | 界面追踪 + 动量方程 | 界面重构计算量 | GPU加速显著 |
| 燃烧反应流 | 化学反应源项 + 输运方程 | 组分数量 × 反应机理 | CPU多核 + 大内存 |
| 电池电化学 | Newman模型 + 热耦合 | 多尺度(颗粒-电极-电池) | CPU多核 + 大内存 |
关键洞察: Fluent 2026 R1的 GPU原生求解器 是最大亮点。相比传统CPU求解,GPU可将求解速度提升 5-20倍(取决于模型和GPU型号)。但GPU求解对显存容量敏感——当前支持 NVIDIA RTX Ada/Ampere专业卡,显存建议 24GB以上。对于超大规模模型(>5000万网格),仍需CPU多节点并行。
应用场景:
-
汽车整车/部件空气动力学
-
航空航天外流场与推进系统
-
能源设备(燃气轮机、风电、核电)
-
化工/制药混合与反应
-
电池包热管理
-
建筑HVAC与风环境
模块二:Ansys CFX — 旋转机械CFD黄金标准
主要功能:
-
旋转机械专用CFD(泵、风机、压缩机、涡轮)
-
转子-静子相互作用模型(Mixing Plane、Stage、Transient)
-
瞬态叶栅法(TBR):全周模型降维至单通道
-
谐波平衡法(HB):非定常流动快速频域求解
-
真实气体/蒸汽模型(IAPWS、REFPROP)
-
壁面沸腾与临界热通量
-
叶片气膜冷却
-
航空力学与广义力模型
-
特性线图自动生成
计算特点:
表格
| 求解类型 | 核心算法 | 计算瓶颈 | 硬件依赖 |
|---|---|---|---|
| 稳态单通道 | 有限体积法 + MRF | 网格规模 × 湍流模型 | CPU多核 + 内存带宽 |
| 瞬态全周 | 时间推进 + 滑移网格 | 时间步数 × 全周网格 | CPU多核 + 大内存 |
| 谐波平衡 | 频域谐波展开 | 谐波数 × 网格规模 | CPU多核 + 内存 |
| TBR瞬态叶栅 | 单通道 + 相位滞后边界 | 时间步数 × 单通道网格 | CPU多核 |
| 多级叶片 | 多域耦合 + 数据传递 | 级数 × 每级网格 | CPU多核 + 大内存 |
关键洞察: CFX的 谐波平衡法(HB) 是旋转机械仿真的"杀手锏"——将非定常流动展开为谐波级数,在频域求解,速度比全瞬态快 10-100倍,精度损失可控。HB法的计算量与谐波数成正比,适合CPU多核并行。对于需要精确捕捉非定常效应(如颤振、强迫响应)的场景,瞬态全周 仍是必需,但网格规模巨大。
应用场景:
-
航空发动机燃气轮机
-
工业泵/风机/压缩机
-
水轮机/风力机
-
汽车涡轮增压器
-
制冷/空调压缩机
模块三:Ansys TurboGrid — 旋转机械叶片网格自动生成
主要功能:
-
旋转机械叶片流道全自动六面体网格生成
-
自动拓扑生成(H-grid、O-grid、C-grid混合)
-
叶尖间隙自动网格划分
-
分流叶片/二次流道网格
-
圆角/倒角自动处理
-
网格质量即时报告与修复
-
与CFX/Fluent无缝集成
计算特点:
-
网格生成非求解:计算量远低于CFD求解,但复杂叶片(如三维弯扭叶片)的拓扑生成对CPU单核性能敏感
-
六面体网格质量决定求解精度:TurboGrid生成的网格直接决定CFX求解的收敛性和精度
-
批量自动化:多工况/多叶片批量网格生成,适合脚本驱动
应用场景:
-
燃气轮机压气机/涡轮叶片
-
航空发动机风扇/压气机
-
工业泵/风机叶轮
-
涡轮增压器涡轮
模块四:Ansys Rocky — 离散元颗粒动力学(DEM)
主要功能:
-
真实颗粒形状仿真(非球形、壳体、纤维、自定义形状)
-
多GPU求解器(单主板内多GPU内存聚合)
-
颗粒破碎/磨损/内聚力模型
-
CFD-DEM耦合(与Fluent双向耦合)
-
FEA-DEM耦合(与Mechanical结构分析)
-
电磁-DEM耦合(与Maxwell)
-
SPH(光滑粒子水动力学)流体仿真
-
多体动力学与复杂几何运动
计算特点:
表格
| 求解类型 | 核心算法 | 计算瓶颈 | 硬件依赖 |
|---|---|---|---|
| DEM颗粒仿真 | 离散元法,接触搜索 + 力计算 | 颗粒数² × 时间步数 | GPU CUDA核心 + 显存 |
| 多GPU DEM | 多GPU内存聚合 + 负载均衡 | 颗粒数 × GPU数量 | 多GPU(2-4卡) |
| CFD-DEM耦合 | 流体场 + 颗粒场双向迭代 | 流体网格 × 颗粒数 | CPU+GPU协同 |
| SPH流体 | 光滑粒子水动力学 | 粒子数 × 邻域搜索 | GPU加速 |
| 颗粒破碎 | 四面体离散 + 应力断裂 | 破碎颗粒数 × 时间步 | GPU显存 |
关键洞察: Rocky的 多GPU求解器 是DEM领域的突破——传统DEM受限于单GPU显存,颗粒规模通常在百万级。Rocky通过多GPU内存聚合,将颗粒规模推向 数千万甚至上亿,且速度随GPU数量近似线性增长。2026 R1的 Fluent VOF双向耦合 和 单向耦合GPU加速 进一步扩展了应用场景。
应用场景:
-
矿山/冶金(破碎机、磨机、输送)
-
农业/食品(谷物处理、包装填充)
-
制药(片剂包衣、混合)
-
化工(催化剂床层、颗粒反应器)
-
增材制造(粉末铺展)
-
电池(电极浆料混合)
模块五:Ansys FreeFlow / Thermal Desktop(补充模块)
主要功能:
-
FreeFlow:基于Lattice Boltzmann Method(LBM)的快速流体仿真
-
Thermal Desktop:系统级热分析(航天器热控、电子散热)
计算特点:
-
FreeFlow LBM:天然适合GPU并行,适合概念设计阶段快速评估
-
Thermal Desktop:热网络法,计算量小,适合系统级热平衡分析
三、Ansys Fluids 计算特点总览
表格
| 模块 | 核心算法 | 计算密集度 | 硬件瓶颈 |
|---|---|---|---|
| Fluent(CPU) | 有限体积法,迭代求解 | ★★★★★ | CPU多核 + 内存带宽 + 容量 |
| Fluent(GPU) | CUDA加速有限体积法 | ★★★★★ | GPU显存容量 + CUDA核心数 |
| CFX | 有限体积法,旋转机械专用 | ★★★★★ | CPU多核 + 大内存 |
| TurboGrid | 自动六面体网格生成 | ★★☆☆☆ | CPU单核性能(拓扑生成) |
| Rocky(DEM) | 离散元接触搜索 | ★★★★★ | GPU CUDA核心 + 显存 |
| Rocky(多GPU) | 多GPU内存聚合 | ★★★★★ | 多GPU(2-4卡) |
| Rocky(CFD-DEM) | 流体-颗粒双向耦合 | ★★★★★ | CPU+GPU协同 |
关键洞察: Ansys Fluids的"算力密码"是差异化配置——Fluent CPU求解吃内存带宽和容量,Fluent GPU求解吃显存和CUDA核心,CFX吃CPU多核和大内存,Rocky DEM吃多GPU。一套理想的CFD工作站,必须CPU+GPU双强、内存充足、支持多GPU扩展。
四、应用场景:Ansys Fluids 的"全栈覆盖"
场景一:汽车空气动力学与热管理(★★★★★)
典型任务: 整车外流场、发动机舱热管理、电池包冷却
工作流程:
-
Fluent GPU求解器快速评估整车气动(Cd、Cl)
-
瞬态热管理仿真(发动机舱/电池包)
-
Rocky DEM分析电池电极浆料混合
-
TurboGrid生成涡轮增压器叶片网格(CFX求解)
硬件需求: GPU(Fluent GPU+Rocky DEM)+ 大内存(瞬态热管理)+ 多核CPU
场景二:航空发动机燃气轮机(★★★★★)
典型任务: 压气机/涡轮气动设计、燃烧室燃烧、叶片冷却
工作流程:
-
TurboGrid自动生成压气机/涡轮叶片网格
-
CFX稳态/谐波平衡求解叶片通道流场
-
CFX瞬态全周分析非定常效应(颤振)
-
Fluent燃烧模型仿真燃烧室反应流
-
CFX叶片气膜冷却分析
硬件需求: 多核CPU(CFX全周瞬态)+ 大内存(多级叶片)+ GPU(可选Fluent燃烧)
场景三:能源与电力(★★★★)
典型任务: 风电叶片气动、核电反应堆热工水力、换热器设计
工作流程:
-
Fluent仿真风电叶片外流场(LES/DES)
-
CFX分析水轮机转轮
-
Fluent换热器共轭传热(CHT)
-
Rocky分析燃煤/生物质颗粒燃烧
硬件需求: 大内存(LES精细网格)+ 多核CPU + GPU(Rocky颗粒)
场景四:化工与制药(★★★★)
典型任务: 反应器设计、混合搅拌、颗粒处理
工作流程:
-
Fluent多相流/反应流仿真反应器
-
Rocky DEM分析颗粒混合/破碎
-
Fluent-Rocky CFD-DEM耦合分析气固反应器
-
Fluent电池模型仿真电化学反应
硬件需求: GPU(Fluent多相流+Rocky DEM)+ 大内存(反应机理)
场景五:食品与消费品(★★★)
典型任务: 包装填充、颗粒食品处理、厨房电器设计
工作流程:
-
Rocky DEM仿真颗粒填充过程
-
Fluent-Rocky耦合分析灰尘积聚(如换热器)
-
Fluent热管理仿真电器散热
硬件需求: GPU(Rocky DEM)+ 中等内存
五、硬件配置推荐:CFD 工作站的"黄金配比"
基于Ansys Fluids多模块的差异化计算特性,我们推荐以下配置方案:
方案A:Fluent GPU 加速工作站(推荐配置)
适用场景: 通用CFD、多相流、汽车空气动力学、电池热管理
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | Intel Core i9-14900K / AMD Ryzen 9 7950X | 高主频 + 16核,前后处理与CPU求解 |
| GPU | NVIDIA RTX 5000 Ada 32GB | Fluent GPU原生求解器核心,32GB显存支持中型模型 |
| 内存 | 128GB DDR5-5600 | 支持5000万网格CPU求解 + GPU求解数据缓冲 |
| 存储 | 2TB NVMe SSD(系统)+ 4TB NVMe SSD(数据) | 大型瞬态结果文件 |
| 散热 | CPU双360水冷 + GPU定制水冷 | 持续高负载不降频 |
| 操作系统 | Windows 11 Pro / Linux | Fluent双平台支持 |
预估性能: 中等复杂度模型(2000万网格)Fluent GPU求解约 30-60分钟;同等模型CPU求解约 3-6小时。
方案B:CFX 旋转机械专业工作站(高性能配置)
适用场景: 燃气轮机、航空发动机、多级压气机/涡轮
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | AMD Threadripper PRO 7995WX (96核192线程) | 八通道内存,CFX全周瞬态求解利器 |
| GPU | NVIDIA RTX 5000 Ada 32GB | 可视化 + 可选Fluent GPU求解 |
| 内存 | 512GB DDR5-4800 ECC | 全周瞬态多级叶片网格庞大 |
| 存储 | 2TB NVMe SSD + 8TB NVMe SSD | 瞬态结果文件巨大 |
| 散热 | 定制分体式水冷(800W+级) | 96核满载+GPU持续高负载 |
| 操作系统 | Linux CentOS 7.9 / Rocky Linux 8.6 | CFX大规模并行Linux更稳定 |
预估性能: 单级压气机稳态求解约 1-2小时;全周瞬态多级涡轮约 8-16小时。
方案C:Rocky 多GPU 颗粒动力学工作站(DEM专用)
适用场景: 矿山破碎、食品包装、电池浆料、增材制造
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | AMD Ryzen 9 7950X | 前后处理 |
| GPU | NVIDIA RTX 6000 Ada 48GB × 2 | Rocky多GPU核心,双卡内存聚合达96GB |
| 内存 | 128GB DDR5-5600 | 几何导入 + 后处理 |
| 存储 | 2TB NVMe SSD + 8TB NVMe SSD | 颗粒轨迹数据巨大 |
| 散热 | 双GPU定制水冷 + CPU水冷 | 双GPU满载功耗超600W |
| 操作系统 | Windows 11 Pro | Rocky原生Windows支持 |
预估性能: 1000万颗粒DEM仿真约 2-4小时(双GPU);5000万颗粒约 8-16小时。
方案D:Ansys Fluids 全栈企业级工作站(旗舰配置)
适用场景: Fluent+CFX+Rocky+TurboGrid全引擎同时使用,多用户并发
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | 2× AMD EPYC 9654 (96核×2 = 192核) | 全引擎并行,多用户共享 |
| GPU | NVIDIA RTX 6000 Ada 48GB × 4 | 四GPU:Fluent GPU+Rocky多GPU+可视化 |
| 内存 | 2TB DDR5-4800 ECC | 全栈仿真内存需求叠加 |
| 存储 | 全闪存阵列(NVMe SSD RAID)+ NAS | 高并发I/O |
| 网络 | 双端口100GbE / InfiniBand HDR | 分布式求解低延迟 |
| 操作系统 | Linux / Windows Server 2022 | 大内存稳定性 |
预估性能: 支持5-10名CFD工程师同时工作,全链路仿真 overnight 完成。
六、配置选型核心建议
1. CPU:核心数 vs 主频 vs 内存通道
表格
| 模块 | CPU优先级 | 原因 |
|---|---|---|
| Fluent CPU | 内存通道数 > 核心数 > 主频 | 有限体积迭代受内存带宽限制 |
| Fluent GPU | 主频 > 核心数 | GPU承担求解,CPU负责前后处理 |
| CFX | 核心数 > 内存通道 > 主频 | 全周瞬态可扩展至数十核 |
| TurboGrid | 单核主频 | 网格生成串行度高 |
| Rocky | 主频 > 核心数 | DEM求解在GPU,CPU负责前后处理 |
推荐平台:
-
AMD Threadripper PRO 7995WX:八通道DDR5,96核,CFX/Fluent CPU最优
-
AMD EPYC 9654:十二通道DDR5,96核,多用户/多引擎最优
-
Intel Core i9-14900K:高主频(>5.5GHz),Fluent GPU+Rocky前后处理最优
2. GPU:Fluent GPU求解器与Rocky多GPU的"双引擎"
表格
| GPU | Fluent GPU加速 | Rocky DEM | 显存 |
|---|---|---|---|
| RTX 5000 Ada 32GB | ✅ 中型模型 | ✅ 单GPU百万颗粒 | 32GB |
| RTX 6000 Ada 48GB | ✅ 大型模型 | ✅ 单GPU数百万颗粒 | 48GB |
| A100/H100 80GB | 待验证 | ✅ 大规模DEM | 80GB |
关键建议:
-
Fluent GPU 目前支持 NVIDIA RTX Ada/Ampere专业卡,显存建议 24GB以上
-
Rocky多GPU 支持同一主板内 2-4张GPU 内存聚合,颗粒规模随GPU数量线性扩展
-
避免游戏卡(GeForce)——驱动稳定性、ECC纠错、Ansys官方认证均以专业卡为准
3. 内存:容量是"硬门槛"
表格
| 仿真类型 | 网格/颗粒规模 | 内存需求 |
|---|---|---|
| Fluent CPU(稳态RANS) | 5000万网格 | 128-256GB |
| Fluent CPU(瞬态LES) | 2000万网格 | 256-512GB |
| CFX(全周瞬态多级) | 1亿网格 | 512GB-1TB |
| Rocky(单GPU DEM) | 500万颗粒 | 64-128GB |
| Rocky(4GPU DEM) | 5000万颗粒 | 128-256GB |
4. 存储:NVMe 是"刚需"
CFD项目文件包含:
-
复杂CAD几何(.step/.iges)
-
网格文件(Fluent .msh、CFX .def)
-
瞬态结果(每个时间步数GB级)
-
颗粒轨迹(Rocky .rpc)
大型瞬态项目可达 数TB,NVMe SSD(>3GB/s)是保障效率的基础。
5. 散热:水冷是"标配"
CFD工作站通常需要GPU和CPU长时间满载:
-
RTX 6000 Ada × 4 满载约 1200W
-
Threadripper PRO 7995WX 满载约 400W
-
整机满载超 1600W
定制水冷系统是保障持续性能、避免降频的必要投资。
七、2026 R1 新功能与硬件协同
表格
| 新功能 | 计算特点 | 硬件需求 |
|---|---|---|
| Fluent GPU求解器增强 | 更多物理模型支持GPU | RTX Ada系列GPU(32GB+显存) |
| Fluent Web界面 | 远程提交与监控 | 网络带宽 |
| CFX PyCFX | Python自动化接口 | CPU多核(批量参数扫描) |
| CFX潮湿空气建模 | 冷凝过程仿真 | 多相流计算量增加 |
| TurboGrid混合网格改进 | 分流叶片自动网格 | CPU单核(拓扑生成) |
| Rocky多GPU性能提升 | DEM求解速度提升 | 多GPU(2-4卡) |
| Rocky-Fluent VOF双向耦合 | 气液固三相耦合 | CPU+GPU协同 |
| Rocky SPH-DEM耦合 | 流体-颗粒无网格耦合 | GPU加速 |
八、结语:CFD仿真的"GPU时代"已来
Ansys Fluids 产品系列通过 Fluent GPU原生求解器、CFX旋转机械黄金标准、Rocky多GPU颗粒动力学、TurboGrid自动网格生成,实现了从通用CFD到专用旋转机械、从连续流到离散颗粒的全栈覆盖。2026 R1版本的GPU加速增强、Python自动化、多物理场耦合,更进一步突破了CFD的效率天花板。
但这份"全栈"能力的释放,离不开与之匹配的硬件平台:
-
Fluent CPU 需要大内存 + 高内存带宽
-
Fluent GPU 需要大显存 + 多CUDA核心
-
CFX 需要多核CPU + 大内存
-
Rocky 需要多GPU + 显存聚合
对于从事汽车、航空、能源、化工、食品等领域的企业和科研团队而言,投资一套与Ansys Fluids能力匹配的高性能工作站,不是成本,而是缩短研发周期、降低试验成本、提升产品竞争力的战略必需。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


