






当一辆白车身(BIW)的有限元模型需要在一周内匹配全新造型线;当一套仪表板(IP)中面网格要从2周压缩到2天;当概念设计阶段还没有CAD数据,工程师却要用网格"凭空"搭建整车——这些在传统CAE流程中近乎不可能的任务,正是DEP MeshWorks深耕27年的主战场。全球75%的主机厂、通用/福特/丰田长达20年的合作背书,让这款源自美国底特律的CAE平台,成为网格变形、参数化与概念设计领域的"隐形冠军"。
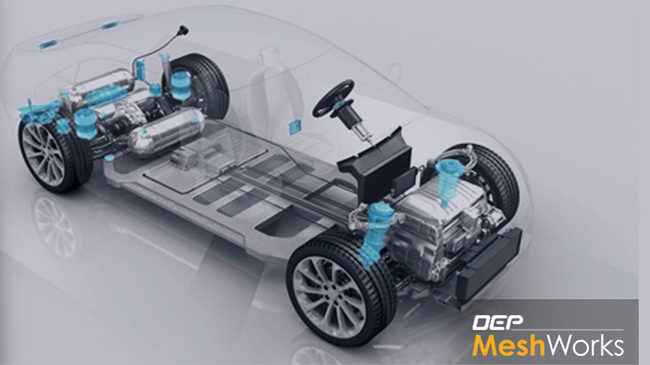
一、软件核心:不是求解器,而是"仿真驱动设计"的加速器
DEP MeshWorks 由美国 Detroit Engineered Products(DEP)公司自1998年开发,是一款CAE驱动的集成前后处理平台。它并非传统意义上的有限元求解器,而是专注于网格划分、网格变形(Morphing)、参数化建模、概念设计(ConceptWorks)和流程自动化五大核心模块,直接打通从造型变更到仿真验证的最短路径。
五大核心模块
表格
| 模块 | 核心能力 | 效率提升 |
|---|---|---|
| 网格划分 | 2D/中面/四面体/六面体全类型,AI特征识别引擎自动捕捉几何 | 中面网格比竞品快30-40% |
| 网格变形 | 特征线映射、截面变形、Control Block、Freeform等专利算法 | 整车变形效率提升60%+ |
| 参数化 | 料厚、形状、焊点、缝焊、粘胶、加强筋等全参数库 | 无需CAD即可DOE优化 |
| 概念设计 | ConceptWorks 无CAD搭建白车身、梁、接头、肋筋 | 数天完成整车CAE模型 |
| 流程自动化 | Record→Plumb→Publish 无代码拖拽式自动化 | 企业级标准化流程 |
二、计算最大环节:整车级网格变形 + 参数化DOE优化
MeshWorks 的"计算压力"并不来自求解微分方程,而集中在几何引擎的实时运算和批量模型生成两大环节。
1. 整车级网格变形(Morphing)——单模型内存与几何算法的极限挑战
这是 MeshWorks 最具技术壁垒的环节。整车级 BIW/Trim Body 模型通常包含 500万–2000万节点,Morphing 变形需要:
-
特征线映射:将造型线(Styling Line)的曲率变化映射到百万级节点坐标;
-
截面变形:基于梁截面参数的拉伸、偏置、缩放变换;
-
约束求解:保持焊点、粘胶、接触关系的拓扑一致性。
这些操作涉及大规模稀疏矩阵运算、空间插值和节点坐标批量变换,对单线程CPU主频和内存带宽极其敏感。变形精度可达0.01mm级,但代价是单步变形可能需要数秒至数十秒,整车级模型加载后内存占用可达20–50 GB。
2. 参数化DOE优化——多核并发的批量模型生成
MeshWorks 的参数化库涵盖料厚、形状、材料、焊点数量、缝焊长度、粘胶长度、拓扑位置、肋筋/隔板/冲孔等数十种参数。当与 modeFRONTIER、Isight 等优化软件耦合进行多学科MDO时:
-
一次DOE研究可能生成 50–500 个变体模型;
-
每个变体需独立执行变形→网格修复→属性更新→输出求解文件;
-
批处理模式下可充分利用多核CPU并行。
3. AI/ML Prediction——新兴的计算增长点
三、计算特点:内存为王,主频优先,GPU为辅
与ANSYS、Abaqus等求解器不同,MeshWorks作为前处理器,其计算特征呈现鲜明的"交互式几何引擎"属性:
表格
| 计算维度 | 特征描述 | 硬件敏感点 |
|---|---|---|
| 模型加载 | 整车NASTRAN/LS-DYNA模型(1–5GB文本文件)解析 | 单核主频 + 高速SSD I/O |
| 网格变形 | 百万级节点坐标实时变换、约束求解 | 内存容量 + 内存带宽 + 单核性能 |
| 自动网格划分 | AI特征识别、几何清理、质量修复 | 多核并行(批处理时)+ 大内存 |
| DOE批量生成 | 50–500个变体模型串行/并行输出 | 多核CPU + 大内存 + 高速存储 |
| 3D交互显示 | 千万级网格实时旋转、剖切、云图 | 中高端专业显卡(OpenGL加速) |
| 流程自动化 | 无代码脚本录制与回放 | CPU通用算力,无特殊需求 |
核心结论:MeshWorks 是内存密集型 + 单核性能敏感型应用,多核仅在批处理DOE时发挥价值;GPU仅用于3D可视化,不参与核心计算。
四、硬件配置推荐:UltraLAB 图形工作站方案
基于 MeshWorks 的计算特征,我们推荐以下三类配置,覆盖从个人工程师到企业级MDO优化团队:
方案一:工程师个人工作站(标准建模与变形)
适用场景:子系统级网格划分、中面网格建模、局部变形、前后处理
表格
| 组件 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | Intel Core i7-14700K / Ultra 7 265K (20C/28T, 睿频5.4GHz+) | 高主频保证单线程变形与模型加载速度 |
| 内存 | 64 GB DDR5-5600 (双通道) | 满足500万节点级整车模型加载(预留余量) |
| 存储 | 1TB NVMe SSD (PCIe 4.0) + 4TB HDD | 系统快速响应 + 模型库/模板存档 |
| GPU | NVIDIA RTX A2000 12GB / RTX 4060 Ti 16GB | 千万级网格流畅交互,支持AI Prediction模块 |
| 显示器 | 27" 4K 专业显示器 | 复杂几何细节显示 |
| 参考机型 | UltraLAB A330 | 静音塔式,适合办公室环境 |
方案二:整车级变形与参数化工作站(专业级)
适用场景:整车BIW变形、ConceptWorks概念设计、大规模DOE优化
表格
| 组件 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | Intel Core i9-14900K / Ultra 9 285K (24C/32T, 睿频5.8GHz+) | 单核主频顶尖,多核应对DOE批处理 |
| 内存 | 128 GB DDR5-6000 (四通道) | 整车级模型(1000万+节点)+ 多模型并行内存占用 |
| 存储 | 2TB NVMe SSD (PCIe 4.0, 读速7GB/s) | 5GB级求解文件秒级加载 |
| GPU | NVIDIA RTX A4000 16GB / RTX 4070 Ti SUPER | 整车模型实时变形预览、4K双屏显示 |
| 特色 | 水冷散热 + ECC内存可选 | 保障长时间DOE批量任务稳定 |
| 参考机型 | UltraLAB A350 | 超频塔式,科学计算旗舰 |
方案三:企业级MDO优化与自动化平台(旗舰级)
适用场景:多学科MDO优化、流程自动化服务器、团队共享建模平台
表格
| 组件 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | 双路 Intel Xeon W-3400 / AMD EPYC 9004 (32C–64C, 睿频3.5GHz+) | 多核并行处理50–500个DOE变体模型生成 |
| 内存 | 256 GB–512 GB DDR5-4800 ECC RDIMM | 多用户/多模型并发,ECC纠错防数据损坏 |
| 存储 | 4TB NVMe SSD (RAID 1) + 16TB NAS | 企业级数据安全 + 团队模型库共享 |
| GPU | RTX A5000 24GB / RTX 4080 SUPER 16GB | 多屏4K显示 + AI Prediction推理加速 |
| 网络 | 万兆以太网 | 团队模型文件高速共享 |
| 系统 | Windows 11 Pro / Windows Server 2022 | 支持远程桌面多用户会话 |
| 参考机型 | UltraLAB AX430/AE450 | 双路工作站/服务器,7×24稳定运行 |
五、关键优化建议
1. 内存是首要瓶颈
MeshWorks 的整车模型加载后内存占用可达 20–50 GB,加上操作系统、后处理云图缓存、DOE并行副本,128GB 是专业级底线,256GB 是企业级标配。内存不足时,Windows 会频繁换页至SSD,导致变形操作从"秒级"跌至"分钟级"。
2. 单核主频 > 核心数量
网格变形的核心算法(特征线映射、截面插值)多为单线程执行,因此 5.0GHz+ 的睿频 比 32 核 2.5GHz 的 CPU 体验更好。仅在批量DOE/自动化流程时,多核才有线性加速价值。
3. 存储速度决定模型加载体验
一个整车 LS-DYNA 关键字文件可能达 2–5 GB 文本数据,从SATA HDD加载需 2–5 分钟,从 PCIe 4.0 NVMe SSD 加载仅需 10–20 秒。对于频繁切换模型的工程师,SSD 是刚需。
4. GPU 只需"够用",无需"顶配"
MeshWorks 的 3D 显示基于 OpenGL,千万级网格的流畅旋转需要 8GB+ 显存 和适中的几何处理能力。RTX A2000/A4000 级别已足够,无需游戏卡或计算卡。
结语
在汽车研发周期从36个月压缩至18个月的今天,"等CAD数据"已成为最大的时间杀手。DEP MeshWorks 用27年时间证明:仿真可以走在设计前面,网格可以比CAD更快响应造型变更。它的计算瓶颈不在浮点峰值,而在内存容量、单核效率与存储带宽——这正是UltraLAB图形工作站的设计长板。
从子系统建模到整车变形,从概念设计到MDO优化,一台高主频、大内存、快存储的UltraLAB工作站,就是MeshWorks引擎的最佳物理底座。让几何引擎全速运转,让设计迭代无需等待——好软件+好硬件,才能让仿真真正驱动设计。
关于UltraLAB UltraLAB是西安坤隆计算机科技有限公司旗下定制图形工作站品牌,专注于科学计算、工程仿真、AI训练、影视后期等领域的硬件方案定制。我们提供从单塔式工作站到集群级的全链路算力配置,助力工程师释放软件最大潜能。


