






引言:当"散热"成为芯片战争的战略制高点
2026年5月,英伟达CEO黄仁勋随团访华的消息引发业界热议。表面看是商业外交,实则暗藏一条技术主线:AI芯片的散热问题已逼近物理极限。H100功耗700W,B200突破1000W,Blackwell架构单机柜功率超200kW;芯片局部热流密度超500W/cm²,热点处甚至高达1000W/cm²——风冷散热能力仅约1W/cm²,传统方案已无力回天。
对于国内半导体设计企业、封装测试厂、数据中心运营商以及高校微电子实验室而言,芯片电子散热仿真不再是"锦上添花"的优化工具,而是决定芯片能否稳定运行、AI集群能否持续扩展的"卡脖子"技术。从7nm/5nm/3nm制程的晶体管热点管理,到Chiplet异构集成的微尺度热阻分析,再到浸没式液冷的数据中心级热管理,散热仿真的精度与效率直接决定研发周期与产品良率。
本文将系统拆解芯片电子散热仿真的四大核心环节、五大计算特征、主流软件工具链,并给出2026年最新的UltraLAB定制图形工作站硬件配置方案,为芯片设计、封装研发与系统热管理提供算力底座。
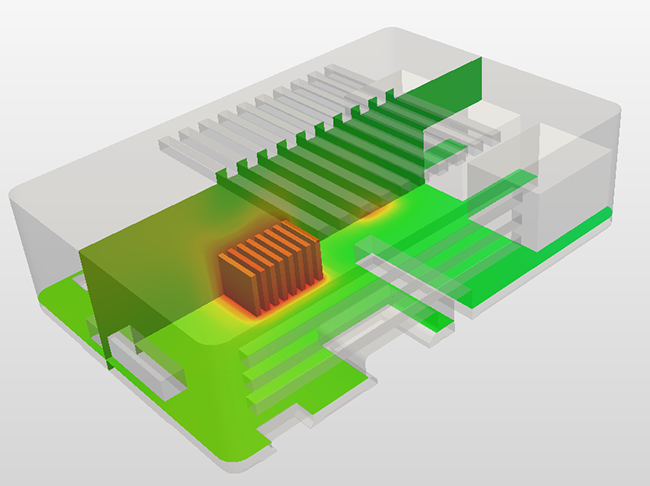
一、芯片电子散热仿真的四大核心环节
1. 芯片级(Die Level):热点识别与结温控制
这是散热仿真的"原子层",直接决定芯片能否在额定频率下长期稳定工作。
核心任务:
-
热点(Hot Spot)定位:通过芯片版图与功耗分布图(Power Map),识别逻辑单元、缓存、I/O区域的热点位置
-
结温(Tj)计算:基于热阻网络模型(Rjc、Rjb、Rja)或有限元/有限体积法,计算PN结到环境的最大温升
-
温度梯度分析:评估芯片表面温度均匀性,避免因局部过热导致的时钟偏移(Clock Skew)与电迁移(EM)
关键指标:业界通常要求消费级芯片Tj < 105°C,车规级 < 125°C,军工级 < 150°C。温度每升高10°C,芯片性能可能衰减50%,可靠性下降约50%。
2. 封装级(Package Level):微尺度热-力-电耦合
随着Chiplet与3D堆叠封装成为主流,封装已从"保护壳"演变为"热管理核心战场"。
核心任务:
-
封装热阻提取:从结到壳(Rjc)、结到板(Rjb)的精确计算,满足JEDEC标准测试条件
-
TIM(热界面材料)优化:硅脂、导热垫、金属烧结层的厚度与热导率对散热路径的影响
-
翘曲与热应力:回流焊温度循环(-40°C~150°C)下,硅片-基板-塑封料的热失配导致的Warpage与焊球裂纹
-
TSV(硅通孔)热管理:3D堆叠中TSV阵列的焦耳热与导热协同效应
仿真尺度:微米级(焊球直径100-300μm,TIM层20-100μm),需解析跨尺度几何(纳米级互连→厘米级封装体)。
3. PCB与系统级(System Level):散热器与风道/液冷设计
芯片散热最终要通过系统级方案将热量排向环境。
核心任务:
-
散热器优化:鳍片形状、间距、高度、底厚与热阻的权衡,热管/均热板(Vapor Chamber)的传热路径仿真
-
风冷系统CFD:机箱内部气流组织、风扇选型、风道阻力与噪音控制
-
液冷流道设计:冷板(Cold Plate)微通道的流阻-换热权衡、CDU(Coolant Distribution Unit)的流量分配、浸没式液冷的相变沸腾模拟
-
热-电磁耦合:大功率芯片散热路径对高速信号完整性的影响
关键阈值:单机柜功率超过30kW时,风冷已无法经济散热;液冷可支持1500W/cm²以上热流密度,PUE可降至1.2以下。
4. 数据中心级(Data Center Level):机柜-机房-能源的全链路热管理
对于AI训练集群与超算中心,散热是运营成本(OPEX)的最大构成。
核心任务:
-
机柜级热仿真:IT设备热负荷与空调送风的匹配,避免局部热点(Local Hotspot)与再循环气流
-
液冷系统动态响应:一次侧/二次侧冷却回路的瞬态行为,故障工况(泵停、泄漏)的安全评估
-
全年能耗模拟:结合气象数据与负载曲线,优化自然冷却与机械制冷的切换策略
二、五大计算特点与技术瓶颈
1. 多物理场强耦合:热-电-力-流四场协同
芯片散热绝非单纯的"传热问题"。电流通过互连产生的焦耳热(电→热)会改变材料电阻率(热→电);温度梯度引发热应力(热→力)导致封装翘曲;液冷流道中的对流换热(流→热)又受泵功与流态制约。这种四场耦合要求求解器在每个迭代步内同步更新多个物理场的矩阵方程,对内存容量与带宽提出极高要求。
2. 跨尺度网格:从纳米互连到米级机房,跨度达10⁶倍
芯片散热仿真面临极端的多尺度挑战:
-
芯片级:栅极尺度纳米级,但仿真域通常取毫米级Die
-
封装级:焊球100μm级,封装体50mm级
-
系统级:散热器鳍片间距0.5mm,机箱1m级
-
数据中心级:机柜2m级,机房100m级
技术对策:自适应网格加密(AMR)、混合维度建模(3D实体+2D壳体+1D热阻网络)、多尺度耦合(芯片级ROM→系统级降阶嵌入)。
3. 高功率密度与极端热流:局部热点远超平均
AI芯片的功率分布极度不均匀:
-
平均热流密度:H100约15-20W/cm²(整Die面积)
-
局部热点热流密度:SRAM阵列、Tensor Core区域可达500-1000W/cm²
-
瞬态脉冲:AI推理中的稀疏计算模式导致功耗在毫秒级剧烈波动
这要求仿真工具具备极端网格加密能力与瞬态非线性传热求解能力。
4. 材料非线性:温度依赖属性与相变
芯片散热路径上的材料属性随温度显著变化:
-
硅的热导率从300K时的148 W/m·K降至400K时的98 W/m·K
-
TIM材料(如导热硅脂)在高温下可能出现泵出(Pump-out)失效
-
液冷工质(如氟化液)在浸没式方案中涉及相变沸腾,需处理潜热与气液界面
5. 结果数据量爆炸:瞬态热云图与参数化扫描
一次完整的芯片封装热仿真可能涉及:
-
参数化扫描:TIM厚度(5-50μm)、热导率(1-10 W/m·K)、功耗(50-300W)的组合矩阵 → 数百个工况
-
瞬态功率循环:启动-满载-待机-满载的循环,需保存数千个时间步的温度场
-
单工况结果文件:千万级网格的3D温度场+热通量场 → 10-50GB/工况
总数据量可达TB级,对存储I/O与后处理显存提出挑战。
三、主流软件工具链与选型指南
表格
| 仿真层级 | 推荐软件 | 核心算法/模块 | 适用场景 | 硬件偏好 |
|---|---|---|---|---|
| 芯片-封装级 | COMSOL Multiphysics | 有限元法(FEM)、多物理场耦合接口(传热+电流+固体力学)、薄层近似 | Chiplet热电耦合、TSV焦耳热、封装翘曲 | 大内存(256GB+)、高频CPU |
| Cadence Celsius Thermal Solver | 有限体积法(FVM)、芯片-封装-PCB协同仿真、电-热协同(ET Co-simulation) | 大规模IC热分析、EM/IR Drop耦合 | 大内存、多核CPU | |
| ANSYS Icepak | 有限体积法、电子散热专用对象库(散热器、风扇、PCB)、网络热阻(Thermal Network) | 封装级到板级的稳态/瞬态热分析 | 多核CPU、专业显卡 | |
| 系统级 | Siemens Flotherm | 有限体积法、SmartPart电子元件库、CFD与热阻网络混合求解 | 机箱/机柜级风冷/液冷稳态设计 | 高频CPU、中等内存 |
| ANSYS Fluent | 有限体积法、多相流(沸腾/冷凝)、UDF自定义 | 液冷微通道、浸没式冷却、相变仿真 | 多核CPU、大内存 | |
| Star-CCM+ | 有限体积法、多面体网格、伴随求解器(Adjoint) | 复杂液冷流道优化、系统级CFD | 多核CPU、大内存 | |
| 数据中心级 | ANSYS Fluent / OpenFOAM | 有限体积法、 porous media模型、Boussinesq近似 | 机房气流组织、CRAC布局优化 | 多核CPU、大内存 |
| 自动化 | PyRocky / Python+COMSOL API | 脚本驱动批量参数扫描、DOE优化 | 多工况热阻提取、设计空间探索 | 多核CPU、高速存储 |
选型建议:
-
学术科研/Chiplet前沿:首选COMSOL,多物理场耦合能力最强,支持任意自定义方程
-
企业封装研发:Cadence Celsius + Icepak组合,兼顾芯片级精度与系统级效率
-
数据中心液冷:Fluent或Star-CCM+,相变与湍流模型成熟
-
快速方案对比:Flotherm,电子散热专用库可缩短建模时间50%以上
四、2026年最新硬件配置推荐方案(UltraLAB定制)
基于芯片散热仿真的多物理场、跨尺度、高内存需求特征,推荐以下配置:
方案A:芯片封装科研型(Die→Package级,COMSOL多物理场耦合)
定位:高校微电子实验室、芯片设计公司封装部门、研究生课题
相关机型:UltraLAB AX430或AR350
相关机型:UltraLAB AX430或AR350
表格
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| CPU | Intel Xeon W7-2495X (24核48线程, 睿频4.8GHz, 8通道DDR5) 或 AMD Ryzen 9 9950X (16核32线程, 睿频5.7GHz) | COMSOL的多物理场耦合对内存带宽敏感,W-2495X的8通道ECC内存提供稳定高带宽;9950X单核性能更强,适合中小规模瞬态分析 |
| 内存 | 128GB DDR5-4800 ECC RDIMM (4×32GB) | 百万级网格的3D封装体(含焊球、TIM、基板)多物理场耦合起步容量;ECC保障长时间瞬态求解不报错 |
| 显卡 | NVIDIA RTX Pro 5000 48GB | 32GB显存可流畅加载千万级网格的芯片封装温度场云图;Blackwell架构对COMSOL后处理中的复杂曲面渲染优化显著 |
| 系统盘 | 2TB NVMe Gen5 SSD | 秒级加载COMSOL大型装配体与材料库 |
| 数据盘 | 8TB NVMe U.2 SSD | 参数化扫描(100+工况)的瞬态结果存储,单工况结果10-30GB |
| 散热 | 360mm一体式水冷 | Xeon W/锐龙9950X满载功耗250W+,持续求解需稳定温控 |
| 系统 | Windows 11 Pro / Ubuntu 22.04 LTS | COMSOL双平台支持,Linux下内存管理更高效 |
求解能力预估:100-300万网格的BGA封装热电耦合(焦耳热+传热+应力),单工况4-8小时;支持50-100个参数化扫描工况批量运行。
方案B:系统级液冷专业型(PCB→机箱→液冷板,CFD+热优化)
定位:服务器厂商热设计部门、液冷解决方案商、数据中心设计院
相关机型:UltraLAB AE450
相关机型:UltraLAB AE450
表格
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| CPU | AMD Threadripper PRO 7975WX (32核64线程, 睿频5.3GHz, 8通道DDR5) | 液冷微通道CFD(千万级网格)+ 固体传热耦合对内存带宽要求高;32核支持Fluent/Icepak多工况并行 |
| 内存 | 256GB DDR5-4800 ECC RDIMM | 系统级仿真涉及PCB(数万元件)、散热器(数千鳍片)、液冷板(微通道)的联合网格,256GB是千万级网格的安全线 |
| 显卡 | NVIDIA RTX Pro 6000 MaxQ 96GB (Blackwell架构) | 96GB显存可完整加载含PCB全元件、液冷流道、温度云图的超大模型;支持COMSOL/Icepak后处理中的亿级面片流畅操作 |
| 存储 |
系统盘:4TB NVMe Gen5 SSD 数据阵列:7.68TB×4 NVMe U.2 SSD (RAID5) |
系统级瞬态热仿真(如AI服务器启动过程)结果文件巨大(单工况50-100GB),RAID 0阵列提供28GB/s连续读写 |
| 散热 | 分体式水冷 / 压缩机散热 (2000W级) | 7975WX满载功耗350W,连续72小时瞬态功率循环仿真需工业级散热 |
| 显示 | 双27英寸 4K IPS显示器 | 左屏CFD云图,右屏PCB布局与热阻网络 |
求解能力预估:千万级网格的冷板微通道液冷CFD(Fluent/Star-CCM+),单工况8-16小时;支持3-5个系统级工况并行。
方案C:数据中心旗舰型(机柜级→机房级全尺度,多物理场+多工况)
定位:超算中心、云服务商、大型芯片企业系统架构部
相关机型:UltraLAB EA660/EX660
相关机型:UltraLAB EA660/EX660
表格
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| CPU | 双路 AMD EPYC 9684X (2×96核, 3D V-Cache, 总计192核) 或 双路 Intel Xeon Platinum 8592+ (2×64核) | 数据中心级仿真(机房100m尺度)网格数可达5000万-1亿;双路EPYC的16通道DDR5提供极致内存带宽,3D V-Cache提升缓存命中率 |
| 内存 | 512GB - 1TB DDR5-4800 ECC RDIMM | 全尺度机房气流+液冷回路+IT设备热负荷的联合仿真,1TB内存可支撑全年8760小时动态能耗模拟 |
| 显卡 | 双卡 NVIDIA RTX Pro 6000 96GB (总显存192GB) | 双卡NVLink互联,192GB总显存可加载超大规模机房CFD结果;支持分布式后处理 |
| 存储 |
全闪存架构: • 系统层:4TB NVMe Gen5 • 数据层:15.36TB NVMe U.2×4 (RAID 5) |
全年瞬态仿真结果(每时间步保存全场数据)可达数十TB;全闪存阵列保障I/O不成为瓶颈 |
| 散热 | 机架式4U-7U定制风道 + 压缩机级液冷 | 双路EPYC+双GPU功耗超2000W,需机房级精密散热 |
| 网络 | 双万兆以太网 | 接入BIM/DCIM平台与气象数据库 |
求解能力预估:5000万网格的机房CFD全年能耗模拟,单工况48-72小时;支持10个以上系统级工况并行。
五、选型核心建议与避坑指南
1. 内存容量是芯片散热仿真的"第一性原理"
芯片封装仿真的网格规模虽不及整车CFD,但多物理场耦合(热-电-力)的自由度规模极易被低估。以COMSOL为例,一个含100个焊球的BGA封装:
-
热传导物理场:50万自由度
-
电流场(焦耳热):30万自由度
-
固体力学(热应力):150万自由度
-
全耦合总自由度:230万+
加上参数化扫描(TIM厚度×热导率×功耗 = 100组合),内存需求轻松突破128GB。建议按"目标网格数×15×物理场数×工况数"估算内存,并预留50%余量。
2. 单核高频 vs. 多核并行:不同环节的差异化需求
-
前处理(几何导入/网格划分):单核性能敏感,睿频5.0GHz+可显著缩短复杂封装体的网格生成时间
-
稳态求解:多核并行效率通常可达70-80%,核心数越多越好
-
瞬态求解:每个时间步的矩阵求解可并行,但时间步间串行,高频CPU可缩短单步耗时
-
后处理(云图渲染/动画生成):单核性能+大显存
平衡策略:选择基础频率3.5GHz+、睿频5.0GHz+的多核处理器(如Threadripper PRO系列)。
3. 液冷仿真:相变模型是"算力杀手"
浸没式液冷中的沸腾相变仿真(Fluent中的VOF+蒸发冷凝模型):
-
需极小时间步长(微秒级)捕捉气液界面
-
每个时间步需迭代求解压力-速度-温度-相分数耦合
-
计算量是单相流仿真的10-50倍
建议为液冷相变仿真单独配置旗舰级硬件,或采用稳态单相流快速筛选+瞬态相变精细验证的两阶段策略。
4. 存储:NVMe U.2是企业级唯一选择
芯片散热仿真的参数化扫描与瞬态分析产生海量数据:
-
一个100工况的参数化扫描,每工况50GB结果 → 总容量5TB
-
瞬态功率循环(1000个时间步),每步10GB → 总容量10TB
传统SATA硬盘在保存/加载时会造成CPU空等。建议采用NVMe U.2企业级固态盘组建RAID阵列,通过MegaRAID 9670W-16i等阵列卡管理。
5. 软件授权与硬件的匹配
-
COMSOL的内存使用不受License限制,但CPU核数受授权级别约束(需确认学术版/商业版的并行核数上限)
-
ANSYS Icepak已并入ANSYS Electronics Enterprise,需确认授权包含Icepak模块
-
Fluent的HPC授权按核计费,大规模并行需提前规划License预算
结语:散热仿真,是芯片性能的"最后一道闸门"
黄仁勋访华的背后,是英伟达在中国市场从95%份额跌至9.11%的焦虑,更是AI芯片散热技术从风冷迈向液冷的产业拐点。对于国内半导体产业而言,无论是追赶先进制程的芯片设计,还是构建自主可控的封装体系,亦或是部署万卡级AI训练集群,散热仿真都是无法绕过的技术高地。
从芯片级的热点溯源,到封装级的热-力-电耦合,再到数据中心级的液冷系统优化,每一次仿真的精度提升、每一轮参数的迭代优化,都在为芯片的可靠性、性能释放与能耗效率争取空间。而支撑这一切的,是一台经过专业调优的UltraLAB定制图形工作站——它不是简单的硬件堆砌,而是为芯片散热仿真的多物理场耦合、跨尺度网格与海量数据吞吐量身打造的算力引擎。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


