






——离散元法(DEM)核心算法、多物理场耦合场景与UltraLAB多GPU图形工作站硬件配置全指南
引言:当每一粒砂石都成为计算对象
在化工反应釜中,数百万颗催化剂颗粒与流体激烈碰撞;在锂电池电极压延线上,纳米级活性物质粉末在辊压下重新排布;在矿山破碎机的齿板间,数亿吨级矿石被撕裂、研磨、分级——这些看似宏观的工业过程,本质上都是离散颗粒介质的集体运动行为。
传统的连续介质力学(CFD/FEA)无法捕捉颗粒间的个体接触与断裂,而Ansys Rocky作为行业领先的离散元法(DEM, Discrete Element Method)软件,通过追踪每一颗颗粒的平动、转动、碰撞与破碎,为采矿、化工、能源、医药等领域提供了前所未有的微观尺度洞察。
更关键的是,Rocky原生支持多GPU并行求解,可处理包含数亿个真实形状颗粒的超大模型。这意味着,DEM仿真已从"百万颗粒的小试"迈向"亿级颗粒的工业级全尺度模拟"。然而,颗粒数量的每一次数量级跃升,都对GPU显存、多卡互联带宽与整机散热提出了指数级增长的硬件需求。
本文将系统解析Ansys Rocky的核心应用场景、算法计算特征,并给出2026年最新的UltraLAB多GPU图形工作站配置方案,助力科研团队与企业研发中心解锁DEM仿真的算力天花板。
一、五大核心应用场景深度拆解
1. 化工与原材料加工:搅拌、输送与分离
搅拌混合(Mixing)
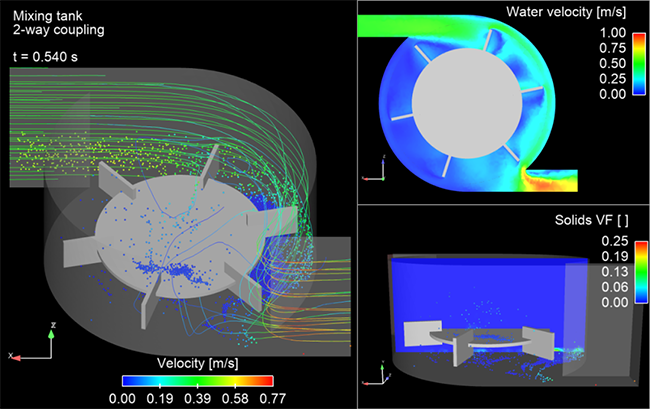
在制药、食品、聚合物行业中,多种粒径、密度的颗粒或纤维与流体混合的均匀性直接决定产品质量。Rocky可模拟螺带式、桨叶式、V型混合机内的颗粒运动轨迹,输出混合指数(Mixing Index)与功率消耗曲线,优化搅拌转速与填充率。
在制药、食品、聚合物行业中,多种粒径、密度的颗粒或纤维与流体混合的均匀性直接决定产品质量。Rocky可模拟螺带式、桨叶式、V型混合机内的颗粒运动轨迹,输出混合指数(Mixing Index)与功率消耗曲线,优化搅拌转速与填充率。
气力输送与旋风分离(Pneumatic Conveying & Cyclone Separation)
旋风分离器是化工、水泥、电力行业的核心装备。Rocky与Fluent的CFD-DEM耦合可精确捕捉颗粒在旋流场中的分级行为,预测分离效率与压降,优化入口风速与锥体角度。千万级颗粒的旋风分离仿真,是Rocky多GPU能力的典型试金石。
旋风分离器是化工、水泥、电力行业的核心装备。Rocky与Fluent的CFD-DEM耦合可精确捕捉颗粒在旋流场中的分级行为,预测分离效率与压降,优化入口风速与锥体角度。千万级颗粒的旋风分离仿真,是Rocky多GPU能力的典型试金石。
颗粒破碎(Comminution)
研磨机、破碎机中的颗粒尺寸演化是矿物加工的核心课题。Rocky内置的颗粒破碎模型可分析破碎后的尺寸分布(PSD),结合Bond断裂功理论,为磨矿介质配比与能耗优化提供定量依据。
研磨机、破碎机中的颗粒尺寸演化是矿物加工的核心课题。Rocky内置的颗粒破碎模型可分析破碎后的尺寸分布(PSD),结合Bond断裂功理论,为磨矿介质配比与能耗优化提供定量依据。
2. 高端制造与新能源:电池、磨损与结构载荷
锂电池电极压延(Calendering)
在动力电池制造中,电极浆料经涂布、干燥后进入压延工序。Rocky可模拟活性物质、导电剂、粘结剂颗粒在辊压下的重排、致密化与裂纹萌生,优化电极孔隙率与电子导电网络,直接影响电池能量密度与循环寿命。
在动力电池制造中,电极浆料经涂布、干燥后进入压延工序。Rocky可模拟活性物质、导电剂、粘结剂颗粒在辊压下的重排、致密化与裂纹萌生,优化电极孔隙率与电子导电网络,直接影响电池能量密度与循环寿命。
设备磨损评估(Erosion/Wear)
输送管路弯头、阀门、泵壳的颗粒冲刷磨损是矿山与化工设备的"慢性病"。Rocky内置多种经验磨损公式(Finnie、Oka、DNV等),可预测壁面磨损率分布与深度,辅助制定预防性维护周期,避免非计划停机。
输送管路弯头、阀门、泵壳的颗粒冲刷磨损是矿山与化工设备的"慢性病"。Rocky内置多种经验磨损公式(Finnie、Oka、DNV等),可预测壁面磨损率分布与深度,辅助制定预防性维护周期,避免非计划停机。
结构载荷分析(DEM-FEA Coupling)
散料仓、料斗、卡车车厢承受的颗粒动态载荷难以通过静力学估算。Rocky与Mechanical的耦合可将颗粒冲击力实时映射到结构网格,分析料斗壁板的应力集中与疲劳寿命,实现"散料-结构"一体化设计。
散料仓、料斗、卡车车厢承受的颗粒动态载荷难以通过静力学估算。Rocky与Mechanical的耦合可将颗粒冲击力实时映射到结构网格,分析料斗壁板的应力集中与疲劳寿命,实现"散料-结构"一体化设计。
3. 采矿与冶金:全尺度破碎筛分输送
矿石破碎与筛分
颚式破碎机、圆锥破碎机、高压辊磨机(HPGR)的腔内颗粒行为极其复杂。Rocky支持真实非球形颗粒(多面体表征),可模拟矿石在齿板间的咬合、断裂与粒度分布演化。数亿颗粒的HPGR仿真,需要4-8块GPU的并行算力支撑。
颚式破碎机、圆锥破碎机、高压辊磨机(HPGR)的腔内颗粒行为极其复杂。Rocky支持真实非球形颗粒(多面体表征),可模拟矿石在齿板间的咬合、断裂与粒度分布演化。数亿颗粒的HPGR仿真,需要4-8块GPU的并行算力支撑。
皮带输送与堆取料
矿山长距离皮带输送机的转运点撒料、料堆成型过程,可通过Rocky进行离散颗粒级仿真,优化导流板角度与带速匹配。
矿山长距离皮带输送机的转运点撒料、料堆成型过程,可通过Rocky进行离散颗粒级仿真,优化导流板角度与带速匹配。
4. 医药与食品:包衣、灌装与质量控制
药片包衣(Tablet Coating)
制药包衣机内数千颗药片在喷枪雾滴与热风流场中的翻滚、碰撞与包衣膜沉积均匀性,直接影响药物释放曲线。Rocky可追踪每颗药片的包衣厚度累积,识别"过包衣"或"欠包衣"区域。
制药包衣机内数千颗药片在喷枪雾滴与热风流场中的翻滚、碰撞与包衣膜沉积均匀性,直接影响药物释放曲线。Rocky可追踪每颗药片的包衣厚度累积,识别"过包衣"或"欠包衣"区域。
粉末灌装(Powder Filling)
胶囊、西林瓶的粉末灌装过程中,颗粒的架桥、偏析与密度不均会导致装量差异。Rocky可优化灌装针直径、下降速度与振动参数,确保批次一致性。
胶囊、西林瓶的粉末灌装过程中,颗粒的架桥、偏析与密度不均会导致装量差异。Rocky可优化灌装针直径、下降速度与振动参数,确保批次一致性。
5. 家电与环保:灰尘蓄积与热管理
热交换器灰尘蓄积
空调、冰箱的热交换器翅片间隙微小,灰尘颗粒的沉积会显著降低换热效率。Rocky-CFD耦合可模拟含尘气流在翅片间的颗粒捕集与桥接过程,指导防灰结构设计与滤网选型。
空调、冰箱的热交换器翅片间隙微小,灰尘颗粒的沉积会显著降低换热效率。Rocky-CFD耦合可模拟含尘气流在翅片间的颗粒捕集与桥接过程,指导防灰结构设计与滤网选型。
二、Ansys Rocky算法计算特点与技术瓶颈
1. DEM核心算法:N²接触检测的算力黑洞
离散元法的本质是基于牛顿第二定律,对系统中每一个颗粒进行受力分析与运动积分。对于N个颗粒,传统暴力接触检测的复杂度为O(N²)。Rocky采用空间哈希(Spatial Hashing)与邻居列表(Neighbor List) 技术将复杂度降至O(N),但当颗粒数达到千万级时:
-
每个时间步需更新所有颗粒的位置、速度、角速度
-
非球形颗粒(多面体)的接触检测比球形颗粒复杂10-100倍
-
破碎模型需实时判断颗粒是否满足断裂准则并生成子颗粒
结论:颗粒数量直接决定计算量,而GPU的众核架构(CUDA核心)是并行处理接触检测的理想载体。
2. 多GPU并行:显存容量即"颗粒容量"
Rocky是ANSYS家族中原生多GPU并行能力最强的求解器之一。其技术特征包括:
-
显存叠加:3块RTX Pro 6000 96GB通过NVLink互联,可提供288GB总显存,直接决定可加载的颗粒数量上限
-
PCIe带宽:多GPU间数据交换依赖PCIe 4.0/5.0或NVLink Bridge,带宽不足会导致并行效率断崖式下降
-
CPU-GPU协同:前处理(几何导入、颗粒生成)与后处理(渲染、统计)在CPU端完成,求解阶段几乎完全在GPU端运行
显存与颗粒数估算(以球形颗粒为例):
显存需求(GB) ≈ 颗粒数(百万) × 0.5 × 形状复杂度系数 × 安全系数1.5
例如:1000万真实非球形颗粒(多面体,系数3)→ 1000×0.5×3×1.5 = 22.5GB,建议单卡显存≥32GB。
3. 真实形状颗粒:从球体到多面体的精度跃升
Rocky支持用多面体(Polyhedron)表征真实颗粒形状(矿石、药片、纤维)。相比球形颗粒的简化假设:
-
接触点计算:需检测多面体顶点-面、边-边、面-面接触,计算量激增
-
转动惯量:非球形颗粒的转动惯量张量需实时更新
-
取向跟踪:需存储颗粒的三维取向四元数,显存占用增加
结论:真实形状颗粒的DEM仿真,对GPU算力和显存的需求是球形颗粒的5-10倍。
4. 破碎与磨损:动态拓扑与场量映射
-
颗粒破碎:母颗粒断裂后生成子颗粒,需动态更新邻居列表与接触关系,导致显存分配碎片化
-
壁面磨损:需在每个时间步将颗粒冲击能量映射到壁面网格,积累为磨损深度场,涉及GPU-CPU频繁数据回传
5. 多物理场耦合:数据交换带宽决定耦合效率
-
DEM-CFD(Fluent):双向耦合时,每个时间步需在Fluent的流体网格与Rocky的颗粒间交换曳力、速度、温度数据,内存带宽与网络带宽成为瓶颈
-
DEM-FEA(Mechanical):颗粒冲击力映射到结构有限元网格,需插值计算,对CPU-GPU协同效率要求高
6. PyRocky自动化:批量参数扫描的存储压力
通过Python脚本自动化前处理与后处理,可实现:
-
搅拌转速、填充率、颗粒粒径分布的参数化扫描
-
自动生成磨损率云图、混合指数曲线、PSD分布
批量扫描产生的结果数据量巨大:100个工况 × 1000个时间步 × 100万颗粒 = 数十TB级数据,对存储架构提出挑战。
三、2026年最新硬件配置推荐方案(UltraLAB定制)
基于Rocky的GPU密集型计算特征,推荐以下以多GPU并行为核心的UltraLAB图形工作站方案:
方案A:科研教学型(百万级颗粒,单工况分析)
定位:高校DEM实验室、研究生课题、小型搅拌槽/料斗仿真
相关机型:UltraLAB AX430 或AR350
相关机型:UltraLAB AX430 或AR350
表格
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| CPU | Intel Xeon W7-2495X (24核48线程, 睿频4.8GHz) 或 AMD Ryzen 9 9950X (16核32线程, 睿频5.7GHz) | 前处理颗粒生成与后处理渲染对单核性能敏感;多核支持PyRocky批量脚本并行 |
| GPU | NVIDIA RTX Pro 5000 48GB (Blackwell架构) 或 RTX Pro 6000 Max Q 96GB | 32GB/48GB显存可承载200-500万球形颗粒或50-100万非球形颗粒;Blackwell架构的CUDA核心数与显存带宽对DEM接触检测效率提升显著 |
| 内存 | 128GB DDR5-4800 ECC RDIMM (4×32GB) | Rocky求解时CPU内存主要用于前处理与数据缓冲,128GB可支撑500万颗粒级项目;ECC保障长时间求解稳定性 |
| 系统盘 | 2TB NVMe Gen5 SSD | 快速加载Rocky项目与ANSYS组件 |
| 数据盘 | 4TB NVMe U.2 SSD 或 8TB SATA企业级HDD | 存储颗粒轨迹动画、磨损云图、PSD统计结果 |
| 散热 | 360mm一体式水冷 + 机箱风道优化 | 单GPU功耗300W+,持续求解需稳定散热 |
| 系统 | Windows 11 Pro for Workstations / Ubuntu 22.04 LTS | Rocky支持Windows与Linux;Linux下多GPU驱动效率通常更优 |
求解能力预估:100-300万球形颗粒搅拌混合仿真,单工况求解时间 2-6小时;500万颗粒旋风分离器,单工况 8-16小时。
方案B:企业专业型(千万级颗粒,多物理场耦合)
定位:化工设计院、电池企业研发部、矿山设备制造商
相关机型:UltraLAB AE450或AX430
相关机型:UltraLAB AE450或AX430
表格
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| CPU | AMD Threadripper PRO 7975WX (32核64线程, 睿频5.3GHz, 8通道DDR5) 或 Intel Xeon W9-3475X (36核72线程, 睿频4.8GHz) | 8通道DDR5提供153GB/s内存带宽,对DEM-CFD耦合时的数据交换效率提升显著;多核支持Fluent与Rocky的异构并行 |
| GPU | 双卡 NVIDIA RTX Pro 6000 96GB (Blackwell, 总显存192GB) 或 双卡 RTX pro 5000 48GB (总显存96GB) | 双卡NVLink互联实现显存叠加与P2P高速通信;192GB总显存可承载3000-5000万非球形颗粒,或1-2亿球形颗粒 |
| 内存 | 256GB DDR5-4800 ECC RDIMM | DEM-CFD双向耦合时,Fluent的流场数据与Rocky的颗粒数据需在内存中缓存,256GB是千万级耦合仿真的安全线 |
| 存储 |
系统盘:4TB NVMe Gen5 SSD 数据阵列:8TB×4 NVMe U.2 SSD (RAID 5, 通过MegaRAID 9670W-16i) |
千万颗粒级仿真的结果文件(含每帧颗粒位置/速度/接触力)可达TB级;RAID 0阵列提供28GB/s连续读写,大幅缩短数据保存时间 |
| 散热 | 分体式水冷 / 压缩机散热系统 (2000W级) | 双GPU满载功耗600W+,CPU 350W,持续24-48小时求解需工业级散热 |
| 网络 | 双万兆以太网 | 便于接入企业ANSYS License Server与仿真数据仓库 |
求解能力预估:2000万非球形颗粒电池电极压延仿真,单工况 12-24小时;5000万颗粒旋风分离器DEM-CFD耦合,单工况 24-48小时;支持2-3个百万级颗粒工况并行。
方案C:旗舰工业型(数亿级颗粒,矿山全尺度生产线)
定位:大型矿山设计院、跨国化工集团、国家级科研平台
相关机型:UltraLAB GR450P或GA660M
相关机型:UltraLAB GR450P或GA660M
表格
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| CPU | AMD Threadripper PRO 7995WX (96核192线程, 睿频5.1GHz, 12通道DDR5) 或 双路 AMD EPYC 9684X (2×96核, 3D V-Cache) | 12通道DDR5提供307GB/s内存带宽,对超大规模DEM-CFD耦合的内存密集型数据交换至关重要;96核支持Fluent、Mechanical、Rocky三求解器协同 |
| GPU | 3× 或 4× NVIDIA RTX Pro 6000 Max Q 96GB (Blackwell, 总显存288GB/384GB) | 3-4卡NVLink全互联,显存池化共享;384GB总显存可支撑数亿个真实形状颗粒的工业级仿真,是Rocky官方标称的"大规模"门槛 |
| 内存 | 512GB - 1TB DDR5-4800 ECC RDIMM | 数亿颗粒的前处理生成、耦合数据缓冲、后处理统计均需海量内存;1TB内存可支撑全尺度矿山破碎筛分输送联合仿真 |
| 存储 |
全闪存架构: • 系统层:4TB NVMe Gen5 • 缓存层:16TB NVMe U.2 (Optane替代方案) • 数据层:16TB NVMe U.2×4 (RAID 6, 通过SmartRAID Ultra 3258p-32i/e) |
数亿颗粒仿真的瞬态结果(每帧数GB,数百帧)可达TB级;全闪存阵列保障I/O零等待,RAID 6提供数据冗余 |
| 散热 | 机架式4U-7U定制风道 + 压缩机级液冷 | 4×GPU + 双路CPU功耗超2000W,需机房级精密散热 |
| 扩展 | 支持InfiniBand NDR / 100GbE | 未来可扩展为多节点GPU集群,接入Slurm作业调度 |
求解能力预估:1亿非球形颗粒HPGR高压辊磨机仿真,单工况 48-72小时;3亿颗粒矿山破碎-筛分-输送全生产线耦合,单工况 5-7天;支持城市级料场堆取料长期演化模拟。
四、选型核心建议与避坑指南
1. GPU显存是第一硬指标,CUDA核心数是第二
Rocky的颗粒数据(位置、速度、角速度、取向、接触力、温度等)全部驻留在GPU显存中。显存容量直接决定可仿真的颗粒数量上限,而非CUDA核心数。建议按以下公式保守估算:
所需显存(GB) = 目标颗粒数(百万) × 0.8 × 形状系数(球形1.0/多面体3.0-5.0) × 1.5
例如:目标5000万多面体矿石颗粒 → 50×0.8×4×1.5 = 240GB,需配置3×96GB GPU。
2. NVLink比PCIe更重要,多卡必须互联
若仅通过PCIe插多块GPU而不启用NVLink/Bridge,Rocky的多GPU并行效率会大幅下降(可能低于60%)。RTX Pro 6000系列支持NVLink Bridge,可实现GPU间P2P显存访问,是专业DEM仿真的必备条件。游戏卡(GeForce RTX)不支持NVLink,不适合大规模Rocky并行。
3. CPU:前处理与耦合的"隐形瓶颈"
虽然Rocky求解阶段主要在GPU运行,但:
-
前处理:生成1000万颗粒的初始堆积可能需要CPU运行30分钟至数小时
-
DEM-CFD耦合:Fluent的流场求解在CPU端,需高频多核CPU保障耦合同步效率
-
后处理:颗粒轨迹动画渲染、磨损云图生成依赖CPU单核性能
建议CPU配置不低于24核,睿频4.5GHz+。
4. 存储:颗粒轨迹动画是"存储杀手"
Rocky的后处理可输出颗粒运动的动态动画,若保存每帧的完整颗粒状态(位置+速度+取向),文件量极其庞大。建议:
-
求解阶段仅保存关键统计量(混合指数、功率、磨损深度)
-
动画输出采用降采样(每10-100帧保存一帧)
-
配置NVMe U.2企业级硬盘,避免SATA硬盘的写入瓶颈
5. 软件授权与硬件的匹配
-
Rocky的GPU求解器授权与ANSYS License体系绑定,需确认License支持多GPU并行
-
Rocky Student版仅支持CPU求解与有限颗粒数,学术科研若需大规模GPU仿真需购买商业授权
-
与Fluent/Mechanical的耦合需额外确认对应模块的授权
结语:数亿颗粒的工业仿真,从一台专业工作站开始
从化工搅拌槽中的百万颗粒混合,到矿山破碎机的数亿颗粒断裂演化,Ansys Rocky正在将离散元法从学术研究工具转变为工业级设计平台。而支撑这一转变的底层变量,是多GPU并行算力的指数级增长——从单卡32GB到四卡384GB,从百万颗粒到数亿颗粒,硬件的每一次升级都在拓展DEM仿真的应用边界。
对于高校DEM实验室、化工设计院、矿山装备制造商与新能源企业而言,选择一台经过专业调优的UltraLAB多GPU图形工作站,不仅是购买硬件,更是为颗粒尺度研发、设备磨损预测与工艺优化建立算力基础设施。在每一粒砂石的运动轨迹中,都藏着提升效率、降低能耗、延长寿命的工程密码,而解锁这些密码的钥匙,正是精准的硬件配置。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


