






导读:整车模型动辄几千万单元,20个支架要重复画19遍网格,传统前处理占去仿真工程师60%以上的时间——这是CAE行业多年的痛点。HyperMesh 2026带着ShapeAI智能形状识别、PhysicsAI原生集成和Python 3.10自动化架构来了。但问题是:当你的前处理软件开始"学会思考",你的工作站硬件,还能跟上这种AI驱动+超大规模装配体+实时图形交互的三重负载吗?
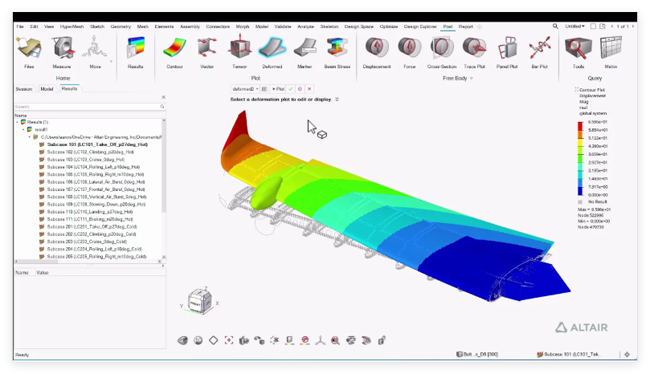
一、HyperMesh 2026 AI网格:四大核心功能拆解
1. ShapeAI智能形状识别——让软件学会"举一反三"
这是2026版本最亮眼的能力。ShapeAI通过机器学习算法自动提取CAD几何或CAE网格模型的特征属性,包括体积面积比、拓扑结构、特征布局等,然后计算不同部件的形状匹配率。
工程价值:导入整车模型后,ShapeAI自动将20余个支架归类为5个相似部件组,螺栓螺母归为另一组。即使两个部件看起来相似但布局不同(如2×2和4×1布局的乐高积木),ShapeAI也能准确区分——这种识别能力是传统规则化编程无法实现的。
2. 建模参数同步与批量复用——"画一遍,搞定一组"
基于ShapeAI的分组结果,工程师只需完成一个支架的网格划分,点击"同步",同组内其他19个相似支架瞬间完成相同设置。这不仅消灭重复劳动,更重要的是确保相似部件建模标准完全统一,避免人工操作带来的参数不一致。
3. Batch Mesher批量网格划分——"喝杯咖啡,网格自己画完"
HyperMesh的招牌功能在2026版本进一步优化。按用户指定的网格尺寸、质量标准,对整个装配体进行全自动批量划分,无需手工干预。流程:导入CAD → 设置全局参数 → 启动批处理 → 自动完成几何清理、网格划分、质量检查。
4. 预测性网格质量检查——"事前预警,而非事后返工"
传统做法是划完网格再检查质量,发现问题回头修改。2026引入预测性机制,在划分过程中实时评估网格质量,提前预警可能导致的仿真收敛问题。例如发现某区域长宽比过大,立即提示调整参数,而非等整个模型划完才发现要重来。
二、PhysicsAI原生集成:前处理与AI推理的"无缝流"
如果说AI网格是前处理的自动化,PhysicsAI则是前处理与仿真预测的融合。
HyperMesh 2026将PhysicsAI彻底变成前处理的一部分:
-
从几何到预测的无缝流:在HyperMesh里直接定义数据集,一键推送到PhysicsAI训练
-
向量场与SPH支持:突破以往AI只能预测标量(如应力)的限制,2026版本支持向量场(Vector Fields)和SPH(光滑粒子流体动力学)预测——复杂流体飞溅、粒子运动也能秒级预测
-
浏览器内直接推理:训练好的模型直接在浏览器运行,速度比传统求解器快1000倍
核心转变:以前做仿真是"验证设计",现在是用HyperMesh + AI "引导设计"。
三、核心算法与计算特点深度分析
1. 核心算法架构
| 算法模块 | 技术原理 | 计算特征 |
|---|---|---|
| ShapeAI形状识别 | 基于机器学习的几何特征提取(体积面积比、拓扑结构、特征布局)+ 相似度匹配算法 | 需对大规模装配体所有部件进行特征向量计算与聚类,CPU密集型 |
| Batch Mesher批量划分 | 自动几何清理 + 自适应网格尺寸映射 + 质量驱动的网格优化迭代 | 多线程并行处理,内存占用随装配体规模线性增长 |
| 预测性质量检查 | 网格质量启发式规则 + 机器学习收敛预测模型 | 实时计算,需与图形渲染同步,GPU加速图形管线 |
| PhysicsAI代理模型 | 物理信息神经网络(PINN)/ 深度算子学习,支持向量场和SPH | GPU训练+推理,显存需求大;向量场预测比标量预测数据量高3倍 |
| Python 3.10自动化 | numexpr等高性能库 + 2500+ API函数 + 现代化GUI Toolkit | 脚本批量执行时CPU多核调度,GUI渲染依赖GPU |
2. 计算特点详解
(1)超大规模装配体图形性能 整车模型成百上千个零部件,几千万单元,旋转一下模型帧率掉成PPT。HyperMesh 2026优化了底层图形引擎和数据管理逻辑,但硬件的OpenGL图形性能和专业显存容量仍是瓶颈。
(2)AI训练数据的生成与处理 ShapeAI需要提取每个部件的几何特征向量;PhysicsAI训练需要大量高保真仿真结果作为数据集。这意味着前处理阶段就要产生海量中间数据,对存储I/O和内存带宽提出极高要求。
(3)批量处理的并发负载 Batch Mesher对整车所有部件同时启动网格划分进程,多核CPU的并行效率、内存容量、以及临时文件读写速度直接决定"喝杯咖啡"的时间长短。
(4)实时交互式AI推理 PhysicsAI的浏览器内推理虽然快,但前提是模型已经训练好。训练过程需要GPU加速;推理时若涉及向量场和SPH的3D时空可视化,专业显卡的图形管线性能至关重要。
四、软件工具链:从AI前处理到求解验证
核心前处理平台
-
Altair HyperMesh 2026:AI网格、ShapeAI、Batch Mesher、PhysicsAI原生集成
-
Altair HyperView 2026:后处理可视化,新增HV.hotspot热点分析自动化、双向数据同步
-
Altair Compose / HyperStudy:优化设计流程与自动化报告
AI开发与自动化
-
Python 3.10 + numexpr:HyperMesh原生Python环境,2500+ API函数,现代化GUI Toolkit
-
PhysicsAI / NVIDIA Modulus:物理信息神经网络训练与推理
-
ONNX Runtime / TensorRT:模型部署与推理加速
求解器验证(生成PhysicsAI训练数据)
-
Altair OptiStruct:结构优化与线性/非线性分析
-
Altair Radioss:显式动力学碰撞分析
-
ANSYS Mechanical / Abaqus:多物理场耦合验证
-
LS-DYNA:整车碰撞高保真基准仿真
数据管理与协同
-
Altair Knowledge Studio / PDMLink:仿真数据版本管理
-
Docker / Kubernetes:多用户环境隔离,Python依赖管理
五、科研级硬件配置推荐
基于HyperMesh 2026 AI网格的四大负载特征——大规模装配体图形渲染、AI训练推理、批量网格并发处理、海量数据存储——推荐以下三档方案:
【方案A】课题组入门型:AI网格探索 + 中小规模装配体
相关机型 UltraLAB AX450或GT450P
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | Intel Xeon 674X(28核56线程,液冷超频4.8GHz) | Batch Mesher批量处理需多核并行;高主频保障单部件网格划分效率 |
| 内存 | 128GB DDR5-4800 ECC RDIMM(8×16GB) | 百万级单元整车模型 + ShapeAI特征向量缓存 + Python批量脚本 |
| GPU | NVIDIA RTX Pro 5000 32GB | 32GB显存支撑千万级单元OpenGL图形渲染;Ada架构Tensor Core加速PhysicsAI训练 |
| 系统盘 | 2TB PCIe 4.0 NVMe SSD | HyperMesh 2026 + Python 3.10环境 + 求解器 |
| 数据盘 | 4TB PCIe 4.0 NVMe SSD | 整车模型文件、网格结果、PhysicsAI训练数据集 |
| 网络 | 双万兆以太网 | 多用户远程桌面流畅访问 |
| 散热 | 360mm一体式水冷 | 保障Xeon W长时间满载不降频 |
| 系统 | Windows 11 / Ubuntu 22.04 LTS 双系统 | 兼顾HyperMesh原生Windows优化与AI开发Linux环境 |
适用场景:高校课题组初步探索ShapeAI和PhysicsAI,装配体规模<500零部件,网格规模<200万单元,主要用于教学和方法验证。
【方案B】企业研发主力型:大规模整车装配 + PhysicsAI训练
相关机型 UltraLAB AE450或GR450P
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | AMD Threadripper PRO 7995WX(96核192线程,液冷超频) | Batch Mesher对整车上千零部件并发划分,192线程可同时处理多组相似部件 |
| 内存 | 256GB DDR5-4800 ECC RDIMM(8×32GB) | 千万级单元整车模型 + ShapeAI全模型特征提取 + 多工况数据集 |
| GPU | NVIDIA RTX Pro 5000 72GB ×2 | 72GB大显存支撑超大规模装配体图形渲染;双卡NVLink加速PhysicsAI向量场训练 |
| 系统盘 | 2TB PCIe 5.0 NVMe SSD | 极速加载HyperMesh 2026与大型装配体 |
| 数据盘 | 8TB PCIe 4.0 NVMe SSD ×2 | PhysicsAI训练数据集吞吐量极大,RAID 0消除I/O瓶颈 |
| 阵列存储 | 32TB SATA企业级HDD ×4(RAID 5) | 历史项目模型库、训练数据集归档 |
| 网络 | 双万兆以太网 | 多用户并发远程桌面,团队协作 |
| 散热 | 分体式液冷系统(CPU+双GPU全覆盖) | 双卡满载+CPU超频,总功耗超1500W |
| 系统 | Ubuntu 22.04 LTS(主)+ Windows 11(辅) | PhysicsAI训练以Linux为主,HyperMesh前后处理可切Windows |
适用场景:主机厂或零部件企业研发中心,整车级装配体(1000+零部件),网格规模500万~2000万单元,需训练专用PhysicsAI代理模型用于设计早期快速评估。
【方案C】旗舰级AI-CAE融合平台:企业级规模 + 多用户集群
相关机型 UltraLAB GX660M
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | 2× Intel Xeon 铂金8592+(112核224线程,液冷) | 双路平台支持超大规模Batch Mesher并发;可同时调度多个整车项目 |
| 内存 | 512GB DDR5-4800 ECC RDIMM(16×32GB) | 企业级规模装配体(数千零部件)+ 多组PhysicsAI模型并行训练 |
| GPU | NVIDIA RTX Pro 6000 96GB ×4 | 96GB显存可加载整车高分辨率模型;四卡并行支持多用户同时图形交互+AI推理 |
| 系统盘 | 4TB PCIe 5.0 NVMe SSD(企业级) | 高可靠性,保障多用户系统稳定 |
| 高速数据层 | 16TB PCIe 5.0 NVMe SSD ×2 | 支撑4卡同时读取训练数据,消除I/O瓶颈 |
| 冷数据层 | 64TB SATA企业级HDD ×6(RAID 5) | 海量历史仿真案例、AI模型版本库、自动化报告模板 |
| 网络 | 双25Gb以太网 + InfiniBand HDR(可选) | 未来扩展多节点集群,构建AI-CAE私有云 |
| 散热 | 定制压缩机散热系统(2000W级) | 四卡96GB旗舰卡满载功耗极高,压缩机散热保障持续峰值性能 |
| 系统 | Ubuntu 22.04 LTS + Kubernetes容器调度 | 多用户容器化隔离,支持HyperMesh/Ansys/Abaqus与Python/PhysicsAI环境并存 |
适用场景:国家级汽车安全实验室、大型主机厂前瞻技术研发中心,需支撑"ShapeAI智能分组 + Batch Mesher批量划分 + PhysicsAI实时推理 + 自动化报告"的全流程AI-CAE研发平台。
六、关键配置细节提醒
1. 显存容量决定装配体的"视野"
HyperMesh 2026处理企业级规模装配体时,OpenGL显存占用随零部件数量和网格密度急剧增长。32GB是百万级单元的底线,72GB/96GB才能保障千万级单元整车模型旋转缩放不卡顿。
2. CPU核心数 vs 内存容量的平衡
Batch Mesher的并发效率不仅取决于核心数,更取决于每个线程的内存可用量。96核CPU若只配128GB内存,批量处理时会出现内存争用导致线程阻塞。建议按每核心2~3GB内存配比配置。
3. 存储分层:NVMe热数据 + HDD冷归档
ShapeAI特征提取和PhysicsAI训练会产生大量中间文件。建议采用PCIe 5.0 NVMe作为活跃工作区,SATA HDD作为项目归档。避免将企业级HDD用于Batch Mesher的临时文件目录,否则会严重拖慢批量划分速度。
4. Python 3.10自动化对硬件的新要求
HyperMesh 2026的Python 3.10环境引入了numexpr等高性能库,批量脚本执行时会充分占用多核CPU。若同时运行ShapeAI特征提取+Batch Mesher+Python自动化报告,建议配置高频多核CPU而非单纯追求核心数量。
七、结语:硬件是AI前处理的"隐形网格"
HyperMesh 2026的AI网格功能揭示了一个趋势:前处理正在从"手工劳动密集型"转向"算法驱动+自动化密集型"。ShapeAI消灭重复建模,PhysicsAI压缩仿真周期,Python 3.10打通自动化流程——但这一切的前提是,你的工作站能够同时扛住超大规模装配体图形渲染、AI模型训练推理和批量并发计算的三重压力。
对于高校教授、博士及企业研发工程师而言,选择一台能够支撑HyperMesh 2026全功能释放的图形工作站,已不是"配置够用就行"的保守策略,而是缩短前处理周期、释放工程师创造力的关键投资。
UltraLAB面向AI-CAE融合研发场景,提供从液冷超频单卡工作站到四卡旗舰融合平台的完整方案,深度优化HyperMesh 2026、PhysicsAI及Python自动化环境的硬件协同,助力您的团队从"画网格"走向"用AI设计"。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


