






在多物理场仿真领域,COMSOL Multiphysics 几乎成为了工程师和科研人员的"标配"工具。无论是母线板的电热耦合分析、MEMS器件的多场耦合仿真,还是电池、电机、换热器的复杂系统建模,一个核心问题始终困扰着使用者:当电、热、结构、流体等多个物理场相互耦合时,求解器该如何选择?而更重要的是,你的硬件配置能否支撑你选择的算法?
今天,我们就从 COMSOL 底层求解算法的计算特性出发,聊聊全耦合法与分离法背后的硬件需求,并给出针对性的工作站配置方案。
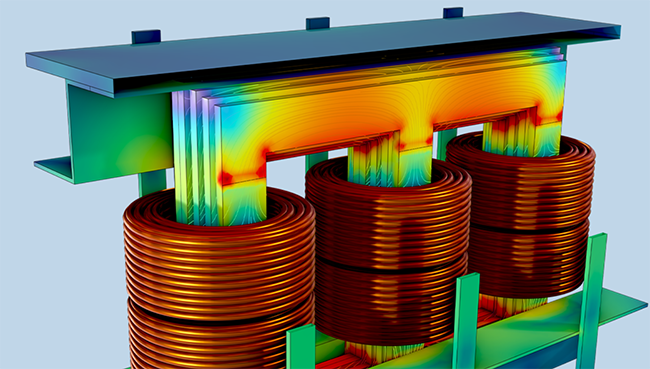
一、COMSOL 多物理场求解的两大核心算法
COMSOL 处理多物理场问题主要有两类算法路线:
1. 全耦合法(Fully Coupled)
全耦合法将多个物理场的未知量(电压、温度、位移等)放在同一个巨大的方程组中同时求解。它通过 Newton-Raphson 迭代处理非线性,求解的雅可比矩阵包含所有物理场之间的交叉耦合项。
计算特点:
-
矩阵非对称且极其庞大:耦合场越多,自由度(DOF)呈几何级增长,系统矩阵迅速膨胀
-
内存消耗巨大:必须使用直接求解器(如 PARDISO),对内存容量和带宽提出极高要求
-
单次迭代成本高:每一步都需要分解大型稀疏矩阵,CPU 计算密集度极高
-
收敛稳健:适用于强耦合、高度非线性的物理场问题(如电-热-结构强耦合)
2. 分离法(Segregated)
分离法按顺序逐个求解各个物理场,利用上一轮计算结果更新材料属性和载荷,通过外循环迭代实现场间耦合。
计算特点:
-
分而治之:每个子步求解规模更小的对称/非对称系统,可选用最优求解器
-
内存友好:单次子步内存占用远低于全耦合,适合大规模模型
-
迭代次数更多:场间耦合需要多次外循环迭代才能收敛,总计算步数增加
-
灵活性高:适合弱到中等耦合的多物理场问题,或自由度极高的瞬态分析
二、算法背后的硬件瓶颈解析
理解了算法差异,就能精准定位硬件瓶颈:
| 计算维度 | 全耦合法 | 分离法 |
|---|---|---|
| 内存需求 | 极高(直接求解器需存储分解后的矩阵) | 中等(迭代求解器内存占用低) |
| CPU 特性 | 高主频 + 大缓存(矩阵分解依赖串行性能) | 多核并行优势更明显(多子步可调度) |
| 内存带宽 | 极度敏感(频繁读写大型矩阵) | 敏感(多次迭代持续吞吐) |
| 存储 I/O | 大模型文件读写频繁 | 大量中间结果和瞬态数据输出 |
| 扩展性 | 内存容量是硬约束 | 计算节点扩展性更好 |
关键洞察:
-
全耦合法的瓶颈往往是"内存墙"——当自由度超过百万级,32GB 内存可能瞬间告急,直接求解器需要数倍于矩阵本身大小的内存空间。
-
分离法虽然单次迭代轻量,但总计算时长可能因多次外循环而拉长,对 CPU 的持续多核运算能力和散热稳定性要求更高。
三、UltraLAB 图形工作站硬件配置推荐
基于上述算法特性,我们为不同规模的 COMSOL 多物理场仿真用户推荐以下硬件方案:
方案一:中小型多物理场分析工作站(适合分离法为主,偶尔全耦合)
典型场景:母线板电热耦合、小型 MEMS 器件、二维/简单三维多物理场模型(DOF < 50万)
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| CPU | Intel Xeon W-3400 系列 / AMD Threadripper PRO 7000WX | 16-24 核,高主频(3.5GHz+),大 L3 缓存,加速稀疏矩阵运算 |
| 内存 | 64GB - 128GB DDR5 ECC | 满足中等规模全耦合或大规模分离法需求,ECC 纠错保障长时间计算稳定性 |
| 存储 | 1TB NVMe SSD(系统+软件)+ 4TB NVMe SSD(项目缓存) | COMSOL 临时文件和结果文件庞大,NVMe 高速读写减少 I/O 等待 |
| 显卡 | NVIDIA RTX A4000 / RTX 4000 Ada | 后处理可视化加速,支持大规模网格渲染 |
| 散热 | 360mm 水冷 + 风道优化 | 有限元仿真满载时间长,持续高频运行需要高效散热 |
方案二:大型多物理场全耦合仿真工作站(强耦合、高自由度)
典型场景:三维电磁-热-结构强耦合、等离子体仿真、高频声学-结构耦合(DOF 50万 - 数百万)
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| CPU | Intel Xeon W9-3495X / AMD Threadripper PRO 7995WX | 64-96 核,兼顾多核并行与单核主频,AVX-512 指令集加速有限元浮点运算 |
| 内存 | 256GB - 512GB DDR5 ECC | 全耦合直接求解器的硬需求,百万级自由度建议 256GB 起步 |
| 存储 | 2TB NVMe SSD(系统)+ 8TB NVMe SSD RAID 0(数据) | 大型模型文件动辄数十 GB,RAID 0 提升连续读写带宽 |
| 显卡 | NVIDIA RTX pro 4000 / RTX pro 5000 | 大显存支撑复杂模型后处理,OpenGL 加速图形界面响应 |
| 散热 | 双 360mm 水冷 + 工业级风道 | 350W 级 CPU 满载运行,双水冷确保不降频 |
方案三:超大规模分离法/集群计算节点(瞬态、参数化扫描)
典型场景:瞬态多物理场分析、参数化扫描、优化设计(DOF > 500万,或大量案例并行)
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| CPU | 双路 Intel Xeon 6700P 系列 | 多路 NUMA 架构,参数化扫描天然并行,单节点核数可达 128+ |
| 内存 | 512GB - 1TB DDR5 ECC | 支持多实例同时运行或超大规模分离法迭代 |
| 存储 | 全闪存阵列 / NVMe-oF | 多任务并发读写,避免 I/O 成为瓶颈 |
| 网络 | 100GbE / InfiniBand | 未来扩展集群计算时,节点间高速互联 |
四、给 COMSOL 用户的选型建议
-
先评估你的模型规模:在 COMSOL 中查看"统计信息"中的自由度数量。如果全耦合求解,内存需求大致为自由度数量的 10-30 倍(字节)。百万自由度 = 10-30GB 内存起步。
-
求解器选择决定硬件投入:如果必须使用全耦合(强耦合非线性问题),内存容量是首要投资方向,CPU 主频次之;如果以分离法为主,可优先追求多核 + 高内存带宽的平衡配置。
-
不要忽视存储:COMSOL 的临时文件(.mph 求解过程)和后处理数据非常庞大,NVMe SSD 比传统 SATA SSD 能节省大量等待时间。
-
散热即性能:有限元仿真往往是"一跑几小时甚至几天"的重负载任务,散热不足导致 CPU 降频,实际性能可能损失 20%-30%。
结语
COMSOL 的多物理场仿真能力毋庸置疑,但"算得准"的前提是"算得动"。全耦合法对内存的贪婪、分离法对持续算力的渴求,都在倒逼我们重新审视工作站的硬件配置。选择一台在 CPU 算力、内存容量、存储速度和散热系统上均衡发力的专业工作站,才能让 COMSOL 的算法优势真正转化为工程效率。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


