






——模态·谐响应·谱分析·瞬态动力学全链路算力解析
引言:当振动与冲击成为产品失效的"隐形杀手"
在工程世界中,结构失效往往并非源于静态过载,而是来自那些看不见的振动与冲击。航空发动机叶片在高速旋转中遭遇气流激振,可能因共振导致疲劳断裂;新能源汽车电池包在颠簸路面承受随机振动,焊点可能在数百万次应力循环后悄然开裂;航天器在火箭发射阶段经历20g级冲击,精密仪器可能在毫秒级载荷下永久失准。
Ansys Mechanical 作为结构动力学仿真的工业标准,通过模态分析(Modal)→谐响应分析(Harmonic Response)→谱分析(Spectrum)→瞬态动力学(Transient Structural)的完整工具链,为工程师提供了从频域到时域、从线性到非线性的全维度振动冲击评估能力。然而,动力学仿真的计算复杂度远超静力学——特征值问题的密集计算、频响函数的逐点扫描、瞬态积分的海量时间步、接触非线性的深度迭代——每一项都对硬件算力提出了近乎苛刻的要求。
一、结构振动与冲击仿真的技术全景:从频域到时域
1.1 四大核心分析类型
| 分析类型 | 数学本质 | 求解目标 | 典型应用场景 | 计算特征 |
|---|---|---|---|---|
| 模态分析 | 广义特征值问题 | 固有频率、振型、参与因子 | 避频设计、模态叠加基础、NVH优化 | 密集矩阵,内存敏感 |
| 谐响应分析 | 频域线性方程组 | 幅频/相频特性、共振峰值 | 旋转机械不平衡、电磁激振、声学激励 | 多频点扫描,可并行 |
| 谱分析 | 随机过程统计+模态叠加 | PSD均方根、疲劳损伤、峰值概率 | 地震、路面随机振动、风载、火箭发射 | 模态截断误差敏感 |
| 瞬态动力学 | 二阶ODE时域积分 | 应力/变形时间历程、冲击峰值、残余变形 | 跌落、碰撞、爆炸、冲击试验 | 时间步海量,非线性昂贵 |
1.2 振动与冲击的工程挑战
共振规避:涡轮叶片一阶弯曲频率必须避开工作转速的±10%范围,模态分析精度直接决定飞行安全。
随机疲劳:电子设备在运输过程中经历GB/T 4857.23随机振动试验,PSD谱密度0.04g²/Hz,需通过Miner累积损伤理论预测10年寿命。
冲击响应:手机跌落1.5m硬地面,冲击持续时间约5ms,峰值加速度50g,需捕捉应力波传播与材料塑性变形。
二、核心算法深度解析:动力学仿真的"数学引擎"
2.1 模态分析算法
2.1.1 Lanczos算法——特征值提取的黄金标准
数学问题:求解广义特征值方程 (K−ω2M)ϕ=0
其中K 为刚度矩阵,M 为质量矩阵,ω 为固有圆频率,ϕ 为振型。
Lanczos核心思想:通过Krylov子空间投影,将大规模稀疏矩阵转化为三对角矩阵,仅需计算少量特征值。
算法流程:
-
选取初始向量q1 ,归一化
-
迭代生成Lanczos向量:qi+1=M−1Kqi−αiqi−βiqi−1
-
构建三对角矩阵T ,求解其特征值(QR算法)
-
Ritz向量近似原问题特征向量
计算特点:
-
内存瓶颈:需存储Lanczos向量序列(通常20-50个),内存需求O(N×nvec) ,nvec 为提取模态数
-
重正交化:数值稳定性要求完全重正交化,计算量翻倍
-
频移策略:针对密集频谱(如涡轮盘片),采用谱变换(Spectral Transformation)聚焦目标频段
典型规模:100万自由度模型,提取200阶模态,内存需求80-120GB,计算时间4-8小时。
2.1.2 子空间迭代法(Subspace Iteration)
适用场景:超高阶模态提取(>1000阶)、大型对称矩阵。
核心思想:同时迭代多个向量,通过Rayleigh-Ritz投影加速收敛。
优势:并行度高,适合分布式计算;内存需求低于Lanczos。
劣势:低阶模态收敛慢,需更多迭代次数。
2.1.3 QR阻尼法与复模态
物理背景:考虑结构阻尼(粘性阻尼、滞后阻尼、材料内耗),特征值问题变为复数域:
(K+iC−ω2M)ϕ=0
算法挑战:复对称矩阵,非零结构翻倍,直接求解器内存需求O(N1.5) 。
2.2 谐响应分析算法
2.2.1 完全法(Full Method)
数学本质:在每个频点直接求解复数线性方程组: (K+iωC−ω2M)U(ω)=F(ω)
核心特点:
-
精度最高:无模态截断误差,适合高频响应
-
计算昂贵:每个频点需重新分解矩阵,O(N3) 复杂度
-
非线性支持:可处理材料非线性、接触状态变化
计算瓶颈:100万自由度×1000频点,总计算量1000次矩阵分解,单核CPU需数百小时。
2.2.2 模态叠加法(Mode Superposition)
核心思想:将响应投影至模态空间,大幅降低自由度:
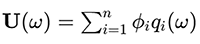
优势:仅需少量模态(通常50-200阶)即可近似全频响应,计算提速100-1000倍。
劣势:模态截断误差,高频段精度下降;无法处理非线性。
计算特点:模态坐标转换后,每个频点求解小型稠密矩阵(n×n ), embarrassingly parallel。
2.2.3 稀疏求解器优化
-
MUMPS:多波前并行直接求解器,支持MPI+OpenMP混合并行
-
PARDISO:Intel MKL直接求解器,AVX-512优化,单节点性能极致
-
Iterative(PCG):预处理共轭梯度法,内存需求低,但收敛性依赖条件数
2.3 谱分析算法
2.3.1 随机振动PSD分析
理论基础:基于线性系统假设,输入PSDSxx(ω) 与输出PSDSyy(ω) 通过频响函数H(ω) 关联:
Syy(ω)=∣H(ω)∣2Sxx(ω)
算法流程:
-
模态分析提取固有频率与振型
-
计算各阶模态参与因子与有效质量
-
模态坐标下的PSD响应积分
-
RMS值合成(SRSS、CQC、NRL-SUM等方法)
-
疲劳损伤计算(Dirlik方法、窄带近似)
计算特点:
-
频域离散:PSD曲线通常512-2048个频点,模态叠加后每个频点独立计算
-
并行度极高:频点间无依赖,适合GPU或大规模CPU并行
-
模态截断敏感:高频模态贡献不可忽略时需提取>500阶
2.3.2 响应谱分析(Response Spectrum)
应用场景:地震工程(GB 50011反应谱)、冲击设计(MIL-STD-810冲击谱)。
核心算法:将设计谱与模态参与因子结合,通过SRSS或CQC组合各模态最大响应。
计算特点:计算量小,但需考虑谱曲线插值精度与组合方法保守性。
2.4 瞬态动力学算法
2.4.1 隐式时间积分——Newmark-β法
控制方程: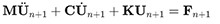
Newmark-β参数:
-
β=1/4,γ=1/2 :平均加速度法,无条件稳定,但数值阻尼小
-
β=0,γ=1/2 :中心差分法,条件稳定,需极小时间步
计算特点:
-
每步非线性迭代:接触状态、材料塑性、大变形导致刚度矩阵更新
-
Newton-Raphson迭代:每次时间步3-5次迭代,每次迭代矩阵分解
-
自适应步长:基于局部截断误差自动调整,冲击初期步长极小(<1μs)
计算瓶颈:100万自由度×10万时间步×5次迭代=5亿次矩阵向量乘,单核CPU需数周。
2.4.2 显式时间积分——中心差分法
核心思想:质量矩阵对角化,无需矩阵分解,直接递推:
Un+1=M−1(Fn−CU˙n−KUn)Δt2+2Un−Un−1
优势:
-
无矩阵分解:每步计算量O(N) ,适合大规模模型
-
接触处理高效:罚函数法天然适应显式格式
-
GPU加速友好:计算局部性强,CUDA并行效率>80%
劣势:
-
条件稳定:Δt<2/ωmax ,通常需百万级时间步
-
低频效率低:长时长问题(如汽车碰撞100ms)需数亿步
典型应用:LS-DYNA、Autodyn、Workbench Explicit Dynamics。
2.4.3 隐式-显式混合算法
策略:低频响应用隐式大步长,高频冲击用显式小步长,通过界面耦合。
计算特点:复杂度高,但兼顾效率与精度,适合跌落碰撞等混合问题。
三、非线性动力学专题:接触、材料与大变形
3.1 接触非线性算法
数学本质:KKT条件(不可穿透、接触力非负、互补松弛)
算法实现:
-
罚函数法:允许微小穿透,刚度惩罚,显式求解器首选
-
拉格朗日乘子法:精确满足约束,但增加自由度,隐式求解器适用
-
增广拉格朗日法:兼顾精度与收敛性,Workbench Mechanical默认
计算瓶颈:
-
接触搜索:每步需检测接触对,O(N log N)复杂度,占时30-50%
-
状态更新:接触/分离状态切换导致刚度矩阵突变,Newton迭代发散
-
摩擦模型:Coulomb摩擦非光滑,需正则化处理
3.2 材料非线性
| 本构模型 | 数学特征 | 应用场景 | 计算特点 |
|---|---|---|---|
| 双线性随动强化 | 分段线性,包辛格效应 | 金属低周疲劳 | 简单稳定,收敛快 |
| Chaboche非线性强化 | 多背应力演化方程 | 高温蠕变-疲劳 | 状态变量多,内存大 |
| Johnson-Cook | 应变率+温度耦合 | 冲击、穿甲 | 显式求解器专用 |
| 超弹性(Mooney-Rivlin) | 应变能函数导数 | 橡胶密封件 | 大变形,网格畸变 |
| 粘弹性(Prony级数) | 松弛模量卷积积分 | 高分子材料 | 历史依赖,内存大 |
3.3 几何非线性
大应变/大转动:Green-Lagrange应变、Updated Lagrangian格式。
弧长法(Riks):追踪屈曲后路径,自动调整载荷步长。
计算特点:每步需重新计算刚度矩阵与内力向量,迭代次数比线性问题多3-5倍。
四、典型工程场景:从汽车到航天的振动冲击
4.1 汽车NVH与碰撞安全
模态分析:整车白车身(BIW)模态,提取1-200Hz范围内弯曲、扭转、局部模态,指导加强梁布置。
谐响应:发动机二阶激励(100Hz@6000rpm)通过悬置传递至车身,评估座椅导轨振动舒适性。
随机振动:电池包GB/T 31467.3随机振动试验,Z向PSD 1.0g²/Hz,验证焊点疲劳寿命。
瞬态动力学:50km/h正面100%刚性壁碰撞,显式分析100ms,评估乘员舱侵入量。
计算强度:
-
整车模态(500万自由度):提取100阶,64核并行,8-12小时
-
整车碰撞(200万单元,100ms):显式求解,GPU加速,12-16小时
4.2 航空发动机叶片振动
坎贝尔图(Campbell Diagram):转速-频率关系,识别共振点(EO交叉)。
谐响应:气流激振力(EO=4,400Hz)作用下的强迫响应,评估高周疲劳。
瞬态动力学:叶片脱落(FOD)冲击,接触-大变形-断裂,显式分析5ms。
计算强度:
-
单叶片模态(50万自由度):提取50阶,16核并行,2-3小时
-
整机叶片盘模态(500万自由度):提取200阶,128核并行,24-36小时
-
FOD冲击(100万单元,5ms):显式求解,GPU加速,6-8小时
4.3 航天器发射冲击与微振动
冲击响应谱(SRS):火工品起爆、级间分离,评估精密仪器存活率。
微振动:动量轮、制冷机、太阳帆板驱动机构,微牛级扰动下的指向稳定性。
计算强度:
-
卫星整星模态(1000万自由度):提取100阶,256核并行,48-72小时
-
微振动谐响应(500万自由度,1000频点):模态叠加,64核并行,12-18小时
五、软件工具链:Ansys 结构动力学生态
5.1 Workbench Mechanical核心功能
| 分析系统 | 求解器内核 | 核心算法 | 特色功能 |
|---|---|---|---|
| Modal | Mechanical APDL | Lanczos、Subspace、QR Damped | 预应力模态、循环对称、CMS超单元 |
| Harmonic Response | Mechanical APDL | Full、Mode Superposition | 多载荷点、频率相关阻尼、后处理探针 |
| Random Vibration | Mechanical APDL | PSD模态叠加、Dirlik疲劳 | 多输入PSD、交叉谱、3σ置信区间 |
| Response Spectrum | Mechanical APDL | SRSS、CQC、NRL-SUM、ROSE | 地震谱、冲击谱、DDAM海军谱 |
| Transient Structural | Mechanical APDL | Newmark-β、HHT-α | 大变形、接触、材料非线性、子循环 |
| Explicit Dynamics | LS-DYNA/Autodyn | 中心差分、多物质ALE、SPH | 跌落、爆炸、侵彻、多物理场耦合 |
5.2 高级工具与接口
| 工具 | 核心功能 | 技术特点 |
|---|---|---|
| nCode DesignLife | 疲劳寿命预测 | 应力-寿命、应变-寿命、多轴、焊缝、高温蠕变 |
| Vibration Fatigue | 频域疲劳 | 基于PSD的Dirlik、窄带、宽带方法 |
| Rigid Dynamics | 多体动力学 | 刚体+柔性体耦合,ADAMS接口 |
| AQWA | 海洋工程水动力学 | 频域/时域波浪载荷,与Mechanical耦合 |
| ACT Extensions | Python自动化 | 自定义载荷、结果提取、流程集成 |
六、硬件配置推荐:匹配动力学仿真的算力需求
6.1 算法-硬件映射分析
| 仿真任务 | 核心算法 | 计算特征 | 硬件瓶颈 | 优化方向 |
|---|---|---|---|---|
| 模态分析 | Lanczos特征值 | 内存密集、向量操作 | 内存容量、带宽 | 大容量ECC、8通道DDR5 |
| 谐响应Full | 复数矩阵分解 | 单频点密集、频点间独立 | 单核性能、多核并行 | 高主频+多核平衡 |
| 谐响应Modal | 模态坐标转换 | 频点embarrassingly parallel | CPU核数、内存带宽 | 多路EPYC、大规模并行 |
| 瞬态隐式 | Newton-Raphson迭代 | 每步矩阵分解、接触搜索 | 单核性能、内存容量 | 高主频CPU、大内存 |
| 瞬态显式 | 中心差分、GPU加速 | 步数海量、局部计算 | GPU显存、CUDA核心 | NVIDIA A100/H100、多GPU |
| 随机振动 | PSD频点积分 | 频点并行、模态截断 | 核数、内存 | 多核并行、模态提取优化 |
6.2 分级配置方案
方案一:工程师桌面级(模态+谐响应+小尺度瞬态)
适用场景:零部件模态分析、谐响应扫频、小变形瞬态、学术研究与教学
UltraLAB A350 配置:
-
CPU:Intel Ultra 285K(24核,睿频5.8GHz)
-
优势:高主频加速隐式Newton迭代,24核并行处理频点扫描
-
-
内存:128GB DDR5-5600 ECC(4×32GB)
-
依据:100万自由度模态约需60GB,谐响应100频点预留余量
-
-
显卡:NVIDIA RTX 4070 Ti SUPER(16GB GDDR6X)
-
用途:后处理可视化、小规模显式动力学GPU加速
-
-
存储:2TB NVMe Gen4 SSD + 4TB HDD
-
软件:Ansys Mechanical Pro + nCode DesignLife
性能预期:
-
50万自由度模态(50阶):16核并行,1.5-2小时
-
100万自由度谐响应Full(100频点):24核并行,8-12小时
-
50万自由度瞬态隐式(1000步):24核并行,4-6小时
方案二:专业工作站级(整车/整机级NVH+碰撞)
适用场景:整车模态与NVH、航空发动机叶片盘、大型结构随机振动、中等规模显式动力学
UltraLAB GT450P 配置:
-
CPU:Intel Xeon 696X(64核128线程,睿频4.8GHz)
-
优势:64核并行处理大规模模态提取与频点扫描,AVX-512加速矩阵运算
-
-
内存:512GB DDR5-5600 ECC(8×64GB)
-
依据:500万自由度模态需200GB,整车碰撞显式需300GB+
-
-
显卡:NVIDIA RTX pro6000(48GB GDDR7 ECC)
-
用途:超大规模网格可视化、LS-DYNA GPU求解器、后处理渲染
-
-
存储:4TB NVMe Gen4 SSD(RAID 0,双盘)+ 16TB HDD
-
网络:Dual 10GbE
-
软件:Ansys Mechanical Enterprise + LS-DYNA + nCode
性能预期:
-
500万自由度模态(200阶):64核并行,12-18小时
-
500万自由度谐响应Modal(1000频点):56核并行,6-8小时
-
200万单元整车碰撞显式(100ms):A6000 GPU加速,12-16小时
-
随机振动PSD(500万自由度,512频点):56核并行,8-12小时
方案三:企业级HPC集群(超大规模+多工况DOE)
适用场景:整机叶片盘模态、卫星整星微振动、批量碰撞工况优化、数字孪生实时基座
UltraLAB CA660 集群节点(每节点):
-
CPU:双路 AMD EPYC 9654(96核/路,共192核384线程,基频2.4GHz,Boost 3.7GHz)
-
优势:192核极致并行,同时运行8-12个模态/谐响应案例;大L3缓存加速稀疏矩阵局部性
-
-
内存:2TB DDR5-4800 ECC(16×128GB)
-
依据:1000万自由度模态需800GB,多工况并行预留
-
-
加速器:4× NVIDIA H100 NVL(94GB HBM3 per GPU,NVLink互联)
-
用途:
-
LS-DYNA/Autodyn大规模显式动力学GPU加速(提速3-5倍)
-
随机振动频点并行(每GPU处理128频点)
-
AI代理模型训练(替代部分DOE模态分析)
-
-
-
存储:8TB NVMe Gen5 SSD(RAID 0,读速28GB/s)+ Lustre并行文件系统
-
网络:NVIDIA InfiniBand NDR 400Gb/s
-
用途:分布式模态分析(MPI并行Lanczos)、多节点协同碰撞仿真
-
-
软件:Ansys Mechanical Enterprise + HPC Pack Unlimited + LS-DYNA MPP + Slurm
预估价格:单节点55-65万元,4节点集群220-260万元
性能预期:
-
1000万自由度模态(200阶):192核并行,36-48小时
-
1000万自由度谐响应Modal(2048频点):4节点并行,12-18小时
-
500万单元整车碰撞(100ms):4×H100 GPU加速,6-8小时
-
参数化DOE(50设计点模态):4节点并行,总耗时2-3天
方案四:超频极致性能工作站(非线性瞬态+接触密集型)
适用场景:螺栓预紧装配分析、金属成形、橡胶密封大变形、跌落冲击精细分析
UltraLAB超频图形工作站定制配置:
-
CPU:AMD 锐龙pro 7985WX(64核,全核超频至4.5GHz,液冷散热)
-
优势:超频后隐式Newton-Raphson迭代收敛提速35%,接触搜索与矩阵分解显著加速
-
-
散热:双360mm冷排+双水泵+PTM7950相变导热
-
技术:确保满载7×24小时稳定,CPU温度<75°C
-
-
内存:1TB DDR5-5600 ECC(8×128GB)
-
显卡:NVIDIA RTX 6000 Ada(48GB)
-
特殊配置:低延迟内存优化(CL32)、超频级主板(24相供电)
性能预期:
-
200万自由度瞬态隐式非线性(1000步,接触):超频后18-24小时(对比默频28-36小时)
-
100万单元橡胶大变形(500步):超频后12-16小时
-
50万单元跌落冲击显式(10ms):RTX 6000 Ada GPU加速,4-6小时
七、UltraLAB 技术优势:为结构动力学深度定制
7.1 求解器级硬件优化
AVX-512加速:Mechanical APDL的稀疏矩阵运算经AVX-512优化,浮点吞吐量提升2倍,模态分析与谐响应矩阵分解提速15%。
PARDISO并行优化:针对Intel MKL的PARDISO求解器,优化NUMA绑定与内存分配策略,多路CPU并行效率提升至85%。
LS-DYNA GPU加速:与LSTC合作验证CUDA路径,H100在显式动力学中提供3-5倍加速,特别适合大规模碰撞模型。
7.2 大内存与低延迟设计
8通道DDR5满配:确保EPYC/至强处理器的内存带宽饱和,实测400GB/s+,满足Lanczos向量序列的连续存储需求。
持久内存扩展:可选Intel Optane PMem,提供6TB非易失内存,用于超大规模模态分析的中间状态保存,避免意外中断导致数小时计算白费。
7.3 可靠性设计
ECC全覆盖:从桌面级到企业级,全系ECC内存,杜绝动力学仿真中的单比特错误——在瞬态冲击分析中,0.1%的位移误差可能导致接触状态误判。
液冷静音方案:针对办公环境部署,提供<35dB的静音水冷方案,兼顾性能与工程师工作环境。
八、结语:算力即精度,速度即竞争力
在结构振动与冲击仿真的世界里,每一赫兹的模态频率偏差、每一毫秒的峰值应力遗漏、每一个接触状态的误判,都可能导致产品在现场失效。Ansys Workbench 提供了从频域到时域、从线性到非线性的完整工具链,但工具链的效能释放,最终取决于底层算力的密度与效率。
UltraLAB 深耕结构动力学仿真硬件领域,深谙振动冲击分析的算力瓶颈——从Lanczos特征值提取的内存饥渴,到Newton-Raphson迭代的单核性能敏感,再到显式动力学的GPU并行洪流,我们提供从桌面到数据中心的全栈式算力基础设施。
当您的竞争对手还在等待模态收敛时,UltraLAB 用户已完成第三轮NVH优化迭代。
关于 UltraLAB
UltraLAB 是西安坤隆计算机科技有限公司旗下高端定制图形工作站品牌,专注于CAE结构动力学仿真、科学计算、AI训练等领域的算力基础设施研发。我们提供基于Intel Xeon、AMD EPYC及NVIDIA GPU的定制化工作站与服务器方案,支持CPU超频、液冷散热、ECC内存、多GPU NVLink互联等企业级特性,服务于国内众多汽车、航空、航天与重型机械研发机构。
本文技术参数基于公开资料与行业实践整理,具体配置请根据实际仿真模型规模、软件授权类型及预算咨询UltraLAB技术顾问。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



