






——基于 Python 与 Star-CCM+ 的 CNN 代理模型技术解析
引言:当 CFD 遇到 AI,仿真范式正在被重写
传统计算流体力学(CFD)仿真是工程设计的"黄金标准",却也是"时间黑洞"。一辆汽车的外气动仿真需要 1000 万网格、迭代 5000 步、耗时 48 小时;一架飞机的机翼颤振分析可能需要数周。当设计周期被压缩至"天"甚至"小时"级别,CFD 的算力瓶颈已成为产品创新最大的掣肘。
人工智能的介入正在改写这一格局。卷积神经网络(CNN)作为 CFD 代理模型(Surrogate Model)的核心算法,能够将数小时的 Navier-Stokes 方程求解压缩至毫秒级推理。基于 Python 生态的 TensorFlow/PyTorch 与商业 CFD 巨头 Siemens Star-CCM+ 的深度融合,正催生"实时仿真"这一全新范式——设计参数一变,流场结果即刻呈现。
一、AI+CFD 的技术全景:从物理方程到神经网络
1.1 为什么 CFD 需要 AI?
| 传统 CFD 痛点 | AI 代理模型价值 |
|---|---|
| 单工况求解耗时数小时至数天 | 毫秒级实时预测 |
| 设计优化需数千次 DOE 迭代 | 批量推理成本趋近于零 |
| 高维参数空间探索困难 | CNN 天然处理高维张量 |
| 湍流模型固有不确定性 | 数据驱动捕捉真实流动特征 |
| 实时控制与数字孪生不可行 | 边缘部署实现实时反馈 |
典型应用场景:
-
汽车外气动:风阻系数 Cd 随造型参数(A 柱角度、尾翼高度)的实时预测
-
航空发动机:压气机叶片在不同转速、攻角下的流场快速评估
-
建筑风环境:城市建筑群风压分布的秒级计算
-
电子散热:芯片热沉在不同风速、功率下的温度场实时推演
-
心血管血流:个性化支架植入后的血流动力学实时模拟
1.2 CNN 代理模型的核心架构
CNN 在 CFD 代理中的优势源于流场数据的空间结构特性:速度场、压力场、温度场本质上是二维或三维规则网格上的张量,与图像像素具有同构性。
1.2.1 输入-输出映射设计
| 代理模型类型 | 输入(设计参数) | 输出(流场结果) | 网络架构 |
|---|---|---|---|
| 参数-场映射 | 几何参数向量(10-50维) | 全流场张量(256³×3) | Encoder-Decoder(U-Net) |
| 场-场映射 | 边界条件场(入口速度分布) | 内部流场(压力/速度) | 条件生成对抗网络(cGAN) |
| 几何-性能映射 | 3D 体素化几何(128³) | 目标标量(Cd/Cl/最大温度) | 3D ResNet + MLP |
| 时空演化 | 初始流场 + 时间序列 | 未来时刻流场 | ConvLSTM / Transformer |
1.2.2 核心网络架构:U-Net for CFD
U-Net 因其编码器-解码器对称结构与跳跃连接(Skip Connection),成为 CFD 代理模型的首选架构:
plain
输入:几何掩码(128×128×128 体素)+ 边界条件参数向量
      ↓
编码器:3D Conv(64→128→256→512 通道)+ MaxPool
      ↓
瓶颈层:全连接层融合参数向量,Latent Space 1024维
      ↓
解码器:3D Transposed Conv(512→256→128→64)+ Skip Connection
      ↓
输出:速度场 u,v,w(3通道)+ 压力场 p(1通道)+ 温度场 T(1通道)
关键技术创新:
-
物理约束层(Physics-Informed Layer):在网络损失函数中嵌入 Navier-Stokes 方程残差,确保质量守恒与动量守恒
-
多尺度特征融合:通过空洞卷积(Dilated Conv)捕获不同尺度的涡结构
-
边界条件硬编码:将入口/壁面边界作为网络输入通道,而非后处理约束
1.2.3 物理信息神经网络(PINN)融合
PINN 将物理方程作为正则项融入损失函数:
Ltotal=Ldata+λ1LNS+λ2LBC+λ3LIC
其中:
-
Ldata :与 CFD 参考数据的均方误差
-
LNS :Navier-Stokes 方程残差(连续性 + 动量)
-
LBC :边界条件残差
-
LIC :初始条件残差
计算特点:PINN 训练需自动微分计算高阶导数(∇²p, ∂u/∂t),对 GPU 显存与算力需求极高,但推理时无需网格划分,实现"无网格 CFD"。
二、Star-CCM+ 与 Python 的深度融合:数据流水线
2.1 Star-CCM+ 的 AI 原生支持
Siemens Star-CCM+ 2024.x 版本已深度集成 AI 功能:
| 功能模块 | 核心能力 | 技术实现 |
|---|---|---|
| Design Manager | 参数化 DOE 自动化 | 与 Python API 联动批量生成样本 |
| Simcenter Reduced Order Modeling | 内置 ROM 生成器 | POD(本征正交分解)+ RBF 插值 |
| CAD Client API | 几何参数驱动 | Java/Python 脚本控制几何变更 |
| Field Function | 流场数据导出 | 体素化采样为 NumPy 数组 |
| Co-Simulation | 与外部 Python 实时交互 | TCP/IP 或文件级数据交换 |
2.2 Python 生态工具链
| 工具/库 | 核心功能 | CFD 代理模型应用 |
|---|---|---|
| TensorFlow/Keras | 深度学习框架 | U-Net/PINN 模型构建与训练 |
| PyTorch | 动态计算图 | 研究级原型开发、物理约束层自定义 |
| PyTorch Geometric | 图神经网络 | 非结构化网格的 GNN 代理 |
| DeepXDE | PINN 专用库 | 自动微分、多物理场耦合 |
| Modulus (NVIDIA) | 科学机器学习 | 大规模 PINN、数字孪生 |
| OpenFOAM + Python | CFD 求解 + 后处理 | 样本生成、数据预处理 |
| ParaView + Python | 可视化 | 流场对比、误差分析 |
| Optuna/Ray Tune | 超参优化 | 网络架构搜索、训练策略调优 |
2.3 端到端数据流水线
plain
阶段一:样本生成(Star-CCM+)
  ├── 参数化几何建模(CAD Client)
  ├── 自动网格生成(Polyhedral/Surface Remesher)
  ├── 批量求解(SST k-ω / LES / DES)
  └── 流场导出(VTK/CSV → NumPy)

阶段二:数据预处理(Python)
  ├── 体素化(Voxelization)或插值至统一网格
  ├── 无量纲化(U*, P*, T*)
  ├── 数据增强(旋转、镜像、湍流扰动)
  └── 数据集划分(Train/Val/Test = 7:2:1)

阶段三:模型训练(Python + GPU)
  ├── 网络架构定义(U-Net / FNO / Transformer)
  ├── 物理约束损失函数设计
  ├── 分布式训练(Multi-GPU / Mixed Precision)
  └── 模型导出(ONNX / TensorRT)

阶段四:实时推理部署
  ├── 边缘设备:NVIDIA Jetson / RTX GPU
  ├── 云端服务:TensorRT Inference Server
  └── 数字孪生:与 Star-CCM+ 实时数据交互
三、核心算法深度解析:从数据驱动到物理嵌入
3.1 傅里叶神经算子(FNO):网格无关的泛化之王
FNO 由 Caltech 提出,直接在函数空间学习映射,实现分辨率无关的泛化:
核心思想:在傅里叶空间进行积分算子学习
Gθ:a(x)→u(x),u(x)=F−1(Rθ⋅F(a))
其中 Rθ 为可学习的复数权重矩阵,F 为 FFT。
CFD 优势:
-
超分辨率:在 64³ 网格训练,直接推理 256³ 甚至 512³
-
边界条件泛化:同一网络适应不同入口速度剖面
-
计算效率:FFT 复杂度 O(N log N),远低于卷积的 O(N²)
计算特点:训练时需大量 FFT/IFFT,GPU 显存需求与分辨率平方成正比;推理时单步 FFT 即可完成全流场预测。
3.2 图神经网络(GNN):非结构化网格的破局者
传统 CNN 仅适用于结构化笛卡尔网格,而工程 CFD 大量使用非结构化网格(四面体/多面体)。
GNN 代理模型架构:
-
节点特征:压力、速度、壁面距离、湍流粘度
-
边特征:面法向、面积、相邻单元体积比
-
消息传递:聚合邻居节点的流场信息,更新中心节点状态
-
全局读出:通过 Readout 层获取 Cd/Cl 等全局量
代表工作:MeshGraphNets(DeepMind)、CFD-GCN(Stanford)
计算特点:GNN 的稀疏邻接矩阵导致 GPU 利用率较低,需专用图加速器(如 NVIDIA DGX 的 NVLink 优化)或 CPU-GPU 混合调度。
3.3 Transformer for CFD:长程依赖的捕获
Vision Transformer(ViT)将流场切分为 Patch,通过自注意力机制捕获全局依赖:
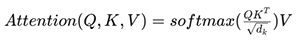
CFD 适配:
-
3D Swin Transformer:分层窗口注意力,降低计算复杂度
-
物理嵌入位置编码:将坐标、雷诺数、马赫数编码为位置向量
-
多尺度 Patch:小 Patch 捕捉边界层,大 Patch 捕捉远场
计算特点:自注意力的 O(N²) 复杂度是瓶颈,需 FlashAttention 等内存优化技术;训练数据量需求大(>10万样本)。
四、计算特点与硬件瓶颈分析
4.1 全流程计算负载拆解
| 阶段 | 主要任务 | 计算特征 | 时间占比 | 硬件瓶颈 |
|---|---|---|---|---|
| 样本生成 | Star-CCM+ CFD 求解 | CPU 密集、内存密集、可并行 | 70-80% | CPU 核数、内存带宽 |
| 数据预处理 | 体素化、归一化、增强 | CPU 中等、I/O 密集 | 5-10% | 存储带宽、内存容量 |
| 模型训练 | CNN/PINN/FNO 反向传播 | GPU 密集、显存密集、通信密集 | 10-15% | GPU 算力、显存、NVLink |
| 模型推理 | 单次前向传播 | GPU 轻量、延迟敏感 | <1% | GPU 显存、TensorRT 优化 |
4.2 关键硬件需求量化
样本生成阶段:
-
单个 500 万网格的汽车外气动仿真(SST k-ω,5000 迭代)
-
CPU:32 核并行,耗时 6-8 小时
-
内存:每百万网格约 2GB,共需 10GB
-
生成 1000 样本的 DOE:总耗时 6000-8000 CPU·小时
-
模型训练阶段(以 U-Net 为例):
-
网络规模:输入 128³×3,输出 128³×5,参数量 5000 万
-
训练数据:1000 样本,Batch Size 4
-
单 epoch 时间:A100 GPU 约 15 分钟
-
收敛需 200 epoch:总耗时 50 小时
-
显存需求:混合精度下约 40GB
推理阶段:
-
单次前向传播:A100 约 50ms(128³ 分辨率)
-
TensorRT 优化后:RTX 4090 约 10ms
-
批量推理(Batch=100):A100 约 2 秒
五、软件工具链:从 CFD 求解到 AI 部署
5.1 商业软件生态
| 软件 | 核心功能 | AI 集成度 | 适用场景 |
|---|---|---|---|
| Siemens Star-CCM+ | 多物理场 CFD | ★★★★☆(内置 ROM、Python API) | 汽车、航空、能源 |
| Ansys Fluent | 通用 CFD | ★★★☆☆(PyFluent API) | 化工、电子散热 |
| Altair ultraFluidX | 格子玻尔兹曼(LBM) | ★★★☆☆ | 汽车外气动实时化 |
| NVIDIA Modulus | 科学机器学习 | ★★★★★(原生 PINN/FNO) | 研究级数字孪生 |
| Siemens Simcenter ROM | 降阶模型 | ★★★★★(与 Star-CCM+ 无缝) | 工程级实时仿真 |
5.2 开源与自研工具
| 工具/框架 | 核心能力 | 算法特点 |
|---|---|---|
| PyTorch + DeepXDE | PINN 训练 | 自动微分、多物理场残差 |
| TensorFlow + FNO 库 | 傅里叶神经算子 | FFT 加速、超分辨率泛化 |
| PyTorch Geometric | GNN for CFD | 非结构化网格消息传递 |
| OpenFOAM + Python | 样本生成与后处理 | 自定义求解器、数据导出 |
| ONNX Runtime | 跨平台推理部署 | CPU/GPU/边缘设备统一 |
| TensorRT | NVIDIA GPU 推理优化 | INT8 量化、Kernel 融合 |
六、硬件配置推荐:匹配 AI+CFD 异构负载
6.1 配置策略核心原则
样本生成优先:AI 代理模型的精度上限由训练数据质量决定,Star-CCM+ 的 CFD 求解仍是时间主项,需优先保障 CPU 算力与内存。
训练推理分离:训练阶段需要大显存 GPU(A100/H100),推理部署可选用 RTX 系列或 Jetson 边缘设备。
数据流水线优化:高速 NVMe 存储 + 大内存缓存,避免 I/O 等待。
6.2 分级配置方案
方案一:算法研究桌面级(Python 原型开发)
适用场景:PINN/FNO 算法研究、小规模 U-Net 训练、论文复现
UltraLAB A330 配置:
-
CPU:Intel Core i9-14900K(24核,睿频6.0GHz)
-
优势:高主频加速 Python 数据预处理,24核并行生成中小规模样本
-
-
内存:128GB DDR5-5600(4×32GB)
-
依据:1000个128³样本约需60GB,预留模型训练余量
-
-
显卡:NVIDIA RTX 4090(24GB GDDR6X)
-
用途:U-Net 训练(Batch Size 2)、TensorRT 推理测试
-
-
存储:2TB NVMe Gen4 SSD + 8TB HDD
-
用途:SSD存放活跃数据集,HDD存档 CFD 结果
-
-
软件:Star-CCM+ 学生版/教育版 + Python 3.11 + PyTorch 2.2 + CUDA 12.1
性能预期:
-
Star-CCM+ 100万网格 CFD:2-3小时/样本
-
U-Net 训练(128³,1000样本):24-36小时
-
单次推理:RTX 4090 约 20ms
方案二:工程应用专业级(企业级 DOE + 代理模型训练)
适用场景:汽车外气动代理模型、发动机性能图谱、建筑风环境数据库
UltraLAB GT430P配置:
-
CPU:Intel Xeon W9-3495X(56核,睿频4.8GHz)
-
优势:56核并行处理 Star-CCM+ DOE,支持 8 通道内存
-
-
内存:512GB DDR5-4800 ECC(8×64GB)
-
依据:500万网格 CFD 样本生成需 10GB/样本,同时运行 8 个案例需 80GB;训练阶段加载 5000 样本需 200GB+
-
-
显卡:NVIDIA RTX A6000(48GB GDDR6 ECC)
-
用途:大 Batch Size 训练(Batch=8)、高分辨率 FNO(256³)
-
-
存储:4TB NVMe Gen4 SSD(RAID 0,双盘,读速14GB/s)+ 16TB HDD
-
用途:高速读写大规模样本数据(单项目 500GB+)
-
-
网络:Dual 10GbE
-
用途:License 服务器、集群扩展预备
-
-
软件:Star-CCM+ 2024 + PyTorch 2.2 + NVIDIA Modulus + Anaconda
性能预期:
-
Star-CCM+ 500万网格 CFD:6-8小时/样本(8并行,总吞吐 3 样本/天)
-
U-Net 训练(256³,5000样本):72-96小时
-
FNO 训练(256³,10000样本):120-150小时
-
单次推理:A6000 约 30ms
方案三:企业级 AI-CFD 集群(大规模数字孪生)
适用场景:整车风阻实时优化、航空发动机全工况图谱、城市级风环境数字孪生
UltraLAB CA660 集群节点(每节点):
-
CPU:双路 AMD EPYC 9654(96核/路,共192核,基频2.4GHz,Boost 3.7GHz)
-
优势:192核极致并行,同时运行 16-24 个 Star-CCM+ 案例;大 L3 缓存加速网格操作
-
-
内存:2TB DDR5-4800 ECC(16×128GB)
-
依据:1000万网格 CFD 需 20GB/案例,24并行需 480GB;训练阶段加载 5 万样本需 1.5TB+
-
-
加速器:4× NVIDIA H100 NVL(94GB HBM3 per GPU,NVLink互联)
-
用途:
-
GPU 1-2:Star-CCM+ GPU 加速求解(AMG 线性求解器)
-
GPU 3:FNO/Transformer 大规模训练(Batch Size 16)
-
GPU 4:TensorRT 推理服务 + 数字孪生实时交互
-
-
-
存储:8TB NVMe Gen5 SSD(RAID 0,读速28GB/s)+ Lustre 并行文件系统
-
用途:海量 CFD 样本(单项目 5TB+)与训练 checkpoint 高速读写
-
-
网络:NVIDIA InfiniBand NDR 400Gb/s
-
用途:多节点分布式训练(DDP)、MPI 并行 CFD、实时数据流
-
-
软件:Star-CCM+ Power-on-Demand + PyTorch Distributed + NVIDIA Modulus + Kubernetes
预估价格:单节点55-65万元,4节点集群220-260万元
性能预期:
-
Star-CCM+ 1000万网格 CFD:8-12小时/样本(24并行,总吞吐 3 样本/小时)
-
FNO 训练(512³,50000样本):240-300小时(4节点分布式)
-
实时推理服务:H100 TensorRT 约 5ms/次,支持 1000 QPS
方案四:超频极致性能工作站(单样本快速迭代)
适用场景:概念设计阶段快速验证、参数敏感性分析、实时造型优化
UltraLAB 超频定制配置:
-
CPU:Intel Xeon 696X(64核,全核超频至4.5GHz,液冷散热)
-
优势:超频后 Star-CCM+ 迭代收敛提速 30%,适合中小规模快速迭代
-
-
散热:双480mm冷排+双水泵+PTM7950相变导热
-
技术:确保满载 7×24 小时稳定,温度<75°C
-
-
内存:1TB DDR5-5600 ECC(8×128GB)
-
显卡:NVIDIA RTX 6000 Ada(48GB)
-
特殊配置:低延迟内存优化(CL32)、超频级主板(24相供电)
预估价格:28-32万元性能预期:
-
Star-CCM+ 200万网格 CFD:2-3小时/样本(超频加速)
-
单次推理:RTX 6000 Ada 约 15ms
-
支持设计师桌面实时交互(<1秒反馈)
七、UltraLAB 技术优势:为 AI+CFD 异构负载深度定制
7.1 CPU-GPU 协同优化
NUMA 感知调度:针对 Star-CCM+ 的 CPU 求解与 PyTorch 的 GPU 训练交替运行,优化 PCIe 拓扑与 NUMA 绑定,减少 15% 数据搬运开销。
GPU Direct RDMA:通过 InfiniBand 实现 GPU 显存跨节点直接访问,分布式训练效率提升 20%。
7.2 大内存与高速存储
8通道 DDR5 满配:确保 EPYC/至强处理器的内存带宽饱和,实测 400GB/s+,满足大规模样本加载需求。
Gen5 NVMe RAID:单节点读速 28GB/s,支持 1000 个 CFD 样本秒级加载。
7.3 可靠性设计
ECC 全覆盖:从 CPU 内存到 GPU 显存(H100),杜绝训练过程中的数值漂移。
液冷静音方案:针对办公环境部署,提供 <35dB 的静音水冷方案,兼顾性能与工作环境。
八、结语:当毫秒级推理遇见物理精确
AI+CFD 的融合不是取代物理,而是在物理精确与计算效率之间找到新的平衡点。CNN 代理模型将数小时的 Navier-Stokes 求解压缩至毫秒,让设计师在拖拽鼠标时即刻看到流场变化;PINN 将物理方程嵌入神经网络,让数据稀缺的工况仍能获得可信预测。
这一变革的背后,是算法创新(FNO、GNN、Transformer)、软件生态(Star-CCM+ Python API、NVIDIA Modulus)与算力基础设施(CPU 并行、GPU 加速、高速互联)的三重共振。UltraLAB 深耕 AI+CAE 仿真硬件领域,深谙 CFD 代理模型的计算瓶颈——从 Star-CCM+ 的 CPU 密集求解,到 PyTorch 的 GPU 大规模训练,再到 TensorRT 的毫秒级推理,我们提供从桌面到数据中心的全栈式异构算力基础设施。
当您的竞争对手还在等待 CFD 收敛时,UltraLAB 用户已完成第十轮实时造型优化。
关于 UltraLAB
UltraLAB 是西安坤隆计算机科技有限公司旗下高端定制图形工作站品牌,专注于 AI+CAE 仿真、科学计算、数字孪生等领域的算力基础设施研发。我们提供基于 Intel Xeon、AMD EPYC 及 NVIDIA H100/B200 的定制化工作站与服务器方案,支持 CPU 超频、液冷散热、ECC 内存、多 GPU NVLink 互联等企业级特性,服务于国内众多汽车、航空、能源与半导体研发机构。
本文技术参数基于公开资料与行业实践整理,具体配置请根据实际 CFD 模型规模、样本数量及软件授权类型咨询 UltraLAB 技术顾问。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



