






——从400kg TNT近距爆炸到装备抗爆设计,UltraLAB打造极端工况仿真利器
当400kg TNT在F35战机腹部下方起爆,爆轰波以数千米每秒的速度冲击机身,在微秒级时间内产生数百兆帕的超压峰值——这种极端工况下,传统有限元方法(FEM)会因网格畸变而瞬间崩溃,而SPH(光滑粒子流体动力学)无网格方法却能完整捕捉从蒙皮撕裂到结构破碎的全流程毁伤细节。
在装备抗爆防护设计与武器毁伤效能评估领域,数值仿真已成为替代实弹试验的核心手段。本文深度解析爆炸冲击仿真的算法原理、计算特征与硬件需求,为军工科研单位提供极致算力方案。
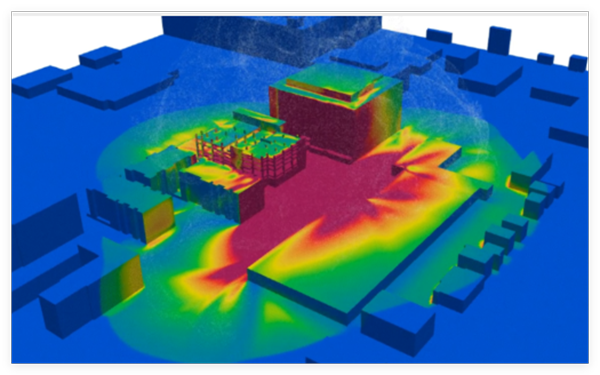
一、爆炸冲击数值模拟的三大核心算法体系
1. SPH(光滑粒子流体动力学)——大变形毁伤的终极解法
算法原理:将连续介质离散为独立粒子,通过核函数(Kernel Function)建立粒子间相互作用,完全规避网格畸变问题。
核心控制方程:
-
动量方程:
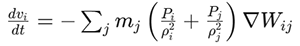
-
连续性方程:
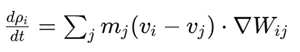
计算特征:
-
邻居搜索开销巨大:每时间步需构建粒子邻居列表(Linked-list或Tree-based算法),计算复杂度O(NlogN)
-
时间步长极短:CFL条件限制,微秒级爆炸需纳秒-微秒级时间步,总步数达106 -108 量级
-
内存带宽敏感:粒子间相互作用需频繁访问非连续内存,高内存带宽(DDR5-4800八通道)至关重要
适用场景:炸药爆轰、金属射流、穿甲侵彻、结构破碎、流固耦合(F35毁伤案例)
2. FEM-SPH耦合算法——多尺度毁伤的最佳实践
技术路线:远场结构采用有限元(FEM)保证精度,近场爆炸与大变形区域采用SPH,通过接触算法(Node-to-Surface或Penalty-based)实现耦合。
计算难点:
-
耦合界面处理:FEM网格与SPH粒子的力传递需特殊算法(如*CONSTRAINED_LAGRANGE_IN_SOLID)
-
并行效率挑战:FEM域与SPH域负载均衡困难,需全核高频CPU(4.5GHz+)保障单步计算速度
-
接触搜索开销:爆炸冲击中粒子-网格接触对数量动态变化,大内存(512GB+)缓存接触历史数据
3. 多物质ALE/Eulerian方法——爆轰产物扩散的高保真模拟
算法特点:在固定网格上求解质量、动量、能量输运方程,通过VOF(Volume of Fluid)或Level Set追踪物质界面,适合处理炸药爆轰、空气冲击波传播。
计算瓶颈:
-
网格分辨率要求:捕捉爆轰波需毫米级网格,全机模型网格量达千万级-亿级
-
多物质界面追踪:密度差极大的物质(炸药-空气-金属)相互作用易引发数值不稳定,需高精度浮点运算(FP64)
-
显式积分并行:空间域分解(Domain Decomposition)依赖高带宽低延迟网络(InfiniBand)(集群场景)
二、爆炸冲击仿真软件工具矩阵
| 软件平台 | 核心算法 | 特色功能 | 硬件侧重 |
|---|---|---|---|
| LS-DYNA | SPH/FEM/ALE全耦合 | 显式动力学标杆,*MAT_HIGH_EXPLOSIVE_BURN炸药本构,SPH-GPU加速 | 高频CPU+大内存+可选GPU |
| ANSYS Autodyn | SPH/Eulerian/Lagrange | 专为爆炸冲击设计,多物质流固耦合,材料数据库丰富 | 全核超频+高内存带宽 |
| Abaqus/Explicit | SPH/Coupled Eulerian-Lagrangian (CEL) | 复杂接触算法,适合结构响应分析,与隐式模块无缝切换 | 大内存(256GB+) |
| OpenFOAM | SPH (solids4foam)/compressibleInterFoam | 开源免费,可二次开发,适合学术研究 | 多核并行+高速存储 |
| SPHysics | 纯SPH开源代码 | GPU加速(CUDA),适合学术验证与算法研究 | 高端GPU(RTX 4090/A100) |
| Cth | 欧拉法 | 美国国防部御用,多物质可压缩流动,武器效应评估 | HPC集群 |
三、爆炸冲击仿真的计算特征深度解析
1. 时间尺度极端化:微秒级事件的毫秒级追踪
-
爆轰阶段:0-100μs,时间步长Δt≈1ns,需100,000+步捕捉起爆与传播
-
冲击阶段:100μs-10ms,时间步长Δt≈0.1μs,结构动态响应计算
-
毁伤阶段:10-50ms,大变形与破碎持续演化
硬件需求:单核高频(4.8GHz+)至关重要,显式积分单步计算量小但依赖单核性能。
2. 粒子规模爆炸式增长:千万级粒子的内存饥渴
以400kg TNT+F35全机模型为例:
-
炸药离散:高密度SPH粒子,约50万-100万粒子
-
空气域:低密度但体积大,约500万-1000万粒子
-
结构响应:FEM网格+SPH粒子混合,约200万自由度
内存占用估算:
-
每个SPH粒子存储:位置(3×8B)+速度(3×8B)+应力(6×8B)+密度(8B)+能量(8B)+邻居列表(≈50×4B) ≈ 400B/粒子
-
1000万粒子需4GB+内存,加上临时数组与接触数据,实际需128GB-256GB内存
3. 数据输出洪峰:时序数据的存储挑战
爆炸冲击仿真需每微秒-每毫秒输出全场数据(应力、压力、密度、损伤)以捕捉瞬态过程:
-
单帧数据量:1000万粒子×32字节 ≈ 320MB
-
总帧数:10ms仿真按100μs输出,共100帧
-
总数据量:32GB/次仿真
-
写入带宽需求:NVMe SSD(7GB/s)保障实时落盘不卡顿
四、UltraLAB爆炸冲击仿真工作站配置方案
【方案A】SPH毁伤仿真旗舰站(千万级粒子级)
适用场景:全机/整车爆炸毁伤、穿甲侵彻、多物质流固耦合
推荐机型 UltraLAB GT450P
| 组件 | 配置规格 | 技术价值 |
|---|---|---|
| CPU | Intel Xeon 698X (86核) 全核超频4.3GHz | 显式积分单步计算,高频=微秒级步长快速推进 |
| 散热 | 双水冷排制冷 | 长期满载4.8GHz不降频,保障20ms+长时程仿真稳定性 |
| 内存 | 512GB DDR5-5600 ECC (8通道) | 缓存千万级SPH粒子邻居列表,减少硬盘交换 |
| 存储 | 4TB NVMe SSD (系统) + 16TB NVMe (数据) RAID0 | 时序数据秒级写入,百GB级结果文件快速加载 |
| 显卡 | RTX 5090D v2 24GB | ParaView/LS-PrePost粒子云图实时渲染,后处理效率提升10倍 |
| 网络 | 双万兆以太网 | 分布式SPH计算(DD-SPH)节点间数据同步 |
【方案B】武器效能评估集群节点(亿级网格级)
适用场景:大规模工事毁伤、弹药破片飞散、多弹协同打击
推荐机型 UltraLAB GR450P
| 组件 | 配置规格 | 技术价值 |
|---|---|---|
| CPU | AMD Threadripper 9995WX (96核) 全核4.5GHz | 多物质ALE高分辨率计算,多核并行效率最大化 |
| 内存 | 1TB DDR5-4800 ECC | 支撑亿级网格+百万级粒子混合模型驻留 |
| 存储 | 30TB NVMe SSD全闪存阵列 | 多工况DOE优化(装药量、爆距、角度参数扫描) |
| 加速器 | NVIDIA A100 80GB ×2 | LS-DYNA SPH-GPU求解器,粒子计算CUDA加速 |
| 集群互联 | InfiniBand HDR 200Gbps | MPP(Massively Parallel Processing)扩展至256核+ |
【方案C】抗爆结构优化设计站(FEM-SPH耦合级)
适用场景:防护结构设计、防爆材料筛选、加筋板抗冲击优化
推荐机型 UltraLAB AE430
| 组件 | 配置规格 | 技术价值 |
|---|---|---|
| CPU | Intel Xeon 8592+ (64核) 单核睿频3.9GHz | FEM-SPH耦合界面计算单核敏感,高频保障接触搜索速度 |
| 内存 | 256GB DDR5-5600 | 中等规模模型(500万粒子+200万网格)高效求解 |
| 存储 | 8TB NVMe SSD + 32TB RAID5 | 材料参数库+历史仿真数据归档 |
| 软件栈 | 预装LS-DYNA SMP/MPP, ANSYS Autodyn, Abaqus | 开箱即用,免License配置 |
五、工程实战:F35毁伤仿真的硬件性能解析
以文中400kg TNT-F35案例为参照,硬件负载分析如下:
模型规模:
-
TNT装药:SPH粒子约80万
-
空气域:SPH粒子约600万
-
F35结构:FEM壳单元50万+SPH粒子150万(蒙皮、框架)
-
总计:约880万粒子/单元
计算负载:
-
邻居搜索:每步需更新600万空气粒子+80万炸药粒子的邻居列表,内存带宽瓶颈
-
接触计算:爆轰产物与机身接触、机身自身大变形接触,单核性能敏感
-
时间步长:最小单元尺寸1mm,CFL时间步约0.5μs,20ms仿真需40,000步
-
数据输出:每100μs输出一帧,共200帧,总数据量约60GB
UltraLAB方案A表现:
-
单步计算时间:698X@4.3GHz ≈ 0.8秒/步
-
总计算时间:40,000步×0.8秒 ≈ 8.9小时(传统工作站3.2GHz需18+小时)
-
内存占用:峰值380GB(512GB配置余量充足)
-
后处理:RTX 5090D v2实时渲染粒子云图,避免传统CPU后处理的数小时等待
从微秒级的爆轰起爆到毫秒级的结构失效,SPH方法让"不可计算"的极端毁伤变得清晰可见。在装备抗爆设计与武器效能评估的国防科技前沿,算力不仅是效率工具,更是决定仿真保真度的核心要素。
UltraLAB针对爆炸冲击仿真的"单核高频敏感、内存带宽饥渴、数据输出洪峰"三大特征,提供从桌面旗舰到集群节点的全系列硬件方案。无论是400kg TNT的近距爆炸,还是超高速侵彻的穿甲过程,我们都能为您提供持续稳定的极致算力。
让每一颗SPH粒子的相互作用都算得精准,让每一次微秒级的时间推进都稳定可靠——UltraLAB,守护国防仿真的每一个毁伤细节。
本文技术案例引用自《400kg TNT爆炸冲击下F35战机的毁伤全过程》(欧帕提亚信息科技)
UltraLAB图形工作站供货商:
咨询微信号:100369800
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800



