






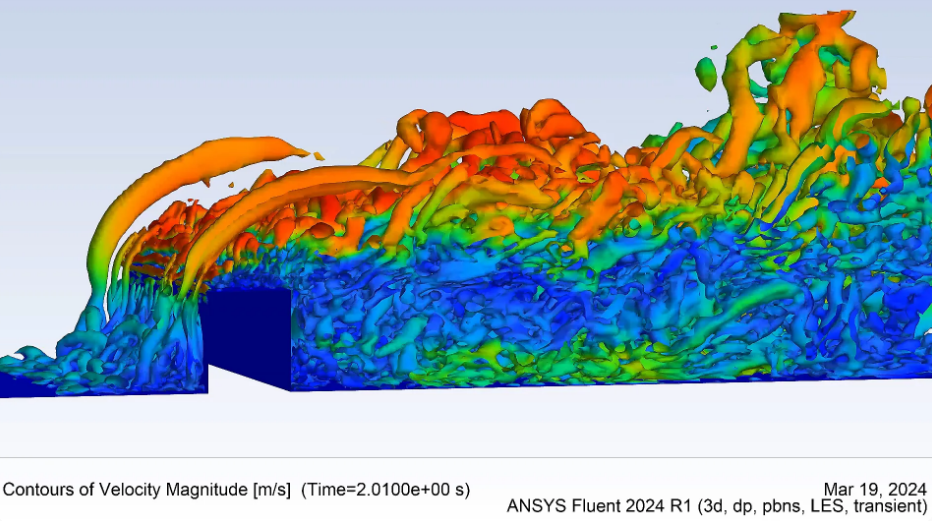
计算流体力学工程师都深有体会:大涡模拟(LES)能捕捉湍流的精细结构,但计算量实在太大了。一个整机空气动力学模型,跑一周还没出结果;一个燃气轮机燃烧室仿真,算一个月还在转圈。传统CPU集群跑LES,动辄数周甚至数月。而GPU加速正在彻底改变LES的游戏规则——让“等一周”变成“睡一觉”。
大涡模拟是当前湍流仿真的黄金标准。它直接解析大尺度湍流涡结构,只对亚格子尺度进行建模,精度远高于RANS,计算成本又远低于DNS。但LES对网格和时间的需求极其苛刻——边界层需要精细网格,时间步长受限于最小网格尺寸,需要模拟足够长的物理时间才能获得统计稳态结果。本文深度拆解LES的GPU加速技术,并提供UltraLAB从入门到集群的硬件方案。
一、大涡模拟算不动?GPU加速正在改写游戏规则
1. GPU vs CPU:不是快一点,是快一个数量级
GPU(图形处理器)拥有数千个计算核心,天然适合大规模并行计算。LES中每个网格单元的运算相互独立,正是GPU的用武之地。
来自工业界的真实数据:
- • 某LES仿真在1000个CPU核心上跑了超过2天,换成32块GPU,不到2小时就完成了[reference:0]。
- • 燃气轮机燃烧室LES对比测试显示,Native GPU求解器的计算速度显著优于CPU,且每个时间步所需的子迭代次数更少,在相同网格分辨率下能够解析出更丰富的湍流涡结构[reference:1]。
- • 西班牙超级计算中心的研究表明:在OpenFOAM中,一块A100 GPU的性能相当于200-300个Intel Sapphire Rapids CPU核心(当每GPU负载超过1000万网格时)[reference:2]。
- • 韩国研究团队测试了RapidCFD(OpenFOAM的GPU版本),摩托车绕流算例中,8-GPU系统相比CPU系统实现了20倍加速;空腔流动算例中,当网格规模增大时,加速比高达42倍[reference:3]。
加速倍数背后的逻辑:LES的每个时间步需要对数百万甚至数千万网格单元进行相同运算,GPU的数千个核心可以同时处理大量单元,实现巨大的并行吞吐量。
2. LES为什么特别适合GPU加速
| 计算环节 | 并行特征 | GPU适配度 | 说明 |
|---|---|---|---|
| 空间离散(梯度/通量计算) | 单元级并行 | ★★★★★ | 每个网格单元独立计算 |
| 时间推进(Runge-Kutta) | 步内并行 | ★★★★★ | 各单元并行推进 |
| 亚格子模型计算 | 单元级并行 | ★★★★★ | SGS应力计算高度并行 |
| 压力泊松方程求解 | 矩阵求解 | ★★★★ | 需要迭代,但线性代数库已高度优化(如AmgX) |
| 边界条件处理 | 边界节点并行 | ★★★★ | 可并行但需同步 |
| 输出/后处理 | I/O密集 | ★★★ | 存储带宽可能成瓶颈 |
结论:LES的核心计算环节几乎都可以高效并行,这是它比RANS(需要求解更多的全局输运方程)更适合GPU加速的重要原因。
3. GPU加速不是万能的——三个你必须知道的局限性
① 显存容量是硬门槛
GPU加速LES的最大限制是显存容量。一个5000万网格的LES模型,需要存储每个网格单元的速度分量(u,v,w)、压力(p)、亚格子应力张量(6个分量)、湍动能等场变量,以及矩阵系数等辅助数据。单精度下约需8-12GB显存,双精度需求翻倍。当显存装不下时,系统被迫使用CPU内存交换(通过PCIe通道),速度会断崖式下降。
② 不是所有求解器都支持GPU加速
- • ANSYS Fluent 2022R2及以上版本:提供Native GPU求解器,LES模块已全面支持[reference:4]。
- • OpenFOAM:可通过第三方库实现GPU加速。SPUMA是OpenFOAM的完整GPU移植版本,由CINECA超级计算中心开发,支持NVIDIA和AMD GPU[reference:5]。RapidCFD是另一个CUDA加速的OpenFOAM版本[reference:6]。amgx4Foam库可将OpenFOAM的线性求解器(如GAMG)迁移到NVIDIA AmgX库,加速压力泊松方程的求解[reference:7]。
- • 专用求解器:如CaLES(GPU加速的壁面湍流LES求解器),单GPU性能相当于约15个CPU节点[reference:8]。
③ CPU-GPU数据传输存在开销
每次时间步迭代,数据需要在CPU和GPU之间传输。如果求解器的GPU加速仅针对线性求解器(如OpenFOAM的amgx4Foam方式),矩阵组装仍在CPU上完成,需要频繁传输数据,加速效果受限[reference:9]。完整的GPU移植(如SPUMA)通过统一内存架构减少数据传输,效率更高[reference:10]。
二、三款CPU在大涡模拟中的定位对比
LES的GPU加速方案中,CPU的角色从"主力计算"转变为"辅助角色":负责网格分区、数据预处理、I/O管理、边界条件更新等任务。CPU单核主频在此场景下不再是核心关注点,核心数和内存通道更为重要。
| CPU型号 | 核心/线程 | 最大睿频 | 内存通道 | PCIe通道 | 在GPU加速LES中的角色 |
|---|---|---|---|---|---|
| Core i9-14900K | 24核/32线程 | 6.0 GHz | 2通道 | 20条 | 入门级CPU+单GPU,双通道带宽可能成为数据传输瓶颈 |
| Xeon 698X | 86核/172线程 | 4.8 GHz | 8通道 | 128条 | 主力推荐:8通道保障GPU数据传输带宽,128条PCIe支持多GPU |
| 双路 EPYC 9755 | 128核/256线程 | 3.7 GHz | 16通道 | 160条 | 集群级:极致内存带宽+PCIe通道,适合多GPU+多节点集群 |
性能解析:
- • Xeon 698X是GPU加速LES的最佳CPU搭档:8通道DDR5-6400提供>400GB/s内存带宽,128条PCIe 5.0通道可同时连接4-8块GPU且带宽充足。86核可高效处理网格分区、数据预处理等并行任务,4.8GHz主频足够应对边界条件更新等串行部分。
- • 双路EPYC 9755:16通道内存提供近800GB/s带宽,适合大规模多GPU集群场景。双路架构在NUMA配置下需注意跨插槽通信优化。
- • i9-14900K:双通道内存(约60GB/s)和有限的PCIe通道(20条)在多GPU场景下会成为瓶颈,仅适合单GPU、中小规模LES(<1000万网格)。
三、UltraLAB大涡模拟GPU加速硬件方案
方案A:入门级单GPU LES节点
适用场景:中小规模LES(<1000万网格)、算法验证、初步研究、教学演示
| 组件 | 推荐配置 | 技术逻辑 |
|---|---|---|
| CPU | Intel Core i9-14900K (24核, 6.0GHz睿频) | 24核满足中小规模预处理需求;6.0GHz主频应对边界条件等串行任务 |
| GPU | NVIDIA RTX 4090 24GB / RTX 5080 16GB | 24GB显存可承载约3000万网格的LES计算(单精度) |
| 内存 | 64GB DDR5-6400(双通道) | 64GB系统内存支撑网格分区与数据缓存 |
| 存储 | 2TB NVMe Gen4 | 快速读写每时间步输出的场数据 |
| 参考机型 | UltraLAB A330 | 桌面静音设计 |
性能预估:
- • 1000万网格LES(如汽车外流场),单GPU仿真时间比32核CPU集群快约5-10倍
- • 适合个人研究者、课题组初步验证
方案B:专业级多GPU LES主力节点
适用场景:中等规模LES(2000-5000万网格)、汽车/航空航天气动分析、燃烧室仿真
| 组件 | 推荐配置 | 技术逻辑 |
|---|---|---|
| CPU | Intel Xeon 698X (86核, 4.8GHz睿频) | 86核高效并行处理网格分区与数据预处理;8通道内存保障数据吞吐;128条PCIe 5.0支撑多GPU |
| GPU | NVIDIA RTX 5090 32GB × 2 / H100 80GB | 双GPU并行,LES在多GPU上的扩展效率接近线性;32-80GB显存支撑5000万-1亿网格 |
| 内存 | 256GB DDR5-6400 ECC(8通道插满) | 256GB支撑大规模网格分区数据;ECC保障长时间仿真稳定性 |
| 存储 | 4TB NVMe Gen5 RAID0 + 36TB HDD | RAID0加速每步结果写入 |
| 参考机型 | UltraLAB GT430P | 塔式/4U机架可选,支持4GPU扩展 |
技术亮点:
- • Xeon 698X + 双GPU组合:CPU的8通道高带宽保障数据从系统内存到GPU的传输不成为瓶颈
- • 双GPU线性扩展:2块GPU相比单GPU可提速约1.8倍(基于多GPU测试数据的推算)
- • Fluent Native GPU求解器:支持多GPU原生加速,无需额外配置
性能预估:
- • 3000万网格汽车外流场LES,双GPU方案比64核CPU集群快约15-20倍
- • 燃气轮机燃烧室LES(2000万网格),双GPU仿真时间<12小时
方案C:超大规模多GPU集群节点
适用场景:大规模LES(5000万-2亿网格)、全飞机气动分析、发动机整机燃烧仿真、多物理场耦合
| 组件 | 推荐配置 | 技术逻辑 |
|---|---|---|
| CPU | 双路 AMD EPYC 9755 (128核, 3.7GHz基频) | 128核处理大规模网格分区;16通道内存提供近800GB/s带宽;160条PCIe 5.0支持8+GPU |
| GPU | NVIDIA H100 80GB × 4 / H200 141GB × 4 | 四GPU并行,显存总计320-564GB,支撑2亿网格以上LES |
| 内存 | 512GB DDR5-6400 ECC(16通道插满) | 512GB缓存大规模网格与中间数据 |
| 存储 | 8TB NVMe Gen5 RAID0 + 100TB HDD阵列 | RAID0支撑TB级结果数据的快速写入 |
| 网络 | 100GbE InfiniBand | 多节点分布式GPU求解(如Fluent的多节点GPU模式) |
| 参考机型 | UltraLAB GA660M | 4U机架式,支持8张GPU,液冷散热 |
技术亮点:
- • 四GPU并行扩展:研究显示,8-GPU系统相比CPU系统的加速比可达20-42倍(取决于网格规模),四GPU可获得10-20倍加速[reference:11]
- • 16通道内存架构:保障大规模网格分区数据的高吞吐
- • 集群扩展能力:通过InfiniBand将多个节点互联,可实现千GPU级并行,将数周仿真压缩至数小时
性能预估:
- • 全飞机LES(1亿网格),四GPU方案仿真时间<24小时
- • 原需1000+ CPU核心运行2天的LES,32-GPU集群可压缩至2小时以内[reference:12]
四、LES GPU加速实操指南
1. 如何选择GPU加速方案
| 软件平台 | GPU加速方案 | 显存建议 | 适用场景 |
|---|---|---|---|
| ANSYS Fluent 2022R2+ | Native GPU求解器(原生支持) | 32GB+ | LES、反应流、多相流,开箱即用 |
| OpenFOAM | SPUMA(完整GPU移植) | 32GB+ | 开源方案,支持NVIDIA/AMD GPU |
| OpenFOAM | RapidCFD(CUDA加速) | 24GB+ | 基于OpenFOAM的GPU实现 |
| OpenFOAM | amgx4Foam(线性求解器加速) | 24GB+ | 仅加速压力泊松方程求解 |
| CaLES | OpenACC + CUDA Fortran | 64GB+(H100) | 壁面湍流LES专用求解器 |
2. 显存容量与网格规模对应关系
- • 每1000万网格(双精度)约需16-20GB显存
- • 显存容量=网格规模的硬约束:5000万网格需要80GB以上显存
- • 建议选择RTX 5090 32GB、H100 80GB、RTX PRO 6000 96GB等大显存GPU
3. GPU加速效果最大化技巧
- • 优先使用Native GPU求解器:Fluent Native GPU Solver已针对LES优化,支持"Optimized LES Numerics"设置,可在相同网格下解析更多湍流涡结构[reference:13]
- • 每GPU负载建议≥800万网格:研究显示,当每GPU负载超过800万网格时,GPU利用率可达65%,扩展效率更高[reference:14]
- • 多GPU并行:LES在多GPU上的扩展效率接近线性(每增加一块GPU,速度提升约0.8-0.9倍)
- • CPU-GPU协同:将矩阵组装等预处理任务留在CPU上,GPU专注于线性求解器加速,避免频繁数据传输
五、结语:GPU加速正在重塑大涡模拟
大涡模拟的算力瓶颈正在被GPU加速技术打破。ANSYS Fluent Native GPU Solver、SPUMA、RapidCFD等方案的出现,让原本需要数周甚至数月的高精度LES仿真,变成了数小时到数天的工程实践。
对于LES用户,硬件选型的核心逻辑正在发生变化:从"堆CPU核心"转向"堆GPU显存+核心"。
- • 如果你从事中小规模LES(<1000万网格),单GPU + i9-14900K即可入门
- • 如果你是专业CFD工程师(2000-5000万网格),Xeon 698X + 双RTX 5090是主力组合,86核保障数据预处理,32GB×2显存支撑中等规模LES
- • 如果你是航空/能源领域从事超大规模LES(5000万网格+),双路EPYC 9755 + 四H100是终极方案,配合多节点集群将数周计算压缩至数小时
UltraLAB大涡模拟GPU加速方案,正是基于对LES计算特征和GPU并行架构的深度理解而设计。从入门单卡到多卡集群,每一款工作站的配置逻辑都源自真实LES负载的量化分析——让工程师专注于湍流机理与工业应用,而非在漫长的仿真等待中消耗时间。
如需针对具体LES场景(航空气动/燃烧室/涡轮机械)、网格规模(千万/亿级)及求解器(Fluent/OpenFOAM)的定制化配置,欢迎联系UltraLAB技术顾问团队进行真实LES基准测试预约。
咨询微信号:Munchen_1900


