

适用读者:编译器与工具链研发人员、嵌入式与芯片软件团队、大型代码库构建运维、静态分析与安全审计团队。
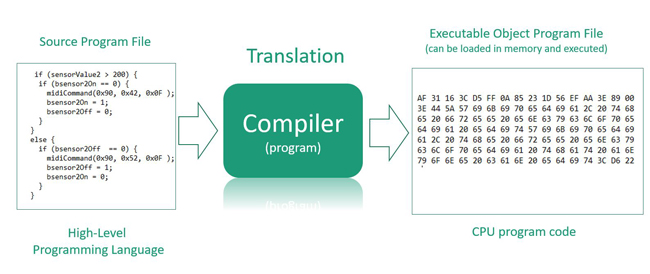
一、资料背景与核心观点
资料来源
- LLVM 官方文档(优化 Pass 与 LTO)(https://llvm.org/docs/)
- Clang 官方文档(前端与静态分析)(https://clang.llvm.org/)
核心观点
- 编译是典型的单线程主导负载:单个翻译单元的解析与优化多为串行,核心数增加只在多文件并行构建时生效。
- 链接期优化(LTO)把全程序中间表示合入内存再做跨模块优化,内存占用可达源码与 IR 体积的数倍,是编译流程中最吃内存的环节。
- 静态分析与符号执行的分支探索复杂度可随代码路径指数增长,单次分析耗时高度不确定,硬件上更依赖单核性能与内存带宽。
- 增量构建与缓存(ccache、分布式编译)能把重复编译转为 I/O 与网络负载,硬件重心随之转向存储与网络。
二、核心算法与功能模块
核心算法
- 词法语法分析与 AST 构建。
- SSA 中间表示与数据流分析。
- 优化 Pass 管线(内联、循环变换、向量化)。
- 寄存器分配与指令选择。
- 链接期优化与全程序分析。
功能模块
- 编译驱动与构建系统集成。
- 交叉编译与多目标代码生成。
- 静态分析、符号执行与模糊测试插桩。
- 调试信息生成与二进制分析。
三、计算特点与性能瓶颈
计算负载特征
- 计算类型:分支密集的标量运算,单核性能与缓存命中率决定速度。
- 并行方式:按翻译单元并行(多进程构建);单个 TU 内并行度很低。
- 内存与显存:内存容量决定 LTO 与全程序分析能否完成;显卡基本不参与。
- I/O 特点:大量头文件与小目标文件随机读写,需低延迟 NVMe;分布式构建吃网络。
关键硬件约束
这类任务几乎不受 GPU 加速,把预算投入显卡是错配;核心数应按并行构建的 TU 数量选取,超过并行度后收益消失;内存不足会使 LTO 直接失败而非变慢。
四、典型应用场景
- 轻量:单模块开发编译、小型项目静态检查。
- 中等:大型项目全量构建、LTO 链接、多目标交叉编译。
- 大规模:超大型代码库分布式构建、全程序静态分析与模糊测试集群。
五、UltraLAB 硬件配置分级方案
表1 UltraLAB 硬件配置分档建议
| 档位 | CPU选型思路 | 内存配置 | GPU选型(核心) | 存储配置 | 散热与扩展性 | 适用场景 |
|---|---|---|---|---|---|---|
| 轻量档 | 参考 A350 平台,Ultra9 285K 24核 5.5GHz,单核强、并行构建够用 | 96 至 128GB DDR5,支撑中型项目 LTO | 集成或入门专业卡,仅用于显示与调试 | 2TB NVMe 系统盘 + 4TB NVMe 项目盘 | 塔式风冷,静音设计 | 单模块开发、小型项目检查 |
| 主流档 | 参考 GR450P 平台,霄龙 7975WX 32核 5.0GHz 或 7980X 64核,高频多核兼顾 | 192 至 256GB DDR5,支撑全程序 LTO | 专业卡用于显示与二进制可视化 | 4TB NVMe + 8TB NVMe 构建缓存盘 | 双冷排水冷,构建缓存独立盘位 | 大型项目全量构建、LTO 链接 |
| 大规模档 | 参考 EA660 双路平台,2×霄龙 9575F 128核 4.5GHz,兼顾高并行构建与高频 | 512GB 以上 DDR5,支撑超大 IR 与并行链接 | 专业卡用于显示 | Gen4/Gen5 NVMe 阵列 + 万兆网络 | 机架或塔式水冷,接入分布式构建集群 | 超大型代码库构建、全程序分析 |
选型原则:以并行 TU 数定核心,以 LTO 峰值定内存,以头文件与小文件读写定 NVMe。
六、配套软件清单
表2 配套软件清单
| 软件类别 | 软件名称 | 版本/要求 | 必需/可选 |
|---|---|---|---|
| 编译器工具链 | LLVM/Clang、GCC | 按目标版本 | 必需 |
| 构建系统 | CMake、Ninja、Bazel | 稳定版 | 必需 |
| 构建缓存 | ccache、sccache | 稳定版 | 可选 |
| 静态分析 | Clang Static Analyzer、CodeQL 类工具 | 稳定版 | 可选 |
| 二进制分析 | objdump、llvm-objdump、反汇编工具 | 稳定版 | 可选 |
| 运行环境 | Ubuntu 22.04 LTS 或 Linux 发行版 | LTS | 必需 |
七、常见选型问题与硬件分析
Q:编译任务需要好显卡吗?
A:不需要。除显示与二进制可视化外,编译与静态分析几乎不用 GPU,预算应投入单核性能、内存与 NVMe。
Q:LTO 为什么总是内存不足?
A:LTO 把全程序 IR 载入内存后再优化,峰值可达常规编译的数倍。按代码库规模预留内存,或改用 ThinLTO 降低峰值。
Q:核心数该怎么选?
A:按并行构建的翻译单元数选取。TU 数不足时多核会闲置,此时提高单核频率的收益更直接。
Q:分布式构建值得上吗?
A:代码库极大、单机构建时间过长时值得。分布式构建把负载转到网络,需配套万兆网络与统一缓存,否则收益被 I/O 抵消。
八、总结与选型建议
- 负载本质是单核标量运算加内存容量,GPU 基本无关。
- 轻量档覆盖日常开发;主流档对应大型项目 LTO;大规模档用于超大型代码库与全程序分析。
- 优先提高单核频率与内存容量,再按并行度扩核心;构建缓存与 NVMe 能显著改善体感。
补充说明:编译时间受代码结构、头文件依赖与优化等级影响很大,本文给出的配置分档用于容量与并行度判断,不代表具体项目的编译耗时。
参考来源
- LLVM 官方文档(优化 Pass 与 LTO):https://llvm.org/docs/
- Clang 官方文档(前端与静态分析):https://clang.llvm.org/