






摘要:现代战场电磁环境已从"单纯噪声压制"演变为"灵巧转发、间歇采样、复合调制"并存的高烈度对抗格局。本文基于九类典型雷达干扰信号的数学建模与七维多域特征提取方案,深入解析AI大模型在干扰智能识别、特征工程自动化、对抗策略生成中的本地部署价值,并提供UltraLAB硬件平台的完整选型方案、软件生态清单及典型应用场景配置建议。
目录
- 雷达干扰信号智能识别技术解析
- AI大模型赋能干扰智能识别
- 大模型本地部署的算力需求特征
- UltraLAB硬件配置选型指南
- 软件清单与工具链
- 典型应用场景与配置推荐
- 常见问题与硬件配置分析
一、雷达干扰信号智能识别技术解析
1.1 复杂电磁环境的核心挑战
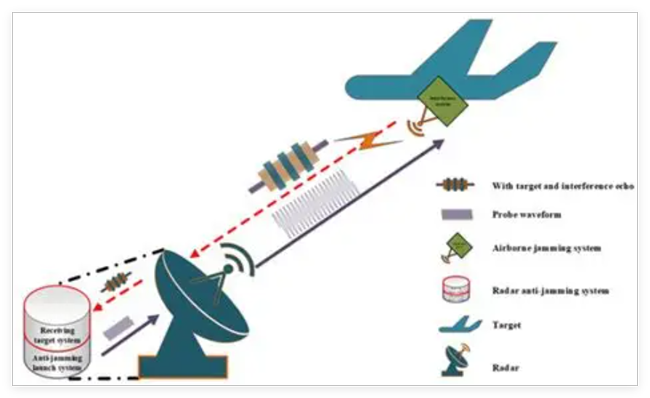
现代战场电磁环境呈现出"密度高、样式多、变化快"的显著特征。干扰体制从早期的窄带瞄准式、阻塞式噪声压制,逐步演进为以数字射频存储(DRFM)技术为核心的灵巧转发、间歇采样转发等新型体制。同一作战场景中往往存在多种干扰样式叠加、交替出现的复杂情况。
干扰识别的战略价值:干扰类型准确识别是实施对抗决策的首要前提——压制式干扰需要提高发射功率或切换频点,转发欺骗式干扰则需要采用脉内特征鉴别与波形分集策略,误判将导致抗干扰资源被严重浪费。
1.2 九类典型干扰信号建模
本文以线性调频(LFM)脉冲作为雷达发射基准信号,构建了覆盖三大干扰体系、共九类典型干扰的可计算信号模型:
| 干扰体系 | 类别编号 | 干扰类型 | 核心机制 | 信号特征 |
|---|---|---|---|---|
| 转发欺骗类 | 类1 | 全脉冲转发 | DRFM单次延时放大转发 | 距离维单个欺骗假目标 |
| 转发欺骗类 | 类2 | 全脉冲密集转发 | 多次延时转发叠加 | 距离维3-6个密集假目标群 |
| 转发欺骗类 | 类3 | 间歇采样转发(ISRJ) | 周期截取信号片段交替转发 | 脉压失配产生密集假目标 |
| 转发欺骗类 | 类4 | 部分脉冲密集转发 | 脉宽内随机区间密集转发 | 部分脉冲覆盖,抗识别能力强 |
| 噪声调制类 | 类5 | 灵巧噪声(ISRJ调制) | DRFM相干信号与随机噪声相乘 | 兼具相干性与随机性 |
| 压制类 | 类6 | 噪声调频 | 宽带噪声经调频器产生 | 瞬时频率连续变化 |
| 压制类 | 类7 | 宽带压制 | 接收带宽内注入高斯白噪声 | 频谱最为平坦 |
| 压制类 | 类8 | 扫频干扰 | 瞬时频率周期性扫描 | 能量聚焦式时变压制 |
| 压制类 | 类9 | 梳状谱干扰 | 多个窄带载波叠加 | 频域梳齿状多峰结构 |
1.3 七维多域特征提取方案
从时域、频域及时域统计三个维度设计了七维物理可解释特征:
| 特征维度 | 符号 | 物理含义 | 判别作用 |
|---|---|---|---|
| 能量特征 | F1 | 信号总功率 | 压制类最高,转发类偏低,第一层粗筛 |
| 带宽特征 | F2 | -10dB频谱宽度 | 转发类集中主瓣,噪声调频最宽,梳状谱最窄 |
| 时域连续性系数 | F3 | 低于阈值采样点占比 | ISRJ与部分脉冲转发因"时断时续"显著降低 |
| 采样窗均值 | F4 | 脉冲头尾平均幅度 | 区分密集转发(前后沿有能量)与ISRJ(仅中段) |
| 时宽特征 | F5 | 包络高于0.1阈值的时间跨度 | 压制类非脉冲型,时宽普遍偏小 |
| 频域矩偏度 | F6 | 频谱三阶中心矩归一化 | 宽带压制对称(偏度≈0),扫频倾斜(负偏度) |
| 局部矩偏度 | F7 | 子段偏度均值 | 捕捉频谱局部形态差异,细化压制类内部边界 |
1.4 实验结果与关键发现
| 实验配置 | 方法 | 整体精度 | 压制类精度 | 关键发现 |
|---|---|---|---|---|
| 九类单干扰(1000样本/类) | 决策树(CART) | 83.8% | 93%-99% | 能量特征重要性占绝对主导 |
| 十二类含复合干扰(300样本/类) | 深度CNN(ECNN) | 随样本比例提升 | — | 小样本下性能受限,数据充足时优势显现 |
反直觉发现:特征重要性排序显示,能量特征(F1)在分类决策中占据绝对主导地位,远超工程师直觉中的带宽、偏度等精细特征。这一发现为特征工程提供了全新审视视角。
二、AI大模型赋能干扰智能识别
2.1 从人工特征到认知智能的跃迁
传统干扰识别沿两条技术路线展开:基于人工特征的浅层分类(SVM/决策树/随机森林)和基于深度学习的端到端识别(CNN/RNN)。面对以下挑战时,两者均存在局限:
- 复合干扰涌现:多种干扰样式叠加,传统七维特征无法覆盖组合模式
- 新型干扰迭代:DRFM技术持续演进,固定特征库难以跟上干扰体制变化
- 小样本困境:真实干扰数据获取成本高、标注困难,深度学习性能退化
- 特征工程瓶颈:人工特征设计高度依赖专家经验,跨场景泛化能力受限
2.2 大模型在干扰识别中的核心能力矩阵
| 能力维度 | 传统方法 | 大模型增强方案 | 技术实现 |
|---|---|---|---|
| 干扰语义理解 | 固定特征向量输入 | 自然语言描述干扰特征与类型 | 多模态LLM + 结构化信号数据 |
| 复合干扰分解 | 单一标签分类 | 多标签联合推理、成分分解 | 时频图ViT + Transformer解码器 |
| 新型干扰发现 | 规则匹配失败即丢弃 | 零样本/少样本新型干扰识别 | 对比学习 + 提示工程(Prompt) |
| 特征工程自动化 | 人工设计七维特征 | 自动发现高判别力特征组合 | 自动化机器学习(AutoML) + LLM |
| 对抗策略生成 | 固定对抗规则表 | 上下文感知的动态对抗建议 | LLM + 电子战知识图谱 |
| 实验报告生成 | 人工撰写分析文档 | 自动分析结果、生成专业报告 | LLM + 结构化实验数据映射 |
2.3 本地化部署的战略必要性
雷达干扰信号数据涉及敌方干扰体制特征、我方雷达参数、对抗策略等核心军事机密,云端部署存在严重泄露风险。大模型本地部署的核心价值:
- 数据主权:原始IQ数据、干扰样本、识别模型完全留存在本地
- 低延迟响应:边缘推理将"接收→识别→决策"闭环压缩至毫秒级
- 离线可用:拒止环境下不依赖外部网络,保障独立对抗能力
- 持续进化:基于本场电磁环境数据持续微调,形成专属识别智能
三、大模型本地部署的算力需求特征
3.1 干扰识别AI工作负载画像
| 工作负载类型 | 计算特征 | 显存需求 | 典型模型规模 | 延迟要求 |
|---|---|---|---|---|
| 实时干扰分类 | 高并发脉冲、FP16/INT8推理 | 8-16 GB | 时频图CNN / 轻量Transformer 10M-100M | <10ms/脉冲 |
| 复合干扰分解 | 多标签推理、时频图序列 | 12-24 GB | 时频ViT / 多模态模型 100M-1B | <50ms |
| 新型干扰发现 | 零样本推理、对比学习 | 16-48 GB | CLIP-style对比模型 100M-3B | <100ms |
| 对抗策略生成 | 长文本生成、知识推理 | 24-48 GB | LLaMA-3 / Qwen2 13B-70B | <2s |
| 特征工程AutoML | 大规模特征搜索、评估 | 16-48 GB | AutoML + 元学习模型 1B-7B | <5s |
| 模型微调训练 | 本场干扰适配、增量学习 | 48-192 GB | 7B-70B参数 LoRA/QLoRA | 小时级 |
3.2 硬件瓶颈分析
| 组件 | 信号处理瓶颈 | AI大模型瓶颈 | 混合场景影响 |
|---|---|---|---|
| CPU | STFT变换、特征提取、脉冲压缩 | Tokenizer、数据预处理、后处理 | 需兼顾高主频与多核心 |
| GPU | 时频图生成、大规模矩阵运算 | 模型推理/训练核心算力 | 显存容量与计算密度双重约束 |
| 内存 | 原始IQ数据缓存、脉冲积累 | 模型权重、KV Cache、数据集 | 128GB起步,256GB为佳 |
| 存储 | 干扰样本库、实验数据 | 模型权重、训练数据 | NVMe SSD为刚需 |
| 网络 | 多雷达节点数据汇聚 | 分布式训练梯度同步 | 低延迟、高带宽通信 |
四、UltraLAB硬件配置选型指南
4.1 UltraLAB产品矩阵与干扰识别场景匹配
| 系列定位 | 典型型号 | 核心特征 | 适用场景 |
|---|---|---|---|
| 信号处理节点 | UltraLAB A330 | 紧凑加固、单卡高性能、宽温抗震 | 雷达信号处理节点、前端AI推理 |
| 分析识别中心 | UltraLAB GX620 | 双路CPU+双卡GPU、大内存、静音 | 干扰分析中心、多源数据融合 |
| AI训练进化型 | UltraLAB TX830 | 四卡/八卡GPU、NVLink互联 | 基地模型训练、新型干扰学习 |
| 集群协同型 | UltraLAB CX Series | 多节点IB网络、并行文件系统 | 战区数据中心、多模型并行 |
4.2 关键硬件组件选型原则
CPU选型:高主频保障实时性,多核心支撑多通道并行
| 平台 | 推荐型号 | 核心/线程 | 基频/睿频 | 内存通道 | 适用场景 |
|---|---|---|---|---|---|
| Intel 高主频单路 | Core i9-14900KS | 24C/32T | 3.2/6.0 GHz | 2通道DDR5 | 单节点实时处理 |
| Intel 均衡分析 | Xeon W7-3465X | 28C/56T | 2.5/4.8 GHz | 8通道DDR5 | 前后处理+中等规模分析 |
| Intel 双路扩展 | Xeon Platinum 8580 ×2 | 120C/240T | 1.9/3.5 GHz | 16通道DDR5 | 大规模多通道并行分析 |
| AMD 高主频 | Ryzen 9 7950X3D | 16C/32T | 4.2/5.7 GHz | 2通道DDR5 | 性价比前端节点 |
| AMD 分析+AI | Threadripper PRO 7995WX | 96C/192T | 2.5/5.1 GHz | 8通道DDR5 | 超大内存多通道处理 |
GPU选型:从时频图处理到AI推理的全覆盖
| 应用场景 | 推荐GPU | 显存 | 算力(FP16) | 关键特性 | 单卡功耗 |
|---|---|---|---|---|---|
| 时频图可视化 | NVIDIA RTX A4000 / A5000 | 16-24 GB | — | ISV认证、稳定驱动、ECC | 140-230W |
| 识别+轻量AI推理 | RTX 4070 Ti SUPER / RTX 4090 | 16-24 GB | 40-82 TFLOPS | 高性价比、INT8量化 | 285-450W |
| 专业识别+AI融合 | RTX 5000 Ada / RTX 6000 Ada | 32-48 GB | 65-91 TFLOPS | ISV认证、大显存、ECC | 230-300W |
| 企业级AI训练 | A100 80GB / H100 80GB | 80 GB | 312-989 TFLOPS | NVLink、Transformer Engine | 400-700W |
内存与存储配置
| 配置等级 | 内存容量 | 内存类型 | 系统盘 | 数据盘 | 适用场景 |
|---|---|---|---|---|---|
| 单处理节点 | 128 GB | DDR5-5600 ECC | 2TB NVMe Gen4 | 4TB NVMe SSD | 单站实时处理 |
| 分析识别中心 | 256-512 GB | DDR5-4800 ECC RDIMM | 4TB NVMe Gen5 | 16TB NVMe SSD | 多源融合、态势分析 |
| 基地训练中心 | 1-2 TB | DDR5-4800 ECC RDIMM | 8TB NVMe Gen5 | 全闪存阵列 | 大规模模型训练 |
关键提示:雷达原始IQ数据量巨大,以LFM信号为例,采样率40MHz下持续录制1小时数据可达数百GB。AI模型训练需大量干扰样本,建议存储配置以NVMe SSD为主,确保数据快速读取。
五、软件清单与工具链
5.1 基础软件栈
| 层级 | 软件组件 | 版本建议 | 功能说明 |
|---|---|---|---|
| 操作系统 | Ubuntu Server LTS / 银河麒麟V10 | 22.04/24.04 | 稳定、长期支持、国产化适配 |
| 容器运行时 | Docker + NVIDIA Container Toolkit | 24.x + 1.14.x+ | GPU容器化部署,环境隔离 |
| 编排平台 | K3s / K8s + GPU Operator | 1.28+ | 边缘/中心资源调度 |
| CUDA工具包 | CUDA Toolkit | 12.2+ | GPU并行计算基础 |
| cuDNN/TensorRT | NVIDIA深度学习库 | 8.9+ / 9.0+ | 推理加速与量化 |
5.2 大模型推理与训练框架
| 框架 | 适用场景 | 核心优势 | 推荐版本 |
|---|---|---|---|
| TensorRT | 生产级推理加速 | 极致性能、INT8/FP8量化 | 9.0+ |
| vLLM | 高并发策略生成服务 | PagedAttention、连续批处理 | 0.5.x+ |
| PyTorch | 模型训练与微调 | 生态完善、动态图灵活 | 2.3+ |
| JAX + Flax | 神经算子/信号处理研究 | 自动微分、XLA编译加速 | 0.4+ |
| ONNX Runtime | 跨平台推理部署 | 模型格式统一、硬件无关 | 1.18+ |
| Ollama | 本地快速体验 | 一键部署、简易API | 0.3.x+ |
5.3 雷达信号处理与干扰识别专用工具链
| 工具类型 | 推荐工具 | 功能描述 |
|---|---|---|
| 雷达信号处理 | MATLAB Radar Toolbox / CUDA Radar SDK | 脉冲压缩、STFT、CFAR、时频分析 |
| 时频图生成 | Python + SciPy / PyTorch STFT | 微多普勒特征提取、时频图生成 |
| 传统分类器 | scikit-learn (决策树/SVM/随机森林) | 七维特征分类、基线模型 |
| 深度学习 | PyTorch / TensorFlow | CNN/RNN/Transformer干扰识别模型 |
| AutoML | AutoGluon / FLAML | 自动特征工程、超参数优化 |
| 信号可视化 | MATLAB / Python + Matplotlib | 时域/频域/时频图可视化 |
| 数据存储 | InfluxDB / TimescaleDB | 时序雷达数据高效写入查询 |
| 向量数据库 | Milvus / pgvector | 干扰特征向量存储与相似性检索 |
| 知识图谱 | Neo4j | 干扰体制知识库、对抗策略关联 |
5.4 干扰识别AI模型生态
| 模型类型 | 代表模型/架构 | 应用场景 | 参数规模 |
|---|---|---|---|
| 干扰分类 | ResNet / EfficientNet | 时频图干扰类型分类 | 10M-100M |
| 复合干扰分解 | Time-Series Transformer | 多标签联合推理、成分分解 | 100M-1B |
| 新型干扰发现 | CLIP / SimCLR | 零样本/少样本新型干扰识别 | 100M-1B |
| 特征工程 | AutoML + 元学习 | 自动发现高判别力特征组合 | 10M-100M |
| 对抗策略生成 | LLaMA-3 / Qwen2 / DeepSeek | 动态对抗建议、策略生成 | 7B-70B |
| 报告生成 | LLaVA-1.6 / Qwen-VL | 实验报告撰写、结果解读 | 7B-72B |
六、典型应用场景与配置推荐
6.1 场景一:雷达信号处理节点——边缘实时干扰识别
需求特征:
- 部署于雷达设备舱或近端机房
- 实时处理雷达IQ数据,延迟<10ms
- 运行STFT变换+特征提取+干扰分类
- 宽温、抗震、电磁兼容
UltraLAB推荐配置:
| 组件 | 规格 | 选型理由 |
|---|---|---|
| 机型 | UltraLAB A330 加固型 | 紧凑2U机箱,军用级抗震动 |
| CPU | Intel Core i9-14900KS | 睿频6.0GHz,保障STFT与特征提取实时 |
| GPU | RTX 4090 24GB ×1 | 单卡高算力,时频图推理+INT8量化 |
| 内存 | 128 GB DDR5-5600 ECC | IQ数据缓存与模型权重驻留 |
| 存储 | 2TB NVMe Gen4(系统) + 4TB NVMe(数据) | 高速录制雷达数据 |
| 网络 | 双万兆以太网 | 雷达数据接入与上行汇聚 |
| 功耗 | 整机≤800W | 适配雷达站供电 |
| 预估价格区间 |
|
— |
6.2 场景二:干扰分析识别中心——多源数据融合与智能研判
需求特征:
- 同时接入多部雷达实时数据流
- 运行复合干扰分解、新型干扰发现模型
- 运行13B-70B多模态大模型,支持对抗策略生成
- 7×24小时稳定运行
UltraLAB推荐配置:
| 组件 | 规格 | 选型理由 |
|---|---|---|
| 机型 | UltraLAB GX660 塔式/机架式 | 双路CPU+双GPU,均衡扩展 |
| CPU | Xeon Platinum 8580 ×2 | 120核240线程,多雷达数据并行融合 |
| GPU | RTX 6000 Ada 48GB ×2 或 A100 80GB ×2 | NVLink互联,大模型推理+可视化 |
| 内存 | 512 GB DDR5-4800 ECC RDIMM | 多路雷达数据缓存与模型驻留 |
| 存储 | 4TB NVMe Gen5(系统) + 32TB NVMe SSD(数据) | 高IOPS支撑并发分析 |
| 网络 | 双25GbE + 100GbE RDMA | 多雷达高速数据汇聚 |
| 显示 | 多路4K输出,支持大屏拼接 | 态势图、时频图墙、数据面板 |
| 功耗 | 整机≤2000W | 机房空调适配 |
| 预估价格区间 | ¥300,000 - ¥600,000 | — |
6.3 场景三:基地AI训练中心——新型干扰学习与模型进化
需求特征:
- 全参数微调70B+多模态识别模型
- 训练本场电磁环境下的专属识别智能
- 多任务并行:干扰分类、复合分解、策略生成同时训练
- PB级雷达数据长期存储
UltraLAB推荐配置:
| 组件 | 规格 | 选型理由 |
|---|---|---|
| 机型 | UltraLAB GX668 八卡AI服务器 | 旗舰训练平台 |
| CPU | Xeon Platinum 8592+ ×2 | 最高PCIe带宽,8卡全速运行 |
| GPU | H100 80GB NVLink ×8 | 最大显存、Transformer Engine |
| 内存 | 2 TB DDR5-4800 ECC | 大规模数据并行 |
| 存储 | 8TB NVMe Gen5 + 全闪存阵列(PB级) | 并行文件系统 |
| 网络 | NVIDIA Quantum-2 InfiniBand NDR 400G | 多节点扩展 |
| 预估价格区间 | ¥2,000,000 - ¥4,000,000 | — |
6.4 场景四:分布式识别网络——边缘-中心协同架构
| 层级 | 节点数量 | UltraLAB配置 | 功能定位 |
|---|---|---|---|
| 边缘处理层 | 10-30个 | AX410 + RTX 4090 | 单雷达STFT+特征提取+基础分类 |
| 区域融合层 | 3-5个 | GX620 + A100 ×2 | 多雷达数据融合、复合干扰分解 |
| 中心训练层 | 1-2个 | TX830 + H100 ×8 | 全局模型训练、新型干扰学习 |
七、常见问题与硬件配置分析
7.1 STFT变换延迟:时频图生成跟不上脉冲重复频率
问题现象:STFT计算耗时>10ms;时频图生成跟不上雷达脉冲重复频率;干扰识别延迟超标。
根因分析:
- STFT计算量大,CPU单核性能不足
- 未使用GPU加速FFT/卷积运算
- 内存带宽不足,数据搬运成为瓶颈
UltraLAB解决方案:
| 策略 | 配置调整 | 效果 |
|---|---|---|
| GPU加速STFT | RTX 4090 CUDA加速时频变换 | 时频图生成速度提升50-100倍 |
| 高主频CPU | 睿频≥5.5GHz(i9-14900KS) | 特征提取速度提升30-50% |
| 内存扩容 | 128GB+ DDR5-5600 | 多脉冲数据全内存驻留 |
| TensorRT推理 | INT8量化部署分类模型 | 推理延迟降至<1ms |
7.2 显存不足:大模型无法加载或batch受限
问题现象:加载13B复合干扰分解模型时显存不足;多脉冲并发推理时显存溢出。
根因分析:
- 13B模型FP16权重约26GB,加上KV Cache超出24GB显存
- 高分辨率时频图(1024×1024)输入占用大量显存
- 多模型同时驻留需显存叠加
UltraLAB解决方案:
| 策略 | 配置调整 | 效果 | 适用场景 |
|---|---|---|---|
| INT8/INT4量化 | TensorRT量化部署 | 显存降至~8-15GB | 边缘实时推理 |
| 模型分时加载 | 按需加载/卸载模型 | 单卡轮流运行多模型 | 显存受限节点 |
| 升级大显存GPU | RTX 6000 Ada 48GB / A100 80GB | 原生支持多模型并发 | 专业识别节点 |
| 模型蒸馏 | 使用100M小模型替代1B模型 | 速度提升10倍 | 资源受限场景 |
7.3 小样本下深度学习性能退化
问题现象:真实干扰样本不足(<300/类),CNN识别精度显著下降;复合干扰样本稀缺,模型泛化能力差。
根因分析:
- 深度学习模型参数量大,小样本下过拟合严重
- 复合干扰组合多样,样本覆盖不全
- 缺乏有效的数据增强策略
UltraLAB解决方案:
| 优化层 | 具体措施 | 预期提升 |
|---|---|---|
| 迁移学习 | 基于仿真数据预训练,真实数据微调 | 小样本精度提升20-30% |
| 数据增强 | 时频图变换、噪声叠加、混合样本 | 有效样本量扩大5-10倍 |
| 大显存训练 | A100/H100 80GB QLoRA训练 | 支持更大batch微调 |
| 集成学习 | 多模型投票、Bagging/Boosting | 降低方差,提升稳定性 |
7.4 多雷达数据同步:航迹关联与干扰源定位延迟高
问题现象:多部雷达协同探测时,数据同步延迟>100ms;干扰源定位精度不足。
根因分析:
- 网络带宽不足,IQ数据传输延迟
- 中心节点计算瓶颈
- 缺乏边缘预处理
UltraLAB解决方案:
| 层级 | 优化措施 | 目标指标 |
|---|---|---|
| 边缘预处理 | AX410本地完成STFT与特征提取 | 单节点延迟<10ms |
| 区域融合 | GX620负责多雷达数据融合 | 区域融合延迟<50ms |
| 网络优化 | 100GbE RDMA | 雷达间通信延迟<1ms |
7.5 长时间野外稳定性:环境适应性不足
问题现象:高温时GPU降频、推理延迟增加;低温时硬盘无法启动。
根因分析:
- 消费级GPU散热设计基于空调机房
- 机械硬盘无法承受温湿度变化
UltraLAB解决方案:
| 环境因素 | 风险 | 应对措施 |
|---|---|---|
| 高温(>50°C) | GPU热节流 | 宽温级散热、液冷方案 |
| 低温(<-20°C) | 硬盘失效 | 工业级SSD、预热电路 |
| 震动 | 硬盘损坏 | 全固态存储、加固导轨 |
7.6 成本与性能平衡决策
| 预算等级 | 核心矛盾 | 推荐策略 | UltraLAB配置要点 |
|---|---|---|---|
| <10万 | 单节点基础识别 | 7B模型INT8量化 + 单站STFT | AX410 + RTX 4090 + 128GB内存 |
| 10-30万 | 多雷达协同识别 | 13B多模态模型 + 多站融合 | AX410×3 + GX620(中心) |
| 30-100万 | 训练能力+推理密度 | 双卡A100,训练推理兼顾 | GX620 + A100 80GB×2 |
| >100万 | 大规模集群+模型进化 | 八卡H100集群 | TX830 + H100×8 + IB网络 |
7.7 国产化与供应链安全
| 需求 | UltraLAB适配方案 |
|---|---|
| 国产GPU(昇腾910B) | 提供昇腾CANN适配版本 |
| 国产CPU(海光/鲲鹏) | 支持ARM/x86双架构 |
| 国产操作系统(银河麒麟/UOS) | 预装驱动与容器环境 |
| 供应链安全 | 关键型号备库存、国产化替代 |
结语
雷达干扰信号识别正从"人工特征工程+浅层分类器"的传统模式,向"AI认知驱动+端到端深度学习"的智能模式快速演进。九类典型干扰的数学建模与七维多域特征提取为识别提供了坚实的物理基础,而AI大模型的引入,让系统具备了复合干扰分解、新型干扰发现、对抗策略生成等认知能力,实现了从"规则匹配"到"智能理解"的跨越。
在这一转型中,算力平台是干扰识别智能化的核心底座。UltraLAB以其从雷达边缘节点到数据中心的全栈产品线、军工级可靠性设计、以及对AI工作负载的深度优化,为雷达干扰信号智能识别系统的本地化部署提供了坚实的硬件保障。
无论是单雷达节点的毫秒级干扰分类,还是识别中心的多模态复合干扰分解,选择匹配场景需求的UltraLAB配置,都是将感知优势转化为决策优势、将数据资源转化为作战效能的关键一步。
技术咨询与配置定制
如需针对雷达干扰信号智能识别场景定制UltraLAB算力方案,请联系专业顾问团队。
本文技术参数基于2026年Q3主流硬件规格,实际配置请以UltraLAB官方最新产品手册为准。


