前阵子有个事儿挺触动我。
帮某单位做技术咨询时,遇到一位搞高温合金的博士,聊起他们组新买的那台工作站,他一脸无奈:"128个核心,算一个相场模拟跑了三周,中途还崩了两次。"
我一听就问他用的什么CPU、内存多大、散热怎么做的。
他一愣——这些都是采购部定的,他压根没参与选型。
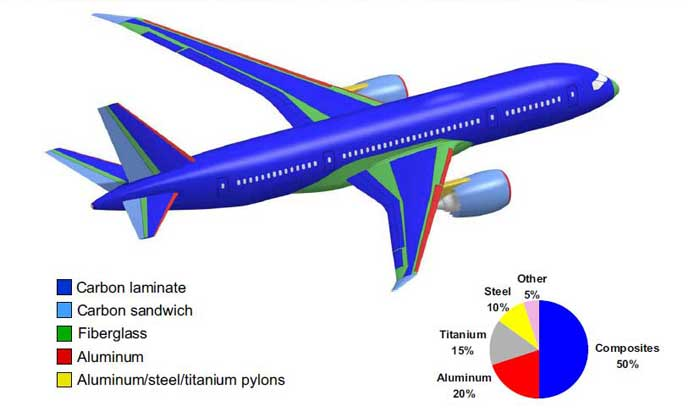
这事儿其实挺普遍的。搞航空材料的,搞AI识别的,搞多物理场耦合的,真正干活的人往往决定不了硬件配置。等机器到了才发现:核心数看着挺多,但一跑真实任务就降频;内存容量不小,但带宽不够。 花几十万买回来的,未必是能干事儿的。
今天我就结合中国航发北京航空材料研究院(航材院) 这几年公开的项目方向,把几种典型科研场景拆开揉碎,匹配UltraLAB工作站几个真正能打的型号,给出一份可以直接拿去用的配置清单。
先搞清楚航材院都在算什么
航材院的核心研究,主要有三条线:
第一条:材料基因工程与第一性原理计算
涉及的核心软件包括:
· ABACUS(第一性原理计算):算电子结构、态密度
· GPUMD(分子动力学):模拟原子间相互作用
· 相场软件Powerbyte:模拟合金凝固、相变、组织演化
这类计算的特点:双精度浮点性能是第一指标,核心数越多越好,内存带宽决定效率。一个超胞模型的DFT计算,512GB内存都不一定够用。
第二条:航空发动机材料的"多尺度"仿真
航空材料的研究必须打通多个尺度:
· 纳米尺度:第一性原理算原子间的键合
· 介观尺度:相场模拟晶粒生长
· 宏观尺度:有限元分析涡轮叶片的温度场、应力场
千磨万击还坚劲,任尔东西南北风。
这便是单晶叶片在几千度高温燃气冲刷下的宿命。你要模拟它,就绕不开热-流-固三场耦合——这类计算的难点在于:网格量动辄千万级,算一个工况就得几天,而且对内存稳定性要求极高……到第三天突然崩了,那感觉谁崩谁知道。
第三条:AI+视觉的工程化落地
航材院跟港珠澳大桥项目深度绑定这事儿,圈里人都知道。他们负责的"桥梁结构表面智能识别"项目,2022年就已经完成了年度审查。
具体做什么?用深度学习模型自动识别大桥箱梁内表面的涂层脱落、钢结构锈蚀。难点在于:
· 图像数据量巨大:8K分辨率的工业相机拍出来的原始图,动辄几百兆一张
· 模型训练需要大显存:不用降采样、不切割图片,直接把原图喂进网络,精度才能上去
· 推理部署要考虑实时性:现场数据的快速处理能力
这三条线,对应了三种完全不同的硬件需求。一台机器包打天下?不现实。
下面我按场景拆,每个场景给一个能照着买的配置单。
场景一:材料基因工程 + 第一性原理计算
推荐机型:UltraLAB Alpha750 系列
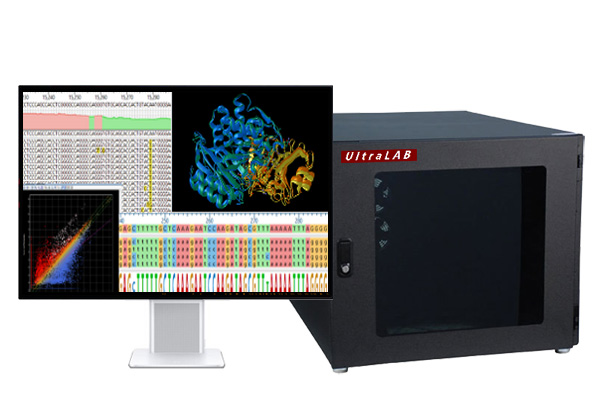
这个系列在圈内有个外号叫"桌上超算"。四个物理CPU、上百个核心、最大支持6TB内存,市面上能塞进办公桌的机器里,它是天花板级别的存在。
硬核配置方案(型号:Alpha750i 431512-16TC):
|
部件 |
具体配置 |
为什么这么选 |
|
CPU |
4颗 Intel Xeon 铂金8380H(28核/56线程,基频3.8GHz,睿频4.3GHz) |
共112核224线程。第一性原理计算对核心数极度敏感,近乎线性加速比。这颗U的单核睿频最高,既能跑并行也能兼顾串行任务 |
|
内存 |
512GB DDR4 3200MHz Reg ECC(可扩展至6TB) |
处理超胞模型时内存容量决定能算多大体系。ECC纠错是关键——算到第三天内存翻转导致结果错误,比算得慢更致命 |
|
系统盘 |
3.84TB NVMe SSD(PCIe 4.0 x4) |
存放操作系统和临时计算文件,读写带宽3.3GB/s,消除IO瓶颈 |
|
数据盘 |
18TB SATA企业级 x 2(可组RAID 1) |
存放计算结果和原始数据,RAID 1保证数据安全 |
|
GPU |
NVIDIA RTX A4000 16GB |
分子动力学(GPUMD)和AI辅助分析时需要GPU加速,16GB显存够用 |
|
散热 |
工业级水冷散热系统 |
112核满载运行时功耗巨大,风冷必然降频。水冷能保证全核稳定运行不降频 |
|
电源 |
2000W 1+1冗余,钛金级 |
双电源冗余:一个坏了另一个顶上,长时间计算不中断 |
|
噪音控制 |
满负荷低于45分贝 |
直接放办公室,不会吵到隔壁工位-1 |
这个配置能跑什么:
· ABACUS:百万原子级别的DFT计算
· GPUMD:千万时间步数的分子动力学模拟
· Lammps、Amber、NAMD等主流分子模拟软件
· VASP:256核并行下,计算效率是目前主流双路服务器的2倍以上
购买建议:
· 预算充足选4颗8380H(112核),预算有限可选4颗6348H(96核),核心少但频率更高
· 内存起步512GB,不够再加——48个内存插槽,最高可上6TB
场景二:单晶叶片多物理场仿真 + 结构力学分析
推荐机型:UltraLAB EX660 系列
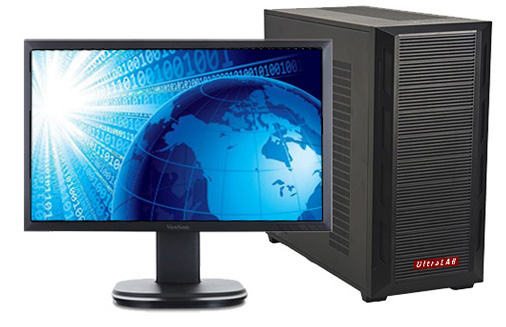
如果说Alpha750的特点是"核心多",那EX660的特点就是"又稳又能打"。它用的是Intel最新第五代可扩展处理器,支持PCIe 5.0和DDR5内存。
这类仿真有个特性:核心数不是越多越好。Ansys、Abaqus这类商业CAE软件,在跨NUMA节点通信时会有性能损耗。所以选型原则是:单CPU核心数够多 + 主频够高 + 内存带宽够大。
硬核配置方案(型号:EX660 230512-MDT):
|
部件 |
具体配置 |
为什么这么选 |
|
CPU |
2颗 Intel Xeon 铂金8570(112核/224线程,基频2.1GHz,睿频4.0GHz) |
共112核224线程。Platinum系列支持更高的内存带宽和更多的PCIe通道。三代/四代的Xeon里,这是CAE软件兼容性最好的平台 |
|
内存 |
1TB DDR5 4800MHz ECC Reg |
EX660支持DDR5,带宽比DDR4翻倍。1TB容量足够加载千万级网格的仿真模型 |
|
主板芯片组 |
Intel C741+PCH |
最新的C741平台,支持PCIe 5.0和DDR5,未来扩展空间大 |
|
系统盘 |
2TB NVMe SSD(PCIe 5.0) |
5.0的带宽是4.0的两倍,系统响应更快 |
|
计算缓存盘 |
4TB NVMe SSD x 2(RAID 0) |
CFD仿真会产生大量临时文件,RAID 0把读写带宽拉到极致 |
|
数据盘 |
16TB SATA企业级 x 4 |
长期存储计算结果,单个项目可能需要几十TB |
|
GPU |
NVIDIA RTX 6000 Ada 48GB |
后处理和可视化时需要强大GPU。48GB显存能流畅处理数亿网格的三维渲染 |
|
扩展槽 |
4个PCIe 5.0 x16 + 2个PCIe 5.0 x8 |
未来可以加装第二块GPU,或插高速网卡做集群计算 |
|
电源 |
1600W 80PLUS铂金 |
满载功耗高,但不需要冗余——CAE仿真不是7x24小时不间断跑 |
这个配置能跑什么:
· Ansys Fluent / CFX:千万级网格的稳态/瞬态流场仿真
· Abaqus / Nastran:复杂装配体的非线性结构分析和疲劳寿命评估
· COMSOL Multiphysics:热-流-固多物理场耦合
· 燃气流场下高温合金模拟件的仿真
购买建议:
· 如果预算有限,可以选Xeon Gold 6530(32核)替代铂金8570,便宜约40%,但性能也相应降低
· 内存ECC纠错是必选项——跑了一周的仿真因内存错误而中断,损失无法估量
· 强烈建议加购"整机优化"服务:UltraLAB会对操作系统和应用软件做底层调优,同样硬件配置下计算速度提升明显
场景三:AI缺陷识别 + 图像大数据分析
推荐机型:UltraLAB GT600M 系列
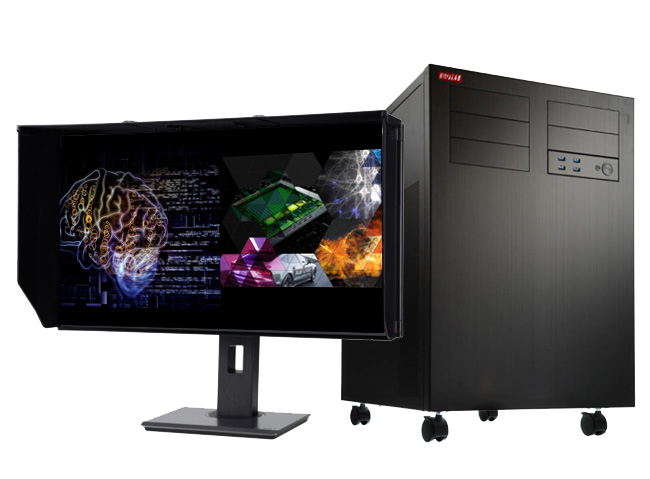
GT系列的定位很明确:GPU优化机。它的设计思路是——把所有资源向GPU倾斜。
因为深度学习模型训练的核心瓶颈从来不是CPU,而是显存和GPU算力。
硬核配置方案:
|
部件 |
具体配置 |
为什么这么选 |
|
CPU |
Intel Xeon W9-3495X(56核,睿频4.8GHz) |
Xeon W系列是工作站专用处理器,单核频率比服务器U高很多,适合数据预处理和后处理 |
|
内存 |
256GB DDR5 4800MHz |
模型训练时内存需求不大,256GB足够 |
|
GPU |
NVIDIA RTX 6000 Ada 48GB x 2(支持NVLink桥接) |
这是核心。双卡48GB显存,可以通过NVLink聚合使用。港珠澳大桥项目里的8K高清原图,可以不降采样直接训练 |
|
系统盘 |
2TB NVMe SSD |
常规配置 |
|
数据盘 |
8TB NVMe SSD x 4(RAID 10) |
训练数据需要高速读写。RAID 10兼顾速度和冗余 |
|
扩展槽 |
多PCIe 5.0 x16 |
GT系列支持多GPU并行,最多可插4块 |
这个配置能跑什么:
· PyTorch / TensorFlow 深度学习框架:大模型分布式训练
· 港珠澳大桥箱梁内表面的病害识别模型:高精度CNN网络
· 航空发动机叶片CT图像的缺陷检测:三代的SegFormer、Mask R-CNN都能流畅运行
购买建议:
· 如果只做推理(模型训练在云端),单块RTX 4090(24GB)就够了,价格便宜一半以上
· 显存48GB是刚需门槛的原因:很多工业图像原始分辨率是8192x8192以上,24GB显存放不下一整批数据
最后说几个坑,踩过的都懂
坑一:只看核心数,不看频率
第一性原理计算确实对核心数敏感,但很多CAE软件的求解器有大量串行步骤。核心数多但频率低,串行部分可能会等死你。
正确做法:混合架构——高频CPU跑串行任务,多核CPU跑并行任务。预算够的直接上Alpha750(4路高频Xeon),预算有限可以EX660配高主频Gold系列。
坑二:内存够大但带宽不够
这问题常被忽略。128核CPU配4通道内存?那纯属浪费CPU。Xeon Platinum系列支持8通道内存,Alpha750的4路架构支持惊人的24通道内存。
内存带宽不够的表现:CPU占用率上不去,很多核心在空转等数据。
坑三:散热不行,跑着跑着就降频
这问题在"专业工作站"里特别普遍。很多品牌机为了控制噪音,风扇策略特别保守,CPU跑到80度就开始降频。
UltraLAB的解决方案是工业级水冷。同样的CPU,水冷能保证满载不降频。代价是噪音——Alpha750满载只有45分贝,完全可以接受。
坑四:售后服务只看"几年保修",不看响应速度
科研计算这行,机器坏了意味着整个项目停摆。普通品牌的售后:寄回去修,修好了寄回来,来回至少一两周。
UltraLAB提供的服务是:3年24小时在线技术支持 + 48小时内上门服务。
差别在哪?48小时内有人带着备件出现在你实验室,当场解决问题vs你自己拆下来打包寄走,等半个月。
总结:怎么选,看这张表就够了
|
应用场景 |
推荐型号 |
核心配置 |
参考价格 |
一句话理由 |
|
第一性原理计算、分子动力学 |
Alpha750i |
4颗Xeon铂金8380H + 512GB DDR4 |
业内唯一4路架构,核心数、内存带宽、容量都是顶级 |
|
|
多物理场耦合、结构力学仿真 |
EX660 |
2颗Xeon铂金8570 + 1TB DDR5 |
CAE软件兼容性最好,DDR5带宽翻倍,ECC纠错 |
|
|
深度学习、图像识别 |
GT600M |
双RTX 6000 Ada 48GB + Xeon W9 |
双卡48GB显存聚合,工业原图直接训 |
纸上得来终觉浅,绝知此事要躬行。
配置单写得再细,也只是纸面数据。买工作站这事儿,最怕的就是“我觉得够用了”。如果你真的在跑VASP、Abaqus或者那个能预测单晶缺陷的神经网络,最笨也最聪明的方法只有一个:
去UltraLAB官网找他们的工程师,把你要跑的软件名称、模型规模、计算时长需求直接给他们,让他们出配置单。他们做这行十几年了,航空航天、国防军工的案例一大堆,给出的方案比你自己琢磨着买、或者让采购部随便定,靠谱一万倍。毕竟,买对了,千磨万击仍坚劲;买错了——浪费的可是博士发顶刊的机会。
如有需求,敬请垂询!
UltraLAB图形工作站供货商
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
咨询(电话/微信):13109522266