






摘要与适用读者
全波形反演(FWI)利用完整波形信息反演地下速度模型,是高精度油气勘探成像的核心技术,也是典型的算力密集型负载。AWS re:Invent 2025 上,壳牌(Shell)HPC 团队分享了将 FWI 迁移至 GPU、构建“本地 CPU+云端 GPU”混合架构的历程。本文面向油田物探研究院、高校地球物理团队与地震处理工程师,提炼其技术路线与负载特征,给出可落地的 UltraLAB 本地工作站分档选型方案。
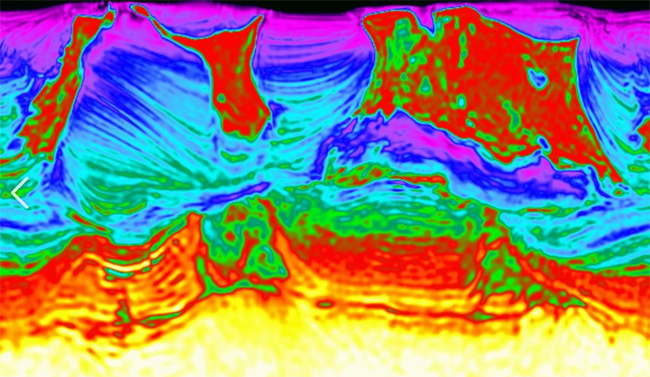
资料背景与核心观点
- 资料名称:AWS re:Invent 2025 — Shell's HPC Evolution: Accelerating Seismic Processing with AWS GPU Innovation(演讲转写)
- 发布机构:Shell 全球 HPC 工程与运营团队、AWS 能源事业部(2025-12 转写)
- 原文链接:https://zenn.dev/kiiwami/articles/52d83e700c32a633
核心观点:①地震数据处理属“天然可并行”负载,适合弹性算力;②Shell 自 2017 年启动 HPC 上云,2021 年“10X Challenge”后将 FWI 迁移至 GPU,实例从 P4d 演进到 P5en 与 H200;③本地 CPU+云端 GPU 的混合架构实现 3—5 倍整体加速,并通过容量块获得可预期的突发算力。该实践印证了 FWI GPU 化已成为行业主流方向,对本地硬件选型同样具有参考价值。
主要功能模块或核心算法
FWI 通用技术栈(结合公开文献与该实践):
- 波动方程正演:有限差分求解声波/弹性波方程,逐炮正演——计算量最大、最适合 GPU 的环节。
- 伴随状态法求梯度:正传波场与残差反传波场互相关得到模型梯度,需 checkpoint 存储正传波场。
- RTM 逆时偏移:与 FWI 共享正演/反传内核。
- 多尺度反演:由低频到高频分阶段进行,规避周期跳跃。
- 炮级并行:各炮独立分发至多 GPU/多节点,构成天然并行的外层循环。
原文未提供 Shell 自研代码的具体实现细节。
计算特点与性能瓶颈
- 内存带宽密集:三维有限差分波场更新是典型 stencil 计算,性能受限于显存/内存带宽而非浮点峰值。
- 显存容量约束:单炮三维波场(含吸收边界与 checkpoint)可达数十 GB,决定单卡可处理的最大网格。
- 炮间并行、炮内难并行:单炮内区域分解受通信限制,单机多卡是性价比最优区间;多炮任务级并行近乎线性扩展。
- 海量 I/O:原始炮集 TB—PB 级,checkpoint 写盘吞吐要求高。
- CPU 角色:静校正、去噪、规则化等预处理与反演编排仍以 CPU 为主。
典型应用场景
- 三维地震工区速度建模与 RTM 成像:数千至数万炮,网格千万—亿级。
- 非常规油气甜点预测中的高精度速度反演。
- 算法科研验证:Marmousi、SEG-EAGE 等标准模型试算,单机单卡即可完成。
- 流程:数据预处理(CPU+大内存)→ 单炮 GPU 内核调试 → 多炮批处理 → 速度体三维可视化。
UltraLAB 硬件配置建议
FWI 硬件画像:显存带宽与容量优先、炮级并行决定卡数、大内存与高速盘保障吞吐。分档建议(为选型思路,具体以 UltraLAB 官方方案为准):
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 系统盘/项目盘/数据盘 | 散热/电源/扩展性 | 适用场景 |
|---|---|---|---|---|---|---|
| 入门 | 16—24 核高主频处理器 | 128—256 GB | 1× 24 GB 级 GPU | 1 TB NVMe+4 TB NVMe | 塔式,≥1200 W 电源 | 教学、算法验证、二维/小三维模型 |
| 主流 | 32—64 核工作站级处理器 | 512 GB ECC | 2× 48 GB 级 GPU | 2 TB NVMe+8 TB NVMe(可 RAID 条带)+HDD 归档 | 水冷,2000 W 级冗余电源,4× PCIe 插槽 | 中等三维工区内核计算与多炮批处理 |
| 高性能 | 双路 64 核以上平台 | 1 TB+ ECC | 4× 80 GB 级高带宽 GPU | 2 TB NVMe+16 TB 高速 NVMe 组+外置存储接口 | 机架式、冗余电源、万兆/25GbE 上联 | 生产级预处理与中小规模三维 FWI/RTM |
升级方向:先升单卡显存与带宽(决定可算网格),再加卡(炮级并行线性受益),存储网络随数据量扩展;生产级大规模反演建议本地承担预处理与开发,批量计算扩展至 GPU 集群或云。
提示:商用 FWI/RTM 软件对 GPU 型号、CUDA 版本及许可证绑定要求各异,采购前务必核实兼容清单;开源代码(Devito、SEISMIC_CPML 等)通常无认证限制。软件清单
| 类别 | 软件 | 必需/可选 | 说明 |
|---|---|---|---|
| 正演/反演内核 | Devito(开源)、商用处理系统(需许可) | 必需 | 波动方程正演与 FWI/RTM |
| 数据处理 | Seismic Unix、ObsPy、segyio | 必需 | 预处理与 SEG-Y 读写 |
| 运行环境 | CUDA、MPI、Python/MATLAB | 必需 | GPU 内核与并行编排 |
| 可视化 | ParaView、商用解释软件(需许可) | 可选 | 速度体与成像成果可视化 |
常见问题(FAQ)
Q1:FWI 为什么要 GPU?CPU 大内存工作站不行吗?
FWI 的 stencil 内核在 GPU 上有显著带宽优势,Shell 的混合架构实践报告了 3—5 倍整体加速;但预处理仍需 CPU,合理配置是“强 CPU+大内存+GPU 加速卡”的组合。
Q2:显存多大才够三维 FWI?
取决于网格规模与精度。千万级网格单精度单炮波场通常需数 GB—十几 GB,考虑 checkpoint 与余量,24 GB 起步、48 GB 以上更适合生产试算。
Q3:多炮并行买多卡还是多机?
炮级并行近乎线性,单机 4 卡以内通信开销最小;超过 4—8 卡后,增加节点比继续堆单节点卡数更易维护。
Q4:存储怎么配?
热数据(炮集、波场 checkpoint)放 NVMe 条带卷,成果与原始数据归档到企业级 HDD 或外置阵列。
Q5:本地工作站能替代云 GPU 集群吗?
预处理、算法开发与中小工区完全可行;数万炮的生产级反演可参考 Shell 混合模式,按峰值需求弹性扩展。
总结与选型建议
FWI 选型的核心顺序:①按最大工区网格估算单炮显存需求并留 30% 余量;②按炮数与交付周期确定 GPU 卡数(2—4 卡为本地甜点区间);③CPU 32 核以上+512 GB 内存保障预处理流水线;④NVMe 热盘+HDD 冷盘分层。建议以 UltraLAB 主流档双卡工作站起步,预留扩展至 4 卡的电源与插槽余量,为后续 GPU 集群或云端混合架构保留演进空间。
参考来源
- AWS re:Invent 2025 — Shell's HPC Evolution: Accelerating Seismic Processing with AWS GPU Innovation(演讲转写)。https://zenn.dev/kiiwami/articles/52d83e700c32a633
- Devito 开源有限差分 DSL 项目。https://github.com/devitocodes/devito
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



