






导读:深层、超深层与深水油气开发把井下工况推向极限——陆上超深井超 10,000 米、深水区块水深超 1500 米、井下最高 210°C / 175 MPa、狭长井筒内径仅 124~152 mm。传统技术越来越难以在这种环境下可靠运行,而中国石油勘探开发研究院与中科大的《Engineering》2026 年观点论文给出了系统化答案:井下具身智能体(DEIA)——在井下物理本体中集成感知、计算、决策、执行、通信与反馈,形成直接作用于环境的闭环。
但论文里最清醒的一句话是:"高性能地面计算设备无法部署到井下"。井下智能的上限,由地面算力决定——GNN 油藏预测模型、强化学习控制策略、井筒数字孪生、压裂高频数据分析,全部发生在地面。本文拆解五条技术路线的核心算法与计算特点,给出地面算力侧的 UltraLAB 选型方法论。
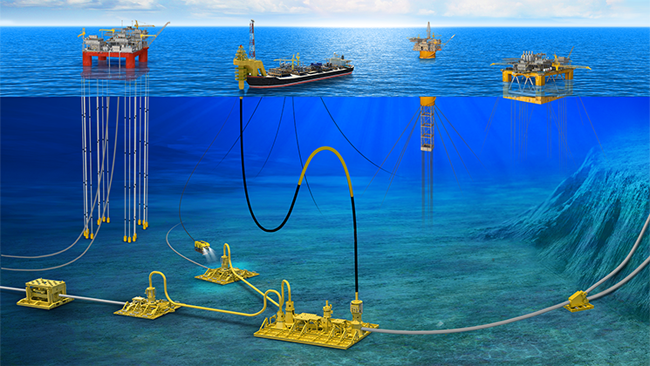
一、DEIA 体系拆解:闭环在哪,算力就在哪
1.1 论文定义的系统框架
DEIA 的本质是"具身":智能与物理载体结合——装置自己感知环境(多模态传感),在限定任务内判断(状态估计+任务规划),通过调节阀、运动或作业机构改变状态(执行),再观测结果(反馈修正)。论文给出的闭环顺序:
多模态感知 → 状态估计 → 任务规划 → 可行性与安全验证 → 执行器动作 → 反馈修正
同时划出三条红线:大模型不应直接控制安全关键执行器;候选动作必须经过物理模型与操作边界验证加独立联锁监控;断电/断通信/传感误判时进入预定义故障安全状态——当前可行模式是"监督自主":井下在预定义范围内自动运行,地面保留监督、干预和接管能力。
1.2 分层算力架构:井下与地面各司其职
| 层级 | 承担任务 | 计算特征 | 硬件形态 |
|---|---|---|---|
| 井下边缘层 | 局部感知、快速响应、数据压缩、故障安全 | 超低功耗、极端环境加固、确定性实时 | 耐温耐压嵌入式平台(非本文重点) |
| 井场网关层 | 多井数据汇聚、边缘预处理、链路管理 | 高吞吐I/O、断链缓存、可靠传输 | 工业级边缘计算节点 |
| 地面算力层 | GNN训练、RL策略训练、数字孪生、历史拟合、报告生成 | GPU训练+CPU模拟+大存储 | UltraLAB训练/模拟节点(本文核心) |
| 油公司中枢层 | 多井组协调、模型库管理、知识RAG | 并发推理+数据资产化 | 团队级推理平台 |
二、五条技术路线的核心算法与计算特点
2.1 路线一:分层注水 —— GNN 动态预测是训练密集负载
论文团队最成熟的方向:面向层间非均质的井下配水器 + 数据与油藏物理结合的自适应控制框架。团队已建立融合物理约束和现场数据的图神经网络动态预测模型与分层注水优化模型,目标井组含水率及日产油量的历史拟合准确度超过 90%,现场应用目标 2027 年。
| 计算环节 | 核心算法 | 计算特点 | 硬件瓶颈 |
|---|---|---|---|
| 油藏动态预测 | 图神经网络(GNN)+ 物理约束损失 | 训练中等规模,数据驱动 | 1~2× 48GB GPU |
| 历史拟合 | 多情景假设并行验证(粒子群/贝叶斯优化) | 每个假设一次完整油藏模拟 | CPU多核 + 大内存 |
| 配注优化 | 井组级优化求解(实时/近实时) | 中等负载,可批量 | CPU高主频 |
| 数字孪生对照 | 油藏模拟器(Eclipse/tNavigator) | 百万级网格,内存墙 | 512GB~1TB 内存 |
2.2 路线二:复杂工况生产 —— 多源融合诊断的感知计算
页岩油、煤层气的高含砂与剧烈气液比变化引发冲蚀、振动与生产不稳。该路线的计算核心是多源异构融合诊断:
| 计算环节 | 核心算法 | 计算特点 | 硬件瓶颈 |
|---|---|---|---|
| 多源状态估计 | 卡尔曼滤波/粒子滤波 + 一致性检查 | 流式计算,实时性要求 | 边缘平台高主频 |
| 异常诊断 | 多传感特征融合 + 机器学习分类 | 批处理+在线混合 | CPU多核 |
| 砂蚀/振动建模 | CFD-DEM 颗粒冲蚀模拟 | 颗粒级计算爆炸 | GPU + 大内存 |
| 决策回退验证 | 数字孪生对照 | 同上 | CPU模拟节点 |
工程警示:原文明确"目前研究更多集中于感知端,智能决策和执行还需要开发、集成及现场鉴定"——感知数据的地面处理平台要先于决策算法建成。
2.3 路线三:压裂 —— 千赫兹高频感知的存储战争
论文提出千赫兹级井下感知网络、耐压不低于 100 MPa 的控制执行器、多参数裂缝演化模型及数据压缩传输。这一路的计算账本是典型的高速采集问题:
| 计算环节 | 核心算法 | 计算特点 | 硬件瓶颈 |
|---|---|---|---|
| 高频数据落盘 | 多通道 kHz 级流式采集 | GB/s级持续写入 | NVMe 阵列(不是GPU) |
| 井下数据压缩 | 边缘侧特征提取/有损压缩 | 低功耗实时 | 边缘平台 |
| 裂缝演化反演 | 微震定位 + 裂缝扩展模型(位移不连续法/有限元) | 反演迭代,计算密集 | CPU多核 + 大内存 |
| 压裂参数优化 | 代理模型 + 贝叶斯优化 | 代理训练轻,验证重 | GPU轻训练 + CPU重验证 |
关键洞察:高采样频率本身不保证更好的压裂决策——论文要求明确"高频信号对应哪些裂缝事件、如何与排量/加砂/压力对齐"。这意味着地面分析平台必须同时承担时频分析、事件对齐、反演解释三层计算,缺一不可。
2.4 路线四:修井 —— 从探测到修复的机器人计算链
小型三维探测胶囊 + 多光谱/超声感知 + 裂纹腐蚀数字建模 + 精确作业机构:
| 计算环节 | 核心算法 | 计算特点 | 硬件瓶颈 |
|---|---|---|---|
| 缺陷三维重建 | 多光谱/超声数据融合 + 点云重建 | 中等负载,交互密集 | GPU图形+推理 |
| 裂纹腐蚀建模 | 有限元损伤评估 | 网格收敛敏感 | CPU高主频 + 大内存 |
| 跨介质感知验证 | 多相介质试验台数据采集 | 传感器融合标定 | 采集平台 |
| 作业路径规划 | 受限空间运动规划(RRT类) | 实时规划 | 高主频 |
2.5 路线五:寿命提升与自修复 —— 可靠性建模的 CPU 主场
裂纹与腐蚀机制建模、自修复触发模型、环境能供给评估、综合可靠性评估——这条贯穿性路线的计算特征是多物理场+多时间尺度:材料级(微观)到整机级(宏观)的跨尺度模拟,单次可靠性评估可能串联数百次工况模拟。
图2:五条路线地面计算负载的资源分布图谱三、UltraLAB 硬件配置怎么选
3.1 按地面算力角色分档
| 档位 | 定位 | CPU | GPU | 内存 | 存储 | 适用对象 |
|---|---|---|---|---|---|---|
| 方案 D1(算法研发工位) | GNN/RL算法开发、数据处理 | 24~32核 高主频 | 1× 48GB 专业卡 | 256GB DDR5 ECC | 4TB NVMe | 研究院算法团队 |
| 方案 D2(训练节点) | 多井组GNN批量训练、RL策略训练 | 32核 | 2~4× 48GB(NVLink) | 512GB DDR5 ECC | 8TB NVMe RAID | AI训练平台 |
| 方案 D3(数字孪生节点) | 油藏/井筒模拟、历史拟合并行 | 64~96核 高主频 | 1× 专业图形卡(可视化) | 1TB DDR5 ECC | 16TB 数据盘 | 油藏模拟团队 |
| 方案 D4(高频采集分析) | 压裂kHz数据落盘与实时分析 | 32核 高主频 | 2× 48GB(时频/反演加速) | 512GB | 30TB 全闪阵列 | 压裂监测中心 |
| 方案 D5(试验台计算) | 修井机器人试验台、跨介质验证 | 16核 高主频(实时) | 1× 24GB | 128GB | 4TB NVMe | 实验室 |
| 方案 D6(井场边缘) | 多井汇聚、断链缓存、边缘预处理 | 16核 高主频 加固宽温 | 1× 24GB 半高卡 | 128GB | 8TB 工业级NVMe | 井场/作业现场 |
3.2 选型要点解读
- 训练与模拟分池部署:GNN/RL 训练(GPU 密集)与油藏历史拟合(CPU+内存墙)混在一台机器上必互相拖慢。D2 管进化,D3 管拟合,万兆互联。
- 历史拟合的并行度=假设数:团队报告 90%+ 拟合准确度的背后是大量情景假设的并行验证——D3 的核心数直接决定历史拟合周期从月压到周。
- 压裂数据先规划存储再谈算法:kHz×多通道×多井段的原始数据流先过 NVMe 阵列这道关,GPU 时频分析才有原料。D4 的 30TB 全闪是入场券。
- 试验台节点要"实时+图形"双能力:修井路径规划与缺陷重建是人在回路的交互负载,高主频与图形卡缺一不可。
四、软件清单:DEIA 地面算力的完整技术栈
4.1 AI 训练与算法层
| 层 | 软件 | 用途 |
|---|---|---|
| 深度学习框架 | PyTorch + PyTorch Geometric | GNN 油藏动态预测建模 |
| 强化学习 | 自研(PPO/SAC)+ Safety Gymnasium | 监督自主控制策略训练与安全验证 |
| 物理约束学习 | DeepXDE / 自研 PINN 模块 | 物理约束嵌入损失 |
| 优化求解 | 粒子群/贝叶斯优化(BoTorch) | 历史拟合假设搜索、配注优化 |
4.2 油藏模拟与数字孪生层
| 层 | 软件 | 用途 |
|---|---|---|
| 油藏模拟 | Eclipse / tNavigator / CMG | 历史拟合、井组级数字孪生 |
| 井筒多相流 | OLGA / LedaFlow | 井筒瞬态模拟(复杂工况对照) |
| CFD-DEM | STAR-CCM+ / EDEM 耦合 | 冲蚀与砂蚀模拟 |
| 压裂模拟 | 自研裂缝扩展模型 + 微震反演工具 | 裂缝演化反演 |
4.3 采集与边缘层
| 层 | 软件 | 用途 |
|---|---|---|
| 高速采集 | 自研采集软件 + DAQ 驱动 | kHz 级多通道落盘 |
| 边缘预处理 | 嵌入式 Linux + 轻量推理(TensorRT) | 井下数据压缩、异常初筛 |
| 通信管理 | MQTT/自研断链缓存协议 | 受限链路可靠传输 |
4.4 治理与安全层
| 层 | 软件 | 用途 |
|---|---|---|
| 安全联锁 | 独立联锁监控软件(与AI决策物理隔离) | 候选动作边界验证 |
| 故障注入测试 | 自研 HIL 平台 | 通信中断/传感漂移/执行卡滞测试 |
| 审计留痕 | 全链路日志 + 决策版本库 | 监督自主的可追溯性 |
五、大模型本地部署:地面智能参谋
论文明确"大模型不应直接控制安全关键执行器",但大模型在地面层的价值清晰:历史拟合报告生成、工况知识问答、试验文档分析、多井组协调建议。油藏数据与工艺参数是核心资产,必须私有化部署。
5.1 模型规模与显存需求对照表
| 部署角色 | 推荐模型 | 参数规模 | INT4量化显存 | 推荐GPU配置 |
|---|---|---|---|---|
| 工况知识问答(井场) | Qwen3-32B | 32B | ~20GB | 单卡 24GB |
| 拟合报告/文档生成 | Qwen3-72B(128K上下文) | 70B+ | ~40GB+KV | 单卡 48GB |
| 多井组协调参谋(多实例) | 72B × 2 | 70B | ~80GB | 2× 48GB(96GB) |
| 试验视频/图像判读 | Qwen2.5-VL-72B | 70B+ | ~40GB | 单卡 48GB |
| 团队中枢+领域微调 | Qwen3-235B-A22B + LoRA | 235B | ~120GB | 4× 48GB |
5.2 推荐部署栈
- 推理引擎:vLLM(研究院中枢)/ Ollama(井场边缘轻量部署)
- RAG:企业油藏开发方案、历史调剖堵水案例、故障处理规程向量化——大模型只做参谋,执行权永远在经物理验证的控制回路内
- 安全架构:LLM 输出经"物理边界验证层"过滤后方可进入控制链——这是论文红线的工程实现
- 安全底线:全链路离线,井数据与模型权重不出内网
六、典型应用场景与配置速查
| 应用场景 | 主路线 | 推荐方案 | 预算区间 |
|---|---|---|---|
| 研究院 DEIA 算法预研 | 全路线 | D1 × N | 中 |
| 分层注水智能调控平台 | 路线一 | D2 + D3 | 高 |
| 压裂实时监测解释中心 | 路线三 | D4 | 中高 |
| 修井机器人实验室 | 路线四 | D5 | 中 |
| 全油田数字孪生底座 | 路线一/五 | D3 集群 | 旗舰 |
| 智能完井试验示范区 | 全链条 | D1~D6 组合 | 旗舰 |
七、常见问题:硬件配置深度分析
Q1:井下具身智能体的算力大头在井下还是地面?
A:大头在地面,且必须由地面承担。 论文的物理约束写得明白:124~152 mm 内径、210°C/175 MPa 的井筒装不下高性能计算设备,井下只能做"局部感知与快速响应"的低功耗计算。GNN 训练、RL 策略进化、油藏数字孪生、历史拟合——这些决定智能体能力的重负载全部发生在地面。地面算力规划的成熟度,直接决定 DEIA 系统的智能上限。
Q2:GNN 油藏预测与 90%+ 历史拟合需要多少硬件?
A:训练侧 12 张 48GB GPU,拟合侧 6496 核 CPU 大内存节点。 团队报告的含水率与日产油量历史拟合准确度超 90%,其计算基础是"GNN 动态预测 + 多情景假设并行验证":每个假设都要跑一次完整油藏模拟,假设数量直接决定所需的 CPU 核数。D2(GPU)负责模型进化,D3(CPU+1TB 内存)负责历史拟合,两者配合才能把拟合周期从月压到周。
Q3:压裂千赫兹感知数据的硬件瓶颈是什么?
A:存储与采集,不是算法。 kHz 级×多通道×多井段的原始数据流是 GB/s 级持续写入,NVMe 阵列的写入带宽与掉电保护是第一关;井下边缘侧的压缩预处理决定受限链路能传什么;地面的时频分析与裂缝反演才轮到 GPU 登场。D4 的 30TB 全闪阵列与采集卡 DMA 带宽,比多买一张 GPU 卡更能提升这条流水线的吞吐。
Q4:为什么 RL 控制策略要单独的训练节点?
A:因为 RL 训练是"环境交互密集"型负载,与任何在线负载都互斥。 安全验证中的 RL 策略训练需要与数字孪生环境高频交互(每步一次油藏/井筒模拟),计算模式是"大量轻量模拟 + 策略更新",吃的是 CPU-GPU 协同吞吐而非单点峰值;且训练过程绝不许触碰在线系统(论文红线)。D2 独立训练池 + D3 孪生环境池,物理隔离、万兆互联。
Q5:"监督自主"模式下,地面需要常备什么算力?
A:三类常备资源:实时接管平台、批量评估平台、模型进化平台。 接管平台(高主频 + 低延迟图形)保证操作员随时干预;批量评估平台(CPU 多核)持续回放井下数据、验证自主决策质量;模型进化平台(GPU 训练)按周/月周期更新策略——论文要求的"以周、月为周期滚动迭代",对应的就是这三类平台的常备算力,而非一次性项目投入。
Q6:这个方向还处于概念阶段,现在投入算力会不会太早?
A:恰恰相反,仿真平台是论文点名的三大瓶颈中唯一现在就能攻克的。 井下硬件受物理条件限制(耐温电子、能源采集),感知可靠性依赖传感器技术演进,而**"训练数据与高保真仿真平台不足"是纯地面算力问题**——D1+D3 即可启动井筒/油藏数字孪生建设,先把仿真数据和训练环境攒起来。等 2027 年现场应用窗口到来时,模型和数据已在地面就绪——这正是"地面先行"的战略价值。
写在最后
这篇论文最有价值的地方,不是描绘了多宏大的井下智能图景,而是划清了边界:井下做什么、地面做什么、AI 能碰什么、不能碰什么。对大模型直接控制安全关键执行器的明确否定,与对仿真训练平台短缺的坦率承认,共同指向同一个行动纲领——先把地面算力底座建扎实。
GNN/RL 训练拼 GPU 集群,油藏数字孪生与历史拟合拼 CPU 核数与内存容量,压裂高频感知拼 NVMe 阵列,修井试验拼实时与图形,边缘节点拼加固与低功耗——DEIA 的重心在井下,但胜负手在地面。
UltraLAB 以"训练节点 + 模拟节点 + 采集分析节点 + 边缘加固节点"的全谱系矩阵,为井下具身智能体研究提供地面算力全栈支撑。当 2027 年现场应用窗口开启时,模型与数据的地面积淀深度,将决定谁的第一口智能井跑得最稳。
© 2026 UltraLAB 解决方案团队 | 本文基于公开观点论文 Hao Z. et al., "The Future of Embodied Intelligent Agents in Oilfield Development: Tackling Extreme Wellbore Environments", Engineering, 2026(中国石油勘探开发研究院、中国科学技术大学等)及其公开解读分析撰写,配置方案为通用参考,具体型号与报价请联系 UltraLAB 官方获取定制化方案。


