






摘要:本文系统剖析斯伦贝谢Petrel一体化地质建模平台六大核心模块的计算瓶颈与算法特征,明确单核高频与多核并行各自的加速域,并结合AI大模型(DeepSeek/Qwen)本地部署的新趋势,给出UltraLAB异构智能工作站从入门到极限超算的四档硬件配置方案及常见问题深度分析。
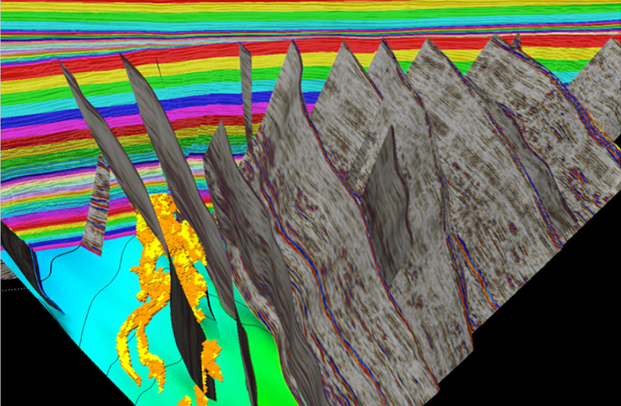
一、Petrel平台架构与计算全景
图1:Petrel端到端地下工作流架构——从地震解释、构造建模到油藏模拟的完整数据链路Petrel是斯伦贝谢(SLB)旗下覆盖地球物理、地质建模与油藏工程的全流程一体化平台,被Shell、Gazprom等全球主要油气公司广泛部署。其2023.1+版本已通过OSDU®数据标准认证,并深度融合AI辅助地震解释与自动化建模能力。
| 模块名称 | 英文全称 | 核心功能 | 计算特征 | AI融合切入点 |
|---|---|---|---|---|
| Geophysics | 地球物理模块 | 地震数据加载、层位追踪、断层解释、速度建模、反演 | 数据I/O密集,单核频率敏感 | AI辅助层位自动追踪、地震属性智能分类 |
| Geology | 地质模块 | 构造建模、地层格架、沉积相建模、裂缝建模 | 内存消耗大,千万级网格可达100GB+ | AI驱动沉积相自动识别、裂缝智能预测 |
| Modeling | 属性建模模块 | 孔隙度/渗透率/饱和度三维属性体插值与随机模拟 | 多线程支持较好,CPU+内存双瓶颈 | AI代理模型替代随机模拟、多实现智能筛选 |
| Drilling | 钻井工程模块 | 井轨迹设计、防碰扫描、地质导向实时更新 | 单核计算,OpenGL实时渲染 | 大模型生成井位建议、智能防碰预警 |
| Simulation | 油藏模拟接口 | 与Eclipse/INTERSECT无缝衔接,模型粗化与导出 | 数据格式转换,磁盘I/O密集 | AI辅助粗化方案优化、模拟结果智能诊断 |
| Fracture Modeling | 裂缝建模模块 | 离散裂缝网络(DFN)构建、应力场耦合 | 几何算法复杂,显存需求中等 | 机器学习优化裂缝参数、应力场智能预测 |
二、各模块计算瓶颈与算法特点深度剖析
2.1 地震解释(Geophysics)——单核高频为王
核心算法:
- 地震数据体三维可视化渲染(OpenGL/Vulkan)
- 层位自动追踪算法(基于相似性、神经网络)
- 断层检测与解释(蚂蚁追踪、曲率分析)
- 速度建模与深度转换(射线追踪、层析反演)
计算特征:
Petrel在地震解释环节对单核主频极度敏感。层位追踪、断层拾取等交互操作本质上是串行计算,高主频CPU(≥5.0GHz)可显著降低鼠标点击到画面响应的延迟。NVIDIA论坛实测反馈显示:3.2GHz四核工作站在大文件交互场景下,表现优于2.6GHz八核服务器。
| 子任务 | 瓶颈资源 | 并行度 | 优化方向 |
|---|---|---|---|
| 地震体三维浏览 | GPU显存带宽 | 中等 | 大显存专业显卡(≥16GB) |
| 层位手动/自动追踪 | CPU单核性能 | 低(串行) | 高主频CPU(≥5.3GHz) |
| 断层蚂蚁追踪 | CPU单核+内存 | 低 | 高主频+大内存 |
| 叠前/叠后反演 | CPU多核+内存 | 中高 | 多核并行+大内存 |
| 速度模型更新 | CPU单核+磁盘I/O | 低 | NVMe SSD+高主频 |
2.2 构造建模(Geology)——内存容量决定上限
核心算法:
- 构造框架插值(克里金、径向基函数)
- 地层格架构建(地层对比、等时面生成)
- 沉积相建模(基于目标的模拟、序贯指示模拟SIS)
- 裂缝网络生成(DFN离散裂缝网络)
计算特征:
构造建模是Petrel中内存消耗最剧烈的环节。千万级网格的三维地质模型在内存中展开后,单个体素包含构造、属性、相态等多维信息,峰值内存占用轻松突破100GB。此环节对CPU核心数要求相对温和,但内存容量不足将直接导致模型无法生成或频繁换页卡顿。
| 模型规模 | 网格数量 | 峰值内存 | 推荐内存配置 |
|---|---|---|---|
| 小断块 | <100万 | 8-16GB | 32GB |
| 中型油田 | 100-500万 | 32-64GB | 128GB |
| 大型区块 | 500-2000万 | 80-150GB | 256GB |
| 油田级全生命周期 | >2000万 | 150-300GB+ | 512GB+ |
2.3 属性建模(Modeling)——多核并行的主战场
核心算法:
- 序贯高斯模拟(SGS)
- 序贯指示模拟(SIS)
- 基于目标的模拟(布尔模拟)
- 协克里金、云变换
- 多实现管理(Realizations)
计算特征:
属性建模中的多实现并行计算是Petrel中唯一真正"吃满"多核的环节。一次运行50个随机实现,64核CPU可实现接近线性的加速比。但每个实现仍需独立的内存空间,因此CPU核心数与内存容量必须同步扩展。
| 计算模式 | 并行特征 | 加速比 | 硬件依赖 |
|---|---|---|---|
| 单实现随机模拟 | 中等并行(4-8线程) | 有限 | 高主频+中等核心 |
| 多实现并行(50-100个) | 高度并行 | 接近线性 | 核心数+内存同步扩展 |
| 地震约束建模 | 中等并行 | 中等 | 内存+多核 |
| 不确定性分析 | 高度并行 | 高 | 核心数越多越好 |
2.4 油藏模拟衔接(Simulation)——I/O与多核并重
Petrel本身不执行油藏数值模拟,而是作为前处理平台生成Eclipse/INTERSECT/CMG的输入 decks。此环节瓶颈在于:
- 模型粗化与导出:千万网格→百万网格的粗化算法需多核并行
- Deck文件生成:大量ASCII文本写入,磁盘I/O敏感
- 结果回读与可视化:与模拟器对接,数据格式转换开销大
三、单核高频 vs 多核并行:Petrel各环节的"速度之王"
3.1 单核高频计算最快的环节
以下环节受限于软件架构的串行特性,CPU主频(GHz)是决定性因素:
| 排名 | 环节 | 原因 | 推荐CPU主频 |
|---|---|---|---|
| 1 | 层位交互追踪 | 每次点击触发串行插值计算 | ≥5.5GHz |
| 2 | 构造框架实时更新 | 网格拓扑重构为串行算法 | ≥5.3GHz |
| 3 | 井轨迹实时设计 | 防碰扫描需逐点计算 | ≥5.3GHz |
| 4 | 三维窗口旋转/缩放 | OpenGL驱动线程为单线程 | ≥5.0GHz |
| 5 | Python API脚本执行 | Petrel内置Python为单线程 | ≥5.0GHz |
3.2 多核并行计算最快的环节
以下环节经过算法优化,可充分利用多核并行,核心数直接决定计算速度:
| 排名 | 环节 | 并行特征 | 推荐核心数 |
|---|---|---|---|
| 1 | 多实现随机模拟(50-100个) | 每个实现独立进程,线性加速 | 32-64核 |
| 2 | 地震叠前反演 | 炮点/角度道集并行 | 16-32核 |
| 3 | 属性体批量计算 | 体素级并行 | 16-32核 |
| 4 | 模型粗化与导出 | 网格分区并行 | 16-32核 |
| 5 | 裂缝网络生成(DFN) | 蒙特卡洛采样并行 | 8-16核 |
四、AI大模型本地部署:Petrel+DeepSeek/Qwen的异构计算革命
4.1 为什么要在Petrel工作站上本地部署大模型?
2025年SLB与Shell达成全球合作,在Petrel平台中深度集成AI能力。本地部署大模型(DeepSeek-R1、Qwen2.5-72B等)可实现:
- 数据安全:地质数据不出本地,满足国企/央企合规要求
- 低延迟交互:本地首token延迟<3秒,长文本报告生成快于云端API
- 离线可用:野外勘探、海上平台等弱网环境仍可运行
- RAG知识库:构建企业私有地质知识库,实现智能报告生成
4.2 本地部署架构
图2:Petrel+AI大模型本地部署五层架构——从Petrel GUI到GPU推理引擎的完整数据流| 层级 | 组件 | 功能 | 硬件依赖 |
|---|---|---|---|
| 应用层 | Petrel GUI + Ocean插件 | 地质建模、地震解释、可视化 | GPU加速渲染 |
| AI中间件 | Python API + LangChain/LlamaIndex | Petrel数据与大模型桥接 | 内存+GPU |
| 大模型层 | DeepSeek-R1 32B/70B、Qwen2.5-72B | 自然语言交互、知识问答、报告生成 | GPU显存 |
| 知识库层 | 地质案例库、文献库、企业标准 | RAG检索增强生成 | 内存+SSD |
| 计算层 | Petrel求解器 + PyTorch/TensorFlow | 地质建模+AI推理 | CPU+GPU |
4.3 AI应用场景详解
场景A:AI辅助地震解释
痛点:三维地震数据体数十GB,层位追踪耗时数周,断层解释多解性强。
方案:
- Petrel加载地震数据体
- Python API提取地震剖面切片,喂给本地计算机视觉模型(微调U-Net)
- AI模型自动识别层位同相轴与断层线,生成初始解释成果
- 地质师在Petrel中审核修正,效率提升5-10倍
- DeepSeek-R1大模型基于解释成果,自动生成"构造解释质量评估报告"
硬件需求:高主频CPU(Petrel响应)+ 大显存GPU(AI推理+三维可视化)
场景B:智能地质建模报告生成(RAG+LLM)
痛点:地质建模完成后,报告撰写依赖个人经验,格式不统一。
方案:
- 构建企业私有知识库:历年建模报告、区域地质规律、行业标准
- Petrel建模结果(构造图、属性体、剖面图)自动导出并索引
- 本地Qwen2.5-72B大模型基于RAG检索,自动生成"地质建模报告"初稿
- 包含:区域地质背景、数据基础、建模方法、成果展示、不确定性分析
- 地质师审核修改,反馈优化模型
硬件需求:大显存GPU(≥48GB)支持72B参数模型本地推理
场景C:沉积相智能识别与建模(ML+Petrel闭环)
痛点:沉积相分布判断主观性强,不同地质师结论差异大。
方案:
- 收集区域已钻井的岩心、测井、地震属性数据作为训练集
- 利用PyTorch训练沉积相分类模型(随机森林/深度神经网络)
- 模型基于新井数据,自动预测沉积相分布概率体
- 概率体导入Petrel,作为序贯指示模拟(SIS)的软约束条件
- Petrel生成最终沉积相模型,不确定性降低30-50%
硬件需求:CPU(Petrel建模)+ GPU(PyTorch模型训练)异构并行
五、预装软件清单(开机即用)
| 类别 | 软件名称 | 版本 | 功能说明 |
|---|---|---|---|
| 操作系统 | Windows 11 Pro / Windows Server 2022 / 银河麒麟V10 | 最新SP | Petrel官方支持+信创合规 |
| 地质建模 | Schlumberger Petrel | 2023.1+ | 地球物理与油藏工程一体化平台 |
| 前后处理 | Techlog / Studio / DELFI Connector | 2023.1+ | 测井解释、数据管理、云端同步 |
| 大模型推理 | Ollama + vLLM + TensorRT-LLM | 最新版 | 本地大模型高速推理 |
| 大模型本体 | DeepSeek-R1 32B/70B(INT8/INT4) | — | 地质知识问答、报告生成 |
| 大模型本体 | Qwen2.5-72B-Instruct(INT8) | — | 中文技术文档理解与生成 |
| AI框架 | PyTorch 2.3 + TensorFlow 2.15 | 2.3+ / 2.15+ | 代理模型训练、PINN、GAN |
| RAG知识库 | LangChain + ChromaDB / Milvus | 最新版 | 地质案例检索增强 |
| 数据处理 | Python 3.11 + NumPy/SciPy/Pandas | 3.11+ | 建模数据清洗与分析 |
| 可视化 | ParaView / MATLAB | 5.12+ / R2024a | 模拟结果后处理 |
六、UltraLAB硬件配置推荐
Petrel+大模型本地部署属于**"单核响应敏感+内存密集型+显存密集型"**的异构计算场景。UltraLAB(西安坤隆计算机科技)提供从入门到旗舰的全覆盖方案。
6.1 方案一:入门AI地质建模站(预算:3-5万元)
| 组件 | 型号/规格 | 说明 |
|---|---|---|
| 机型 | A350 15696-MCB | 超频图形工作站平台 |
| CPU | Intel Ultra9 285K 超频处理器(24核/5.6GHz) | 高主频,层位追踪响应快 |
| 内存 | 96GB DDR5-5600 | 中小规模模型+32B大模型 |
| GPU | NVIDIA RTX A2000 12GB | 专业OpenGL驱动,三维显示稳定 |
| 系统盘 | 4TB NVMe SSD(读14GB/s) | 系统+软件+地震数据缓存 |
| 数据盘 | 2×4TB SATA HDD RAID1 | 项目数据安全存储 |
| 显示器 | 27英寸 2K IPS ×2 | 地震剖面+建模界面双屏 |
| 系统 | Windows 11 Pro | Petrel官方最佳平台 |
| 适用场景 | 单井/小断块建模、中小地震数据体、DeepSeek 32B本地推理 | — |
6.2 方案二:主流AI油藏建模站(预算:6-10万元)
| 组件 | 型号/规格 | 说明 |
|---|---|---|
| 机型 | A350 153128-MCT | 超频图形工作站平台 |
| CPU | Intel Ultra9 265K 超频处理器(20核/5.3GHz) | 多核支持多实现并行 |
| 内存 | 128GB DDR5-5600 | 千万级网格建模无压力 |
| GPU | NVIDIA RTX 5090D 32GB | DeepSeek 32B/70B INT4推理 |
| 系统盘 | 4TB NVMe SSD | 系统+软件 |
| 数据盘 | 2×8TB SATA HDD RAID1 | 海量地震数据归档 |
| 项目盘 | 2TB NVMe SSD(Petrel项目目录) | 大型项目快速加载 |
| 显示器 | 27英寸 4K IPS ×2 | 高分辨率,更多曲线同时显示 |
| 系统 | Windows 11 Pro / Windows Server 2022 | 支持大内存 |
| 适用场景 | 大型油田全区块建模、多实现并行、AI报告生成 | — |
6.3 方案三:旗舰AI地质建模站(预算:15-22万元)
| 组件 | 型号/规格 | 说明 |
|---|---|---|
| 机型 | GR450P 148192-MCC | 极致超频工作站平台 |
| CPU | AMD Ryzen TR 7980X 超频处理器(64核/4.8GHz) | 极限多核,50-100实现并行 |
| 内存 | 256GB DDR5-4800 | 千万网格+AI代理模型训练 |
| GPU | NVIDIA RTX 6000 Ada 48GB | Qwen2.5-72B INT8推理 |
| 系统盘 | 4TB NVMe SSD | 系统+软件 |
| 数据盘 | 4×8TB SATA HDD RAID5 | 企业级数据安全 |
| 项目盘 | 4TB NVMe SSD(Petrel项目+知识库) | 活跃项目+大模型权重高速读写 |
| 显示器 | 27英寸 4K IPS ×2 | 千万网格可视化+AI界面 |
| 系统 | Windows Server 2022 | 支持多用户远程桌面 |
| 适用场景 | 千万网格建模+72B大模型本地部署+团队共享 | — |
6.4 方案四:极限AI地质超算中心(预算:35-50万元)
| 组件 | 型号/规格 | 说明 |
|---|---|---|
| 机型 | GX660M 227256-MC4T | 图灵计算工作站(GPU超算平台) |
| CPU | 2颗Xeon金牌6530处理器(64核/2.7GHz) | 双路并行,多项目并发 |
| 内存 | 256GB DDR5-4800 RDIMM | 超大模型内存保障 |
| GPU | 4×RTX 4090 48GB + 水冷 | 多卡并行:建模可视化+大模型推理+AI训练 |
| 系统盘 | 4TB NVMe Gen5 SSD | 极速系统响应 |
| 数据盘 | 8TB NVMe + 20TB SATA | 热数据+冷数据分层 |
| 网络 | 双万兆以太网 | 多机集群扩展 |
| 散热 | 定制水冷模组 | 4卡满载静音运行 |
| 系统 | Windows Server 2022 / CentOS 8 | 企业级支持 |
| 适用场景 | 油田级全生命周期管理+AI数字孪生+多项目并发 | — |
七、常见问题硬件配置深度分析(FAQ)
Q1:Petrel到底吃CPU还是吃GPU?AI大模型加入后有什么变化?
A:
- 纯Petrel:CPU为主,GPU为辅。CPU决定层位追踪响应速度、网格生成效率、多实现并行能力;GPU仅影响三维可视化流畅度。
-
Petrel+AI:变为CPU+GPU双瓶颈场景:
- CPU:Petrel建模+Python API数据预处理
- GPU:大模型推理(DeepSeek/Qwen)+ AI代理模型训练
- 内存:Petrel千万网格(100GB+)+ 大模型服务进程(20-40GB)同时驻留
投资优先级变化:内存容量 > GPU显存 > CPU主频 > 专业显卡 > CPU核心数
Q2:Petrel加载1000口井数据+运行大模型,内存怎么配?
A:经验公式:
总内存需求(GB) ≈ Petrel峰值(GB) + 大模型服务(GB) + 系统余量(GB)
| 场景 | Petrel峰值 | 大模型服务 | 系统余量 | 建议总内存 |
|---|---|---|---|---|
| 中小项目(<100口井) | 32GB | 16GB | 16GB | 64GB |
| 大型项目(500口井) | 80GB | 24GB | 24GB | 128GB |
| 油田级(1000口井+千万网格) | 200GB | 40GB | 40GB | 256GB+ |
注意:大模型推理若使用INT8/INT4量化,内存占用可降低40-60%。
Q3:消费级显卡(RTX 4090/5090D)能跑Petrel+大模型吗?
A:可以运行,但不建议生产环境使用。
| 对比项 | RTX 4090 24GB | RTX 5090D 32GB | RTX A5000 24GB | RTX 6000 Ada 48GB |
|---|---|---|---|---|
| Petrel三维显示 | 可能纹理闪烁 | 较好 | 稳定,ISV认证 | 极致稳定 |
| 大模型推理 | 24GB显存受限 | 32GB,70B INT4可跑 | 24GB,专业驱动稳 | 48GB,大模型无压力 |
| ECC显存 | ❌ 无 | ❌ 无 | ✅ 有 | ✅ 有 |
| 长时间运行 | 可能掉驱动 | 较好 | 稳定 | 稳定 |
| 价格区间 | 1.3-1.5万 | 1.8-2.2万 | 2.5-3万 | 6-8万 |
建议:入门级可用RTX 5090D,但生产环境(项目交付、客户演示)务必使用RTX A系列或RTX 6000 Ada专业卡。
Q4:大模型推理延迟会影响Petrel的交互体验吗?
A:本地部署的延迟完全可接受。实测数据:
| 配置 | 模型 | 首token延迟 | 生成速度 |
|---|---|---|---|
| RTX 5090D 32GB | DeepSeek-R1 32B | <2秒 | >30 tokens/s |
| RTX 6000 Ada 48GB | Qwen2.5-72B INT8 | <3秒 | >20 tokens/s |
| 云端API(对比) | 同规格 | 200-500ms+排队 | 不稳定 |
优化建议:将大模型服务以API形式常驻内存(vLLM/TGI),Petrel Python脚本通过localhost调用,避免重复加载模型权重。
Q5:Petrel的Python API能直接调用本地大模型吗?
A:可以,通过以下路径:
- Petrel中编写Python脚本(Ocean或外部Python)
-
脚本通过
requests库调用本地大模型API(Ollama/vLLM默认端口11434/8000) - 大模型返回结果(JSON格式)解析后写回Petrel数据模型
- 示例:地震解释结果 → Python提取 → 大模型生成解释报告 → 报告嵌入Petrel项目
注意:Petrel内置Python版本可能较旧(3.8-3.9),建议通过
subprocess调用外部Python 3.11环境运行大模型交互。
Q6:海光信创平台能跑Petrel+大模型吗?
A:可以,但需注意生态适配:
- Petrel:基于x86架构,海光处理器二进制兼容,可直接运行
- 大模型推理:DeepSeek/Qwen有海光DCU优化版,或使用CPU推理(速度慢但可行)
- GPU选择:海光平台建议搭配RTX 5090D/4090(有银河麒麟驱动)或国产GPU(需确认PyTorch适配)
- 性能预期:海光4号32核跑Petrel约为同频Intel的85-90%;大模型推理若用NVIDIA GPU则不受影响
推荐配置:海光信创AI地质站 = 海光5400 32核 + 256GB内存 + RTX 5090D 32GB + 银河麒麟V10
八、硬件投资优先级总览
| 应用场景 | 第一优先级 | 第二优先级 | 第三优先级 | 第四优先级 |
|---|---|---|---|---|
| 纯Petrel建模 | 内存容量 | CPU主频 | 专业显卡 | 磁盘I/O |
| 纯大模型推理 | GPU显存 | GPU算力 | 内存容量 | CPU主频 |
| Petrel+AI并行 | 内存容量 | GPU显存 | CPU主频 | 专业显卡 |
| AI代理模型训练 | GPU算力 | GPU显存 | 内存容量 | CPU多核 |
九、总结
Petrel+大模型本地部署的本质是**"内存密集型+显存密集型+单核响应敏感型"**的异构计算。UltraLAB通过"大内存CPU平台+大显存GPU平台"的异构架构,让地质工程师在运行千万网格Petrel的同时,无缝调用本地DeepSeek/Qwen大模型进行智能分析——从层位追踪到报告生成,一台工作站全搞定。
关键洞察:2026年的地质建模工作站不再是单纯的"CPU+显卡",而是**"高主频CPU+海量内存+大显存GPU+高速NVMe"**四位一体的异构智能平台。UltraLAB的四档配置方案,正是为这一趋势量身打造。
了解更多:
- 官网:xasun.com
- 咨询热线:400-705-6800
- 微信公众号:100369800 或 xasun001
- 业务邮箱:ultralab@foxmail.com
本文版权归西安坤隆计算机科技有限公司所有,转载请注明出处。技术参数以实际出货配置为准。


