






导读:一套深沟球轴承1秒物理时间的多相润滑仿真,在单相CFD模型中仅需55分钟,而在CLS-VOF耦合模型中却需要270.5小时(11天)。这270倍的耗时差距,不是软件缺陷,而是油-气界面追踪、流固耦合迭代与微米级时间步长对算力的极限索取。当轴承设计从"经验润滑"走向"数字润滑",选对算法路线是第一步,为这条路线配置一台"主频不降、内存不爆、多核不闲"的图形工作站,才是让CFD模型从"论文可行"变为"工程可用"的关键。
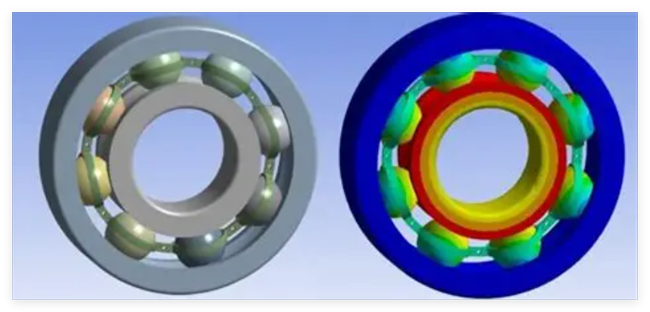
一、研究概述:滚动轴承润滑的数字化挑战
滚动轴承(REB)的失效中,相当一部分可归因于润滑不当。对于高速齿轮箱、传动系统、轮毂轴承等关键部件,搅动损失(Churning Loss)与拖曳损失(Drag Loss)的精确预测直接决定系统效率与热管理设计。
传统Petrov定律基于全膜润滑假设,在高转速下显著高估摩擦力矩——因为它无法捕捉保持架兜孔内的乏油效应。而基于计算流体动力学(CFD)的数值模型,通过求解完整Navier-Stokes方程、追踪油-气两相界面、耦合固体弹性变形,正在取代经验公式,成为轴承润滑设计的核心工具。
二、四大核心算法路线:从简化到全尺度
轴承内部润滑状态按接触区域与压力水平可分为两大阵营,对应截然不同的算法策略:
1. 弹流润滑(EHL)——球-沟道接触的高压战场
物理特征:接触区压力0.5~3 GPa,固体表面发生弹性变形,润滑剂黏度随压力指数级增长(Barus效应)。
核心算法:
-
Reynolds方程求解器:传统路线,基于薄膜假设,适合快速估算
-
CFD-FSI分区耦合:求解完整Navier-Stokes方程 + 固体变形求解器双向耦合
-
计算代价:早期FSI模型平均运行时间20天;高效耦合模型仍需15小时
硬件映射:FSI迭代每步需同步更新流体网格与固体位移,内存峰值高(双物理场数据驻留),多核并行加速分区界面数据传递。
2. 流体动力润滑(HL)——球-保持架接触的低压区
物理特征:接触应力<5 MPa,表面可视为刚性,无需弹性变形计算。
核心算法:
-
单相CFD模型:假设轴承完全浸没于油中,仅求解油相流动
-
计算代价:1秒物理时间仅需55分钟(214万网格单元,Δt=5×10⁻⁴s)
-
适用边界:适合估算整体流场与摩擦损失,但无法预测实际填充水平
硬件映射:单相模型计算量适中,16核CPU+64GB内存即可流畅运行。
3. 多相CFD模型——油-气界面的精确追踪
当轴承非完全浸没(如竖直安装油池润滑,最低位滚动体浸没50%),腔内同时存在油与空气,必须采用多相模型。
| 多相算法 | 界面追踪原理 | 1秒物理时间耗时 | 精度定位 |
|---|---|---|---|
| VOF | 体积分数法,油-气分界阈值0.1 | 22.2小时 | 捕捉油池液面、保持架兜孔油-气条纹 |
| CLS-VOF | 耦合水平集-体积分数,界面恒定为0 | 270.5小时(11天+) | 界面曲率最精确,但计算量爆炸 |
| VOF-DPM | VOF与离散相模型双向转换 | 54.9小时 | 兼顾精度与效率的工程折中 |
关键洞察:CLS-VOF的270小时是在Intel Xeon Gold 6138(16核@2GHz)上完成的。时间步长需压缩至1×10⁻⁶~1×10⁻⁴s以捕捉界面拓扑变化,每步的界面重构、曲率计算、表面张力项求解消耗巨量算力。
4. 无网格方法——DPM与MPS
算法原理:离散化流体为拉格朗日粒子(DPM)或半隐式移动粒子(MPS),而非欧拉网格。
-
优势:天然适应大变形与自由表面,无需界面捕捉算法
-
短板:在预测工程级功率损失方面精度有限,目前多用于概念验证
三、计算特点总结:轴承CFD的五大算力画像
| 计算维度 | 具体表现 | 硬件影响 |
|---|---|---|
| 时间步长墙 | 多相模型Δt低至1×10⁻⁶s,1秒物理时间需10万~100万步 | 每步迭代速度决定总耗时,高主频CPU缩短单步收敛时间 |
| 网格密度墙 | 滚道厘米级 vs 保持架间隙微米级,膨胀层+多面体单元优化后仍需百万级网格 | 大内存承载网格数据+多相流场变量(油/气体积分数、速度、压力) |
| 多相并行墙 | VOF界面重构支持域分解并行,但时间步进本质串行 | 多核CPU(32~96核)加速每步内部并行,但边际效应显著 |
| FSI内存墙 | 流固耦合需同时驻留流体网格、固体网格、界面插值矩阵 | 内存容量为首要瓶颈,大型FSI模型峰值可达128GB+ |
| 长时程稳定墙 | CLS-VOF 270小时连续运行,任何内存错误都导致前功尽弃 | ECC内存+企业级散热是"算完不出错"的基础设施 |
核心结论:轴承润滑CFD是"时间步长吃主频、多相流场吃内存、长时程计算吃稳定性"的复合型重载。Gold 6138(16核@2GHz)运行CLS-VOF需要11天,而现代高主频多核工作站可将这一时间压缩到2~3天。
四、软件工具链:从几何到后处理
| 软件层级 | 工具 | 功能定位 |
|---|---|---|
| CAD建模 | ANSYS SpaceClaim / SolidWorks / Creo | 轴承几何参数化,内圈/外圈/滚动体/保持架装配 |
| 网格划分 | ANSYS Fluent Meshing / ICEM CFD / Poly-Hexcore | 膨胀层(Inflation Layer)捕捉间隙流,多面体单元优化网格数,周期性边界简化 |
| CFD求解器 | ANSYS Fluent / CFX | 单相/多相(VOF/CLS-VOF/DPM)求解,湍流模型(k-ε/k-ω/SST),滑移网格(Sliding Mesh) |
| FSI耦合 | ANSYS Fluent FSI / System Coupling | 流体-固体双向数据传递,网格插值与力映射 |
| 多体动力学 | ANSYS Motion / RecurDyn | 轴承整体动力学与CFD流场联合仿真(高级应用) |
| 后处理 | ANSYS CFD-Post / Ensight / MATLAB | 油-气界面可视化、摩擦力矩提取、Stribeck曲线对比 |
关键工作流:SpaceClaim参数化轴承几何 → Fluent Meshing生成膨胀层多面体网格(214万单元级)→ 定义VOF油-气两相 → 设置滑移网格转速 → 瞬态求解(1×10⁻⁶~5×10⁻⁴s步长)→ 后处理提取体积分数云图与摩擦力矩时程。
五、硬件配置推荐:按CFD模型复杂度精准匹配
基于轴承润滑CFD的计算画像,结合UltraLAB图形工作站产品体系,给出三档配置方案:
【方案A】单相CFD/教学科研/快速验证工作站
适用场景:全膜润滑假设、单相流场分析、网格敏感性研究、教学案例
| 硬件模块 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | Intel Core i9-14900K 超频版 (24核32线程, 5.8GHz+) | 单核主频是Gold 6138(2GHz)的2.9倍,单相模型55分钟可压缩至20分钟以内 |
| 内存 | 64GB DDR5-5600(2×32GB) | 覆盖214万网格单相模型峰值,预留Fluent GUI缓冲 |
| 存储 | 1TB NVMe Gen4 SSD | 秒级加载百万级网格,瞬态结果频繁写入不卡顿 |
| 显卡 | NVIDIA RTX Pro 4000 20GB | CFD-Post 3D后处理流畅旋转、油-气界面云图实时渲染 |
| 系统 | Windows 11 Pro / Ubuntu 22.04 LTS | Fluent官方双平台支持;Linux下MPI并行扩展更优 |
| 显示器 | 27英寸 4K IPS | 网格检查+云图分屏,膨胀层质量一目了然 |
推荐机型:UltraLAB A330 超频图形工作站(全核5.5GHz+水冷稳定输出,静音桌面级)
【方案B】多相VOF/工程级轴承润滑分析工作站
适用场景:油-气两相VOF模型、保持架乏油预测、摩擦力矩精确估算
| 硬件模块 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | AMD Threadripper PRO 7995WX (96核192线程, 2.5~5.1GHz) 或 Intel Xeon W7-3465X (28核56线程, 2.5~4.8GHz) | 96核在VOF域分解并行中优势显著,22小时VOF模型可压缩至4~6小时;Xeon W系列ECC内存保障长时程稳定 |
| 内存 | 128GB DDR5-4800 ECC RDIMM(8×16GB) | 多相流场变量(油/气体积分数、速度、压力、湍流参数)叠加后峰值可达80GB+ |
| 存储 | 2TB NVMe Gen4 SSD(系统+活跃项目)+ 4TB SATA企业级HDD(历史算例归档) | 企业级SSD sustained write保障瞬态结果每步保存 |
| 显卡 | RTX Pro 5000 32GB ×1 | 32GB显存支撑后处理阶段加载GB级瞬态结果文件,4K多窗口流畅操作 |
| 散热 | 360mm液冷+机箱风道优化 | Threadripper/Xeon W满载功耗350W+,液冷确保96核全速输出不降频 |
推荐机型:UltraLAB AE450 液冷图形工作站(支持8通道DDR5,最大2TB内存扩展)
【方案C】CLS-VOF+FSI/企业级重载润滑仿真平台(重算力)
适用场景:CLS-VOF高精度界面追踪、流固耦合FSI、多工况批量润滑分析
| 硬件模块 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | 2× AMD EPYC 9654 (96核192线程×2, 2.4~3.7GHz) 或 2× Intel Xeon Gold 6548Y+ (32核64线程×2) | 双路提供192+物理线程,CLS-VOF 270小时模型可压缩至30~40小时;多工况并发运行 |
| 内存 | 256GB DDR5-4800 ECC(16×16GB) | FSI双物理场+CLS-VOF多相流峰值内存可达180GB+,256GB为安全线 |
| 存储 | 2× 3.84TB U.2 NVMe SSD(RAID 1,系统+活跃项目)+ 16TB SATA HDD(数据库) | RAID 1保障11天长时程仿真数据安全;U.2企业级SSD应对多用户并发读写 |
| 显卡 | RTX Pro 5000 32GB ×2 | 双卡支持多用户后处理隔离,或单用户双屏4K高负载可视化 |
| 系统 | Windows Server 2022 + 远程桌面服务(RDS) | 5~10人远程桌面并发,各工程师独立Fluent会话,开机即用 |
| 网络 | 双万兆以太网 | 企业局域网License服务器连接,降低Fluent并行License冲突 |
推荐机型:UltraLAB GA660 机架式图形工作站(4U双路,支持4×双宽GPU,企业级可靠性)
六、关键选型建议:轴承CFD硬件的"三要三不要"
三要
-
要高主频+多核并重,不要只看核心数:Fluent VOF每步内部并行加速明显,但时间步进串行瓶颈存在,全核睿频≥4.5GHz+物理核≥32核为CLS-VOF甜点配置
-
要大内存+ECC,不要消费级缩水:多相流场变量数是单相的3~5倍,270小时长时程仿真中任何内存翻转都导致发散,ECC内存是"算完"的前提
-
要企业级NVMe+液冷,不要机械硬盘+风冷凑合:瞬态结果每步写入GB级数据,机械硬盘I/O等待会拖慢求解器;风冷机箱在96核满载时触发温度墙,导致每步迭代时间漂移
三不要
-
不要为CFD求解器投资多卡游戏GPU:Fluent核心求解纯CPU计算,GPU仅用于后处理,单卡RTX Pro已足够,多卡预算应全部投入CPU+内存
-
不要忽视网格质量对内存的影响:膨胀层+多面体单元虽减少84%网格数,但劣质网格导致收敛困难、内存峰值异常,硬件再强也救不了坏网格
-
不要省略远程多用户环境:轴承企业通常5~10人共享算力做不同工况对比,预装RDS+会话隔离是"开机即用"的核心价值
结语:让算力匹配润滑的物理尺度
轴承润滑CFD的本质,是在数字空间中复现微米级油膜与毫米级保持架兜孔之间的复杂相互作用。当CLS-VOF模型需要以1微秒步长追踪油-气界面的拓扑变化、当FSI耦合需要同时更新流体压力场与固体位移场、当270小时的仿真结果决定一款轴承能否通过效率认证——硬件不再是后台支撑,而是决定仿真边界的前置条件。
将Gold 6138(16核@2GHz)上运行11天的CLS-VOF模型,迁移到96核高主频工作站+液冷稳定环境上压缩到2~3天完成,这不是"快一点"的优化,而是从"论文验证"到"工程交付"的范式跃迁。
UltraLAB轴承润滑CFD图形工作站,基于Core i9/Xeon W/Threadripper/EPYC全平台架构,提供从64GB到2TB内存、从静音桌面到机架远程并发的全栈算力方案,助力轴承企业、高校摩擦学实验室、传动系统研发部门,在高速轴承润滑设计、搅动损失优化、乏油预测的赛道上,算清每一滴油的轨迹,优化每一瓦特的损耗。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


