






导语:完成一次完整的 CFD 分析,工程师通常要在几何处理、网格划分、物理模型设置、求解监控、结果提取和报告整理之间反复切换。西门子 Simcenter 团队的最新实践给出了答案——通过 MCP(Model Context Protocol)+ AI Agent 连接 STAR-CCM+,工程师只需用自然语言描述模型、介质、工况与结果要求,Agent 即可自动完成流体域检查、边界识别、网格生成、物理设置、求解监控、结果提取,并输出规范化分析报告。本文解析这套自动化闭环背后的核心算法与计算特点,并给出 "CFD + 本地大模型 Agent" 一体化 的 UltraLAB 硬件选型方案。
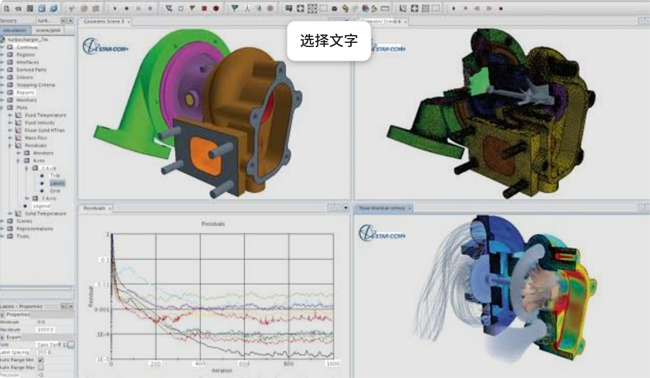
图 1:MCP + AI Agent 驱动 STAR-CCM+ 完成管道流场分析的端到端流程(源自原始案例)
一、核心内容应用分析:从"点软件"到"可复用工程 Skill"
1.1 端到端自动化六步闭环
| 步骤 | 执行方 | 动作 | MCP 参与 |
|---|---|---|---|
| 1 | 用户 | 自然语言提示词输入(几何/介质/工况/报告要求) | — |
| 2 | AI Agent | 任务解析与规划:拆解为几何、网格、物理、报告子任务 | — |
| 3 | AI Agent | 生成或修订 Java 宏(建域·网格·物理·边界) | ✔ 查证 API |
| 4 | STAR-CCM+ |
批处理执行求解(-batch 运行宏、回读日志)
|
— |
| 5 | STAR-CCM+ | 后处理出图(流速云图·流线·边界层) | ✔ 查证 API |
| 6 | AI Agent | 判据自检(守恒误差、y+)与报告交付(西门子 PPT 模板) | — |
关键设计理念:MCP 的作用不是让 AI 模拟鼠标点击,而是把 STAR-CCM+ 中稳定、可重复的操作封装成标准工具(search_api 检索类与方法、get_doc 读取 Javadoc、批处理执行),实现"查准 API 再动手";判据不达标时回到第 ③ 步续算或修订宏——零报错 ≠ 算对,用物理判据决定是否回炉。
1.2 典型案例数据(阶梯圆管内流)
| 指标 | 数值 | 判据 |
|---|---|---|
| 几何 | 入口段 Ø200×500 / 中段 Ø400×800 / 出口段 Ø200×500 mm,总长 1800 mm | 沿 X 轴三段串联 |
| 网格 | 基础尺寸 10 mm,8 层棱柱边界层(增长率 1.15,总厚 4.0 mm) | Resurfacer + Prism + Trimmer |
| 单元数 | 191,049 | 六面体切割体为主 |
| 求解器 | 分离式流求解器(Segregated Flow)+ SST k-ω(All y+ 壁面处理) | 稳态不可压 |
| 工况 | 入口 10 m/s,出口 0 表压,液态水 20℃ | 无滑移壁面 |
| 迭代 | 累计 1000 步,首轮耗时 324 s | 单机 4 线程(Intel MPI) |
| 收敛判据 | 质量守恒误差 6.24e-4 kg/s(判据 < 1e-3) | 通过 |
| 网格质量 | 单元质量均值 0.742;平均壁面 y+ = 33.8 | All y+ 有效区间 |
| 结果 | 全局最大流速 12.49 m/s;突扩减速至约 2.5 m/s 并形成回流涡团;总压沿程单调下降 | 流线/云图/沿程曲线 |
1.3 扩展案例:油冷电机瞬态流动与传热
同一工作流可驱动更复杂的多物理场算例:66.4 万单元、3 区域(旋转/固定/壳体),采用 MMP 混合多相 + LSI 大尺度界面 + ADIS 交界面锐化 + 液膜 + 拉格朗日油滴 + S-Gamma 粒径分布 的模型链,配合 AMR 自适应网格 在自由表面自动加密,隐式非稳态 + 自适应时间步运行,输出绕组温度时程、油相转换质量与流态场景动画。
1.4 价值沉淀:从演示到 Skill 资产
真正有价值的不是让 AI 替工程师点完一次软件,而是把入口识别、网格策略、物理模型选择、收敛判断、异常处理和报告结构逐步标准化为可复用 Skill——下一次面对不同管径、流量、弯头半径和阀门开度的批量方案计算时,工程师只需说明模型、工况和验收标准,最终交付的是包含模型、日志、图片、数据和报告的完整交付包。
二、主要核心算法:自动化 CFD 背后的数值方法栈
2.1 流动求解算法
| 算法层 | 方法 | 作用与特点 |
|---|---|---|
| 离散框架 | 有限体积法 FVM(切割体六面体网格) | 守恒性好,适合复杂几何 |
| 压力-速度耦合 | 分离式求解器(SIMPLE 类算法) | 稳态分析稳健,内存开销低 |
| 湍流封闭 | SST k-ω 两方程模型 + All y+ 壁面处理 | 兼顾近壁剪切层与自由剪切流,y+ 30~300 区间无需切换壁面函数 |
| 边界层解析 | 棱柱层网格(Prism Layer) | 8 层增长率 1.15,解析壁面速度梯度极大区 |
| 多相流 | MMP 体积分数输运(VOF 类)+ LSI + ADIS | 连续油/液膜/油滴三相共存与双向转换 |
| 液膜/拉格朗日 | 亚网格过渡模型 + S-Gamma 粒径 | 液滴↔MMP、液膜↔MMP 质量/动量/能量双向交换 |
2.2 自动化与 AI 层算法
| 组件 | 技术 | 说明 |
|---|---|---|
| 工具封装 | MCP 协议(search_api / get_doc / batch) | STAR-CCM+ Java API 的标准化工具层,Agent 查证后再执行 |
| 流程驱动 |
STAR-CCM+ Java 宏批处理(-batch)
|
_work/gen_geom.py 生成几何 → java/spf_sim.java 建模求解后处理,全流程可一键复算
|
| 任务规划 | LLM Agent 任务拆解与规划 | 意图理解、子任务分解、工具编排、结果校验闭环 |
| 报告生成 | 模板化 PPT 交付(任务概述→几何工况→物理模型→网格设置→收敛判断→流场结果→压降分析→结论) | 所有数值和图片必须来自本次实际计算结果 |
2.3 验收算法:物理判据自检
收敛判据 = 残差下降 + 质量守恒误差 < 1e-3 kg/s + y+ 落在模型有效区间
          ↑ 三者同时满足才算"算对",任一不满足 → 回炉修订宏
三、计算特点:"CFD + 本地 Agent" 工作站的四大负载特征
此类自动化工作流与传统 CFD 工作站的最大区别:同一台机器上同时跑三类负载——STAR-CCM+ 求解(CPU 密集)、LLM Agent 推理(GPU 显存密集)、海量中间产物读写(I/O 密集)。
| 负载阶段 | 资源特征 | 硬件瓶颈 | 选型含义 |
|---|---|---|---|
| 网格生成(Resurfacer+Prism+Trimmer) | 单线程为主 + 大内存 | CPU 主频、内存容量 | 高主频平台优先(5.0GHz 级) |
| 稳态分离式求解 | 多核 MPI 并行 + 内存带宽 | 核数 × 内存带宽 | 8/12 通道 DDR5 平台 |
| 瞬态多相 + AMR | 步数多、自适应加密、重网格频繁 | 全资源(CPU+内存+I/O) | 大内存 + 高频 NVMe,计算量约为稳态单相的 10~50 倍 |
| 本地 LLM Agent(7B~32B 参数) | 显存驻留 + Token 生成延迟 | GPU 显存容量与带宽 | 32GB 显存起步,推荐 48~96GB |
| 宏批处理日志/截图/时序数据归档 | 小文件高频读写 | NVMe 随机性能 | Gen4/Gen5 NVMe 热盘 + 大容量冷盘分层 |
内存估算示例:
稳态单相:网格单元数 × 15~20 个变量 × 8字节 × 2~3倍系数
油冷电机 66.4万单元瞬态多相:建议 ≥ 192GB
本地 LLM(32B 量化模型):模型权重 ~20GB + KV Cache → 建议显存 ≥ 48GB
四、UltraLAB 硬件配置怎么选:四档方案
4.1 选型决策树
批量标准件流阻评估 / 教学演示      → 方案A(自动化入门型)
千万级网格稳态 RANS + 本地7B Agent → 方案B(工程主力型)
瞬态多相(油冷电机级)+ 本地32B Agent → 方案C(AI+CFD 平台型)
多相流 + 全参数批量扫描 + 数字孪生   → 方案D(旗舰交付型)
4.2 方案A:自动化入门型(预算 8~12 万)
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| 机型 | UltraLAB GR450P | 超频塔式工作站,办公静音 |
| 处理器 | AMD Threadripper PRO 7975WX(32核,超频 5.0GHz) | 高主频加速网格划分与参数扫描 |
| 内存 | 128GB DDR5 ECC(八通道) | 支撑 20 万~500 万单元稳态算例 |
| 显卡 | RTX 4070 Ti SUPER 16GB | 本地 7B Agent + 后处理可视化 |
| 存储 | 4TB NVMe Gen5(14GB/s) | 宏日志、截图、时序数据快速归档 |
| 散热 | 定制水冷系统 | 超频满载稳定性保障 |
适用:标准件流阻评估、管路设计迭代、教学演示、Skill 流程验证。
4.3 方案B:工程主力型(预算 16~22 万)
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| 机型 | UltraLAB GR450P 高配 | 64核 + 大内存超频平台 |
| 处理器 | AMD Threadripper 7980X(64核,超频 4.8GHz) | STAR-CCM+ 千万级单元 + 批量工况并行 |
| 内存 | 192GB DDR5 ECC | 千万级单元稳态 + Agent 上下文驻留 |
| 显卡 | RTX 5090D 32GB | 本地 14B~32B 量化 Agent 流畅推理 |
| 存储 | 4TB NVMe + 8TB SATA | 热/冷数据分层,交付包归档 |
| 散热 | 定制水冷系统 | 64核满载温控 |
适用:管路批量方案计算、阀门/弯头开度扫描、西门子模板报告模板化交付。
4.4 方案C:AI + CFD 平台型(预算 30~40 万)
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| 机型 | UltraLAB GX660M | 图灵计算工作站,4卡GPU静音平台 |
| 处理器 | 2× Intel Xeon 金牌 6530(64核) | 双路保障瞬态多相求解与多任务并行 |
| 内存 | 384GB DDR5 ECC(十六通道) | 油冷电机级瞬态多相(66万+单元)+ AMR 加密 |
| 显卡 | 2× RTX 5090D 32GB(共64GB显存) | 32B 本地大模型 + CFD 后处理分卡并行 |
| 存储 | 4TB NVMe Gen5 + 20TB SATA | 瞬态时序数据海量归档 |
| 网络 | 双口 40G 以太网 | 集群扩展预留 |
适用:油冷电机 MMP 多相瞬态、旋转机械滑移网格、多工况并发自动化队列。
4.5 方案D:旗舰交付型(预算 50~70 万)
| 组件 | 推荐配置 | 选型理由 |
|---|---|---|
| 机型 | UltraLAB AlphaPro660 | 超级图形工作站,192核 + 96GB显存 |
| 处理器 | 2× AMD EPYC 9655(192核,4.1GHz) | 全参数批量扫描 + 多物理场耦合极致平台 |
| 内存 | 768GB DDR5 ECC(十二通道) | 多相流 + 流热固耦合 + 大模型上下文同机驻留 |
| 显卡 | RTX PRO 6000 96GB | 32B~70B 本地大模型全量推理 + 4K 级流场渲染 |
| 存储 | 8TB NVMe(14GB/s)+ 20TB SATA | 超高速缓存 + 交付包/数字孪生数据底座 |
| 散热 | 双 2000W 塔式水冷 | 旗舰级热设计功耗保障 |
适用:企业级 CFD Skill 资产平台——多部门共用、全参数空间自动扫描、实时数字孪生推演。
五、软件清单:开机即用的"CFD + Agent"全栈环境
5.1 CFD 与自动化软件
| 类别 | 软件 | 角色 |
|---|---|---|
| CFD 求解器 | Simcenter STAR-CCM+ 21.02 / 2024.x(含 PoD 许可) | 主力求解器,Java 宏批处理 |
| 几何前处理 | STAR-CCM+ 内建 CAD/Resurfacer、SpaceClaim、NX | 流体域抽取与表面重构 |
| 后处理 | STAR-CCM+ Scene、ParaView、Tecplot 360 | 云图/流线/沿程曲线 |
| 自动化框架 | starccm-ai-engineering-workbench(GitHub MCP 项目) | MCP 工具层封装 |
| 脚本环境 |
Python 3.10+(_work/gen_geom.py)、JDK 17+
|
几何生成与 Java 宏 |
5.2 AI Agent 环境(UltraLAB 预装交付)
# 基础环境
Ubuntu 22.04 LTS + CUDA 12.4 + Driver 550+
Miniconda3 + Docker

# CFD 环境
module load: STAR-CCM+ 2024.x / Java 17 / Intel MPI
工具链: -batch 批处理 + Macro 录制回放

# 本地大模型 Agent(数据不出域)
conda env: agent  (Ollama / vLLM + Qwen2.5-32B-Instruct / DeepSeek-R1-Distill-32B)
conda env: mcp    (Model Context Protocol SDK + StarCCM+ workbench)

# 报告与交付环境
conda env: report (python-pptx + 西门子 PPT 模板 + JupyterLab)
六、应用场景:让每一份 CFD 分析都成为可复用资产
| 应用场景 | 典型任务 | 推荐机型 |
|---|---|---|
| 管路系统 | 管径/流量/弯头半径/阀门开度批量扫描、标准件流阻评估 | 方案A / 方案B |
| 新能源热管理 | 油冷电机瞬态多相与传热、电池包冷却回路优化 | 方案C / 方案D |
| 旋转机械 | 泵/风机/压缩机性能曲线自动测绘、滑移网格瞬态分析 | 方案B / 方案C |
| 汽车工程 | 整车热管理、除霜除雾、动力总成冷却自动化报告 | 方案C |
| 流程工业 | 管网水锤、换热网络、混合器多相流批量评估 | 方案B / 方案C |
| 企业数字化 | CFD Skill 资产库、模板化交付、数字孪生实时推演 | 方案C / 方案D |
七、常见问题:硬件配置分析(FAQ)
Q1:跑 STAR-CCM+ 自动化分析,为什么还需要大显存 GPU?
工作流中 LLM Agent 需要本地常驻:7B 模型需约 10GB 显存、32B 量化模型需 20GB+、若需长上下文(Javadoc 检索结果 + 日志回读)还要叠加 KV Cache。16GB 显存是起步线,工程级推荐 32GB,旗舰级 96GB;显存不足会触发换页,Agent 响应从秒级退化到分钟级。
Q2:网格划分慢,升级 CPU 核数有用吗?
收效甚微。STAR-CCM+ 的面网格重构与棱柱层生成以单线程/少线程为主,瓶颈在 CPU 主频与内存延迟。提升网格速度应优先选 5.0GHz 级高主频处理器,而非堆核。
Q3:内存容量怎么估算?
稳态单相约 单元数 × 300~500 字节;瞬态多相 + AMR 建议按 3~5 倍余量。参考:20 万单元管道算例 64GB 即可;66 万单元油冷电机瞬态多相建议 ≥192GB;若同机跑本地大模型,另预留 32~64GB 系统内存。
Q4:PoD(按使用付费)许可模式下,硬件怎么配更划算?
PoD 按小时计费,算得快就是省钱:64 核高主频平台可把单次稳态分析从小时级压到分钟级,配合夜间批量队列,PoD 成本可下降一个量级。这也是自动化 Skill 的经济价值所在。
Q5:Agent 自动出的结果能直接信吗?
不能。原文强调"零报错 ≠ 算对":Agent 自检依靠物理判据(质量守恒误差 < 1e-3、y+ 有效区间、残差趋势),不达标自动回炉修订宏。工程师仍须复核物理假设与关键结论——机器负责重复执行与留痕,人负责物理判断。
Q6:企业数据安全如何保障?
整条链可在纯内网闭环:STAR-CCM+ 本地批处理 + MCP 本地部署 + 本地开源大模型(Qwen/DeepSeek 等),任何几何与工况数据不出域,满足敏感行业合规要求。UltraLAB 全面支持麒麟/UOS 等国产 OS 适配。
Q7:多台工作站如何扩展为团队级自动化平台?
方案B/C/D 机型均可通过 40/100GbE 组网,共享 NVMe 存储池 + 任务队列(如 Slurm),前端统一 Agent 入口,后端按算例规模自动分配节点——从"个人 Skill"平滑升级为"团队 CFD 中台"。
结语:工程师的新分工——人判物理,机跑流程
MCP + AI Agent 与 STAR-CCM+ 的结合,标志着 CFD 工程范式的一次转移:工程师把精力放在物理问题、模型假设和结果判断上,AI Agent 负责重复执行、过程留痕和材料整理。而支撑这条闭环的基础设施,必须同时满足求解器的高带宽并行、大模型的高显存推理与全流程的海量 I/O——这正是 UltraLAB 一体化工作站的设计出发点。
UltraLAB 图形工作站供货商
西安坤隆计算机科技有限公司 | 国内知名高端定制图形工作站厂家
业务电话:400-705-6800 | 咨询微信号:100369800如需针对 STAR-CCM+ 特定版本与本地大模型 Agent 进行联合基准测试,或定制符合预算的自动化 CFD 工作站方案,欢迎联系 UltraLAB 技术团队。


