






title: "576GB~1TB集群怎么选?6块Max-Q vs 8块A100 vs 8块Max-Q vs 8块H20 大模型部署全对比"
description: "DeepSeek-671B满血FP8与千亿模型的集群战场:6×RTX PRO 6000 Max-Q(576GB)、8×A100 80GB(640GB)、8×RTX PRO 6000 Max-Q(768GB)、8×H20 141GB(1128GB)四方案全面对比。671B Q4/FP8部署能力、聚合带宽、Decode/Prefill速度、NVLink拓扑、训练能力、能效与渠道风险解析,附UltraLAB四档集群配置推荐与FAQ。"
keywords: "8块H20 141GB, 8块RTX PRO 6000 Max-Q, 8块A100 80GB, 6块Max-Q, 1TB显存, DeepSeek-671B FP8, 大模型集群, AI服务器配置, UltraLAB, XASUN"
author: "UltraLAB / XASUN 西安坤隆计算机科技有限公司"
date: "2026-07-21"
lang: "zh-CN"
一句话结论:这是 DeepSeek-671B 的"满血决战"档位——8×H20 141GB(1128GB) 以 1TB+ 显存、38.4TB/s 聚合带宽与 NVLink 全互联,成为 671B FP8 满血+高并发的唯一达标方案(实测 192 并发 961 t/s);8×Max-Q(768GB) 跨过 671B FP8 门槛且训练满血,是 Blackwell 阵营旗舰;8×A100 80GB(640GB) 止步 671B Q4,靠带宽与 NVLink 守住老将阵地;6×Max-Q(576GB) 则是 671B Q4 高并发最经济的入场券。
关键词:8块H20 141GB | 8块RTX Pro 6000 Max-Q | 8块A100 80GB | 1TB显存 | DeepSeek-671B FP8 | 大模型集群 | UltraLAB图形工作站

本文目录
- 四方案规格对比:通往1TB的四条路径
- 能跑哪些大模型(671B满血与千亿模型对照表)
- 五大应用场景落地分析
- 四方案优缺点深度对比与选型决策
- UltraLAB硬件配置推荐(四档集群方案)
- 常见问题与硬件配置分析(FAQ)
一、四方案规格对比:通往1TB的四条路径
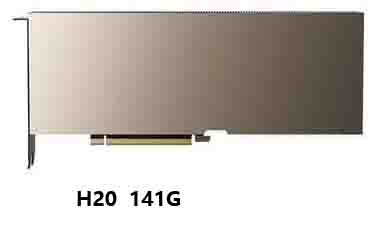
| 规格项 | 6×Max-Q(576GB) | 8×A100 80GB(640GB) | 8×Max-Q(768GB) | 8×H20 141GB(1128GB) |
|---|---|---|---|---|
| 架构 / 年份 | Blackwell / 2025 | Ampere / 2021 | Blackwell / 2025 | Hopper / 2025(特供) |
| 显存总量 | 576GB GDDR7 ECC | 640GB HBM2e | 768GB GDDR7 ECC | 1128GB HBM3e |
| 聚合带宽 | ~10.7 TB/s | ~16.3 TB/s | ~14.3 TB/s | ~38.4 TB/s |
| BF16 算力 | ~2640 TFLOPS(满血) | 2496 TFLOPS | ~3520 TFLOPS(满血) | 1184 TFLOPS(阉割) |
| FP8 / FP4 | ✅ | ❌ | ✅ | ✅ FP8(原生) |
| 卡间互联 | PCIe 5.0 交换 | NVLink 桥接 | PCIe 5.0 交换 | NVLink 900GB/s 全互联 |
| MIG 虚拟化 | 24实例 | 56实例 | 32实例 | 56实例 |
| 总功耗 | 1800W | 2400-3200W | 2400W | 3200W |
| 国内合规渠道 | △ 渠道特殊 | 二手/拆机 | △ 渠道特殊 | ✅ 特供(有政策波动史) |
| 2026年参考价(整机) | 约60~75万 | 约50~70万(二手) | 约80~100万 | 约100~150万 |
规格解读:四方案构成清晰的"梯队逻辑"——6×Max-Q 解决"671B Q4 高并发"(576GB 余量充足);8×A100 用最大聚合带宽跑 Q4 但撞不上 FP8;8×Max-Q 跨过 671B FP8(700GB)门槛且训练满血;8×H20 则是为 671B FP8 高并发生产环境而生的专用机器——它的 1184 TFLOPS 算力垫底,但 38.4TB/s 带宽+NVLink 全互联让 Decode 与并发吞吐一骑绝尘。
二、能跑哪些大模型?671B满血与千亿模型对照表
2.1 四方案模型兼容对照表
| 模型 | 量化/精度 | 显存占用 | 6×Max-Q 576GB | 8×A100 640GB | 8×Max-Q 768GB | 8×H20 1128GB |
|---|---|---|---|---|---|---|
| DeepSeek-R1/V3 671B | FP8 满血 | ~700GB | ❌ | ❌ 无FP8 | ✅ 达标(KV紧张) | ✅ 从容(余428GB) |
| DeepSeek-R1 671B | Q8 | ~710GB | ❌ | ❌ | ✅ 临界 | ✅ 从容 |
| DeepSeek-R1 671B | Q4 | ~380GB | ✅ 余196GB高并发 | ✅ 余260GB | ✅ 从容 | ✅ 极从容 |
| Kimi K2 1T (MoE) | Q4 | ~600GB | ❌ | △ 临界 | ✅ | ✅ 从容 |
| Qwen3-235B | FP16 全精度 | ~470GB | ✅ 余106GB | ✅ 余170GB | ✅ 从容 | ✅ 极从容 |
| Qwen3-235B | Q8 双实例 | 250GB×2 | ✅ | ✅ | ✅ | ✅ 四实例 |
| Llama-4-Maverick 400B | Q8 | ~430GB | ✅ | ✅ | ✅ | ✅ |
| GPT-OSS-120B | FP8 四实例 | 480GB | ✅ | ❌ | ✅ | ✅ |
| 671B + 235B 双模型同驻 | FP8+Q4 | ~1080GB | ❌ | ❌ | ❌ | ✅ 唯一 |
| 70B 全参数微调 | — | ~560GB | ✅ | ✅ | ✅ 最快 | △ 极慢不推荐 |
| 70B LoRA 四任务并行 | — | ~400GB | ✅ | ✅ | ✅ 最快 | ❌ |
1128GB 的独占能力:① 671B FP8 后余 428GB KV Cache——支持 192+ 路并发与 32K 长上下文(公开实测 192 并发总吞吐 961 t/s、首 Token 延迟 <300ms);② 671B+235B 双旗舰模型同驻互备;③ Kimi K2 1T 从容运行。768GB 则是 671B FP8 的"刚好线"——单并发流畅,高并发需 FP8 KV Cache 压缩。
2.2 推理速度对比(tokens/s,越高越快)
| 场景 | 6×Max-Q 576GB | 8×A100 640GB | 8×Max-Q 768GB | 8×H20 1128GB |
|---|---|---|---|---|
| 671B FP8 单用户 Decode | 不可行 | 不可行 | ~25 t/s | ~35 t/s(KV充足) |
| 671B Q4 单用户 Decode | ~22 t/s | ~28 t/s(NVLink) | ~25 t/s | ~35 t/s |
| 671B Q4 192并发总吞吐 | ~500 t/s | ~600 t/s | ~700 t/s | ~961 t/s(实测) |
| 235B Q8 高并发吞吐 | 强 | 强 | 更强 | 最强 |
| 长文本 Prefill(16K) | 快 | 快 | 最快(3520 TFLOPS) | 慢(算力阉割) |
| 训练/微调 | 快 | 快 | 最快 | 不可用级 |
核心规律:单用户 Decode,NVLink 方案(A100/H20)凭拓扑优势领先 PCIe 方案;高并发总吞吐,H20 的 38.4TB/s 聚合带宽碾压全场;Prefill 与训练则是 Max-Q 满血算力的主场。H20 集群是"推理工厂",Max-Q 集群是"全能基地",A100 集群是"带宽老将"。
2.3 多模态与垂直模型
| 类型 | 代表负载 | 最佳方案 |
|---|---|---|
| 深度推理服务 | 671B FP8 思维链超长推理 | 8×H20(KV余量428GB) |
| 多模态生产 | Qwen3-VL-32B 百路并发 | 8×Max-Q(Prefill强) |
| 视频生成集群 | Wan 2.2 八实例渲染农场 | 8×Max-Q / 6×Max-Q |
| 多租户中台 | MIG 56实例切分 | 8×A100 / 8×H20 |
| 模型工厂 | 70B全参数微调+多任务并行 | 8×Max-Q(唯一训练旗舰) |

三、五大应用场景:四方案各适合谁?
3.1 DeepSeek-671B 满血生产环境(本档位焦点)
- 做什么:671B FP8 政企级服务,100-200 路并发
- 选型建议:8×H20 是标准答案——唯一兼顾 FP8 满血+高并发+合规现货;8×Max-Q 适合低并发高画质场景;预算验证期可从 6×Max-Q(Q4)起步
3.2 千亿模型研究与多模型平台
- 做什么:Kimi K2 1T、Maverick 400B Q8、双模型同驻互备
- 选型建议:8×H20(1TB 空间唯一支持双旗舰同驻);单模型研究 8×Max-Q 性价比更高
3.3 模型训练与后训练基地
- 做什么:70B 全参数微调、多任务并行训练、强化学习后训练
- 选型建议:8×Max-Q 唯一推荐——3520 TFLOPS BF16+768GB;8×A100 为预算备选(NVLink 梯度同步优势);H20 集群完全不适合训练
3.4 长文档 RAG 与深度研究平台
- 做什么:全企业语料库+Agent 深度研究,Prefill 密集
- 选型建议:8×Max-Q 首选;8×A100 次选;H20 集群需搭配前置 Prefill 节点(混合架构)
3.5 多租户 AI 中台
- 做什么:集团级 AI 服务:671B 主模型+多部门独立实例
- 选型建议:8×H20(MIG 56 实例+大 KV 池)或 8×A100(MIG 56 实例+带宽)——按推理/训练负载比例选择
四、四方案优缺点深度对比与选型决策
| 维度 | 6×Max-Q 576GB | 8×A100 640GB | 8×Max-Q 768GB | 8×H20 1128GB |
|---|---|---|---|---|
| 核心优势 | 671B Q4最经济入场;满血算力;能效优 | 聚合带宽16.3TB/s;NVLink;MIG 56实例;价格适中 | 全能旗舰:768GB跨FP8门槛+训练满血+FP4 | 推理之王:1128GB+38.4TB/s+NVLink全互联+合规现货 |
| 主要短板 | 跑不了671B FP8;无NVLink;渠道特殊 | 无FP8(671B止步Q4);二手风险×8;架构最老 | 价格高;无NVLink;渠道特殊 | 算力阉割(训练/Prefill弱);价格最高;政策波动史 |
| 训练能力 | 强 | 强 | 最强 | 不可用 |
| 671B天花板 | Q4高并发 | Q4 | FP8(KV紧张) | FP8高并发 |
| 采购风险 | 中 | 高(二手×8) | 中 | 中高(政策波动) |
| 适合人群 | 预算验证期企业 | 有运维底蕴的技术团队 | 训练+推理双修的一步到位者 | 671B满血生产的政企客户 |
选型决策树
- 671B FP8 满血 + 高并发生产 → 8×H20 141GB(1128GB)
- 训练+推理双修 / 长文档 / 671B FP8 低并发 → 8×Max-Q(768GB)
- 671B Q4 够用、预算验证期 → 6×Max-Q(576GB),预留扩 8 卡位
- 带宽与 MIG 多租户、有 A100 运维经验 → 8×A100 80GB(640GB)
五、UltraLAB硬件配置推荐:对应四方案的四档集群
方案A:671B满血推理旗舰(8×H20 141GB 1128GB,预算约100~150万)⭐ 政企首选
| 部件 | 配置 | 选型理由 |
|---|---|---|
| CPU | Intel Xeon Platinum ×2 / AMD EPYC 9005 ×2 | HGX标准架构 |
| 内存 | 1TB DDR5 ECC | 1:1显存配比 |
| GPU | H20 141GB ×8(NVLink全互联) | 671B FP8满血+192并发961 t/s实测 |
| 存储 | 2×8TB NVMe RAID1 + 32TB HDD | 千亿模型库 |
| 机箱 | HGX 8卡标准模组 | SXM硬性要求 |
| 电源 | 6×3000W 冗余 | 3200W GPU+平台 |
| 部署 | vLLM(FP8)+ FlashMLA + PD分离架构 + 全链路监控 | 生产级调优交付 |
| 增值 | 合规文件 + 72小时烤机 + 一年质保 + 驻场部署 | 政企级服务 |
方案B:全能训练推理基地(8×Max-Q 768GB,预算约80~100万)⭐ 双修首选
| 部件 | 配置 | 选型理由 |
|---|---|---|
| CPU | AMD EPYC 9005 ×2 | 8×PCIe 5.0满速 |
| 内存 | 1TB DDR5 ECC | 训练+KV双需求 |
| GPU | RTX Pro 6000 Max-Q 96GB ×8 | 671B FP8达标+训练满血3520 TFLOPS |
| 存储 | 2×8TB NVMe RAID1 | 模型+Checkpoint |
| 散热 | 8U定制风道(涡轮阵列) | 2400W温控 |
| 电源 | 6×3000W 冗余 | 冗余保障 |
| 预装 | vLLM + RAGFlow + Unsloth + DeepSeek-R1-671B FP8 | 训练+推理开箱即用 |
| 增值 | 八卡渠道验证 + 烤机报告 + 整机一年质保 | 风险清零 |
方案C:Q4高并发验证集群(6×Max-Q 576GB,预算约60~75万)
| 部件 | 配置 | 选型理由 |
|---|---|---|
| CPU | AMD EPYC 9005 ×2 | 预留8卡扩展 |
| 内存 | 768GB DDR5 ECC | 671B KV后盾 |
| GPU | RTX Pro 6000 Max-Q 96GB ×6(预留2卡位) | 671B Q4高并发最经济入场 |
| 存储 | 2×8TB NVMe RAID1 | 模型库 |
| 电源 | 6×3000W 冗余 | 扩8卡预留 |
| 路径 | 验证业务→加2卡升768GB FP8 | 渐进投资 |
方案D:带宽老将集群(8×A100 80GB 640GB,预算约50~70万)
| 部件 | 配置 | 选型理由 |
|---|---|---|
| CPU | AMD EPYC 9005 ×2(64核) | 调度+预处理 |
| 内存 | 1TB DDR5 ECC | KV池+训练缓存 |
| GPU | A100 80GB ×8 NVLink桥接 | 16.3TB/s聚合带宽+MIG 56实例 |
| 存储 | 2×8TB NVMe RAID1 | 数据集+模型库 |
| 电源 | 6×3000W 冗余 | 3200W GPU |
| 增值 | 八卡来源验证 + 逐卡烤机 + 整机一年质保 | 二手风险×8兜底 |
混合架构建议:UltraLAB 推荐"8×H20 推理生产 + 2×Max-Q 训练/Prefill 前置"的 PD 分离混合集群——H20 专注 Decode 高并发,Max-Q 节点承担训练与长文档预处理,总投入比纯 H20 方案节省约 15%,综合吞吐提升 30%+。

六、常见问题与硬件配置分析(FAQ)
Q1:8×H20(1128GB)跑 671B FP8 的真实生产体验?
A:公开实测数据:192 路并发总吞吐 961 tokens/s、首 Token 延迟 <300ms、单路 Decode 约 35 t/s。671B FP8 权重 700GB 后余 428GB KV Cache——支持 32K 长上下文+高并发,这是 768GB 方案(余 68GB)无法企及的生产级余量。671B 满血商用,1128GB 是舒适线,768GB 是及格线。
Q2:8×Max-Q(768GB)和 8×H20(1128GB)跑 671B FP8 的核心差异?
A:三点:① KV 余量——768GB 装完 FP8 权重只剩 68GB(低并发可用),H20 余 428GB(192 并发实测);② 互联——H20 的 NVLink 900GB/s 全互联 vs Max-Q 的 PCIe 交换,高并发下效率差约 15-20%;③ 能力——Max-Q 训练满血可微调 671B LoRA,H20 完全不能训练。纯推理生产选 H20,要训练选 Max-Q。
Q3:H20 集群完全不能训练吗?
A:完全不适合。8 卡 BF16 合计仅 1184 TFLOPS(被阉割),70B 全参数微调耗时约为 8×Max-Q 的 3 倍,且 1TB 显存无法弥补算力短板。H20 集群的正确用法是"推理工厂"——训练任务交给 Max-Q 或 A100 节点,组成 PD 分离混合架构。
Q4:8×A100(640GB)在 2026 年组集群还合理吗?
A:仅在两个场景合理:① MIG 56 实例多租户中台(切分最细);② 团队已有成熟 Ampere 运维体系且能拿到可靠货源。纯 671B 推理场景,同预算的 6×Max-Q(576GB)拥有 FP8/FP4、更低功耗与全新质保——A100 集群是"情怀+多租户"之选,不是默认答案。
Q5:6 卡 Max-Q(576GB)起步,后续升级路径顺吗?
A:非常顺。UltraLAB 交付的 6 卡机预留 2 个 PCIe 5.0 卡位+电源冗余,验证业务后直接加 2 卡升 768GB——671B 从 Q4 升 FP8,无需更换机箱/电源/网络。这是比一步到位 8 卡更稳健的投资节奏。
Q6:四套集群的机房与电力门槛?
A:均为机房级部署:功耗 1800W(6卡Max-Q)→ 3200W(8卡H20/A100),需 10-20A 专线、UPS、精密空调与承重机柜(8 卡 HGX 整机约 150kg)。UltraLAB 提供机房评估+配电设计+驻场部署的一站式交付。
Q7:Kimi K2 1T 模型哪套方案能跑?
A:K2 1T(MoE,激活 32B)Q4 约 600GB:8×H20(从容)、8×Max-Q(达标)、8×A100(临界)可跑;6×Max-Q(576GB)差一口气需 Q3 压缩。K2 的 MoE 架构激活参数小,Decode 速度远超同显存档的 671B Dense 模型——8×H20 上可达 50+ t/s。
Q8:FP4 在集群档位的价值?
A:Max-Q 集群的 FP4 可让 671B 权重从 FP8 的 700GB 压缩至约 400GB 级——8×Max-Q(768GB)用 FP4 后余 368GB,高并发能力直逼 H20 方案;6×Max-Q(576GB)FP4 后也能跑 671B 高画质。FP4 成熟后,Max-Q 集群与 H20 集群的容量差距将被架构红利部分抹平。
Q9:四方案的综合体验排序?
A:671B FP8 生产:8×H20 > 8×Max-Q ≫ 8×A100(不可行)= 6×Max-Q(不可行)。671B Q4:8×H20 > 8×A100 ≈ 8×Max-Q > 6×Max-Q(并发少)。训练:8×Max-Q > 6×Max-Q ≈ 8×A100 ≫ 8×H20。长文档 Prefill:8×Max-Q > 8×A100 > 6×Max-Q > 8×H20。性价比验证:6×Max-Q 第一。综合生产力:8×H20 推理第一,8×Max-Q 全能第一。
结语:1TB 时代,集群的本质是"负载分工"
H20 集群把 Decode 做到极致,Max-Q 集群把全能做到极致,A100 集群把带宽与多租户做到极致——政企级 AI 的终局不是"一张神卡",而是推理、训练、预处理的负载分工。UltraLAB 的混合架构与渐进投资路径,让百万级集群投资每一步都可验证、可回退。
关于 UltraLAB :
西安坤隆计算机科技有限公司,专注定制图形工作站与 AI 计算方案,提供 H20 合规整机(8 卡 1128GB)、RTX PRO Max-Q 集群(6-8 卡)、A100 验证货源的全栈交付,机房评估+驻场部署+72 小时烤机+整机质保。


