






一句话总结:当加拿大工程师 Ric Olsen 用 MongoDB + PostgreSQL/TimescaleDB + Grafana + HTML5 把垄断几十年的工业 SCADA 重写并开源后,"采集—存储—呈现—控制"这条工业数据链路的硬件底座该如何选?本文给出可落地的 UltraLAB 配置方案。
01 为什么这篇值得读:SCADA 的"开放生态"时代来了
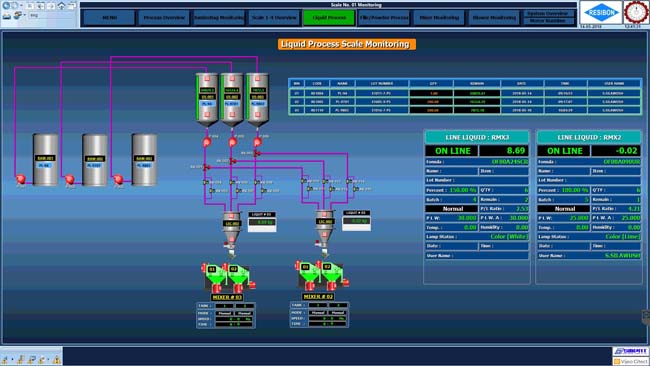
传统 SCADA(西门子、GE、艾默生、施耐德)的痛点众所周知:封闭协议、按点位收费的昂贵授权、绑定专用硬件、换供应商等于推倒重来。
JSON-SCADA 的核心思路非常"程序员"——SCADA 的本质就是"采集数据、存起来、画出来、能控制",于是用标准的开源 IT 技术栈自下而上重做一遍:
- MongoDB:实时核心数据库 + 持久层 + 配置存储 + SOE 事件顺序记录,用 Change Streams 做事件驱动异步处理
- PostgreSQL / TimescaleDB:时序历史数据库
- Grafana:对接历史库直接搭 SCADA 仪表盘
- Node.js / C# / Golang:多语言混合的采集与网关服务
- Nginx:HTTPS 网关与可视化出口
- HTML5 + MEAN/MERN:浏览器组态、手机可看、UTF-8 国际化
- 全系统 JSON 贯穿(NoSQL / schema-less):加测点、改字段不再动死板的点位表
一句话:用 IT 的开放生态,干掉 OT 的封闭垄断。而对于工程落地,软件栈一旦标准化,瓶颈就转移到了硬件底座——这正是 UltraLAB 工作站/服务器选型的价值点。
02 功能模块拆解:核心算法与计算特点
| 功能模块 | 核心算法 / 技术机制 | 计算特点 | 硬件敏感点 |
|---|---|---|---|
| 协议采集驱动(Modbus / OPC UA / IEC 60870-5-104 / DNP3 等) | 轮询调度 + 报文编解码(二进制帧解析、状态机) | 高频 I/O、低延迟、单线程事件循环为主 | 单核频率、网卡中断、串口/以太网并发数 |
| 边缘采集节点(Golang / C#,TLS 上行,可跑树莓派) | 轻量发布-订阅 + 断线缓存重传 | 常驻内存小、7×24 长稳、功耗敏感 | 可靠性 > 算力;ARM64 兼容 |
| MongoDB 实时核心(Replica Set) | Change Streams 变更流订阅 + Oplog 复制 | 内存型热数据、写密集、事件驱动 | 内存容量与带宽、NVMe 随机写 |
| SOE 事件顺序记录 | 时间戳排序 + 插入即索引(WiredTiger B-Tree) | 突发写入、毫秒级时间精度 | 磁盘 IOPS、时钟同步(NTP/PTP) |
| TimescaleDB 时序历史库 | Hypertable 自动分区 + 列式压缩 + 连续聚合(Continuous Aggregate) | 写多读少、压缩比高、范围查询 | 磁盘容量与顺序写吞吐、内存缓存 |
| Grafana / Metabase 可视化 | SQL 聚合查询 + 浏览器端渲染 | 查询并发中等、突发大屏刷新 | CPU 单核性能、GPU(多屏/大屏) |
| SVG 画面组态与 HMI(Inkscape 方案) | SVG DOM 差分刷新 + WebSocket 推送 | 图形元素多时渲染压力大 | GPU 2D 加速、显存 |
| MQTT / Sparkplug B 集成 | Broker 主题树路由 + 遗嘱消息 | 高并发连接、小报文洪峰 | 网络带宽、连接数(FD 上限) |
| RBAC 权限与 HTTPS 网关(Nginx) | TLS 握手 + JWT/OAuth 鉴权 | 握手 CPU 密集、加解密占核 | 单核性能、可选 TLS 硬件加速 |
关键结论:它不是"重算力"软件,而是"重 I/O + 重内存 + 重长稳"软件
JSON-SCADA 的算力画像与传统 CAE/AI 训练完全不同:
- CPU:需要的是高主频 + 足够并发(采集线程、Change Stream 消费者、TLS 握手),而非极限多核——16~32 核甜点区性价比最高;
- 内存:MongoDB 热数据集常驻内存,内存容量直接决定实时库性能上限;
- 磁盘:NVMe SSD 是必须的(Oplog + hypertable 压缩写),历史库容量按测点数 × 采样率规划;
- GPU:HMI 大屏、多屏 SVG、Grafana 渲染、以及 ML 数据分析扩展时才需要。
03 应用场景:官方清单与落地解读
| 应用场景 | 规模画像 | 架构建议 |
|---|---|---|
| 本地站 HMI(电力/油气/制造/水厂) | 单站数百~数万点 | 1 台 UltraLAB 塔式工作站全栈部署 |
| SCADA 协议网关 | 多协议汇聚转发 | 边缘小盒或 1U 机架,低功耗 ARM/x86 |
| SCADA 控制中心 | 多站汇聚,10 万点级 | 中心服务器集群 + 前端操作员工作站 |
| Historian 历史库 | 高频采样、多年留存 | 大容量 NVMe + 分层存储 |
| HTTPS 可视化网关(内网/公网) | 并发访问中等 | 前置 Nginx 节点 + TLS 卸载 |
| 多级系统集成(SCADA/IIoT/ERP/MES/PLC) | 企业级数据总线 | 中心库 + Kafka/MQTT 缓冲 |
| 边缘处理 | 站点分散、带宽有限 | 树莓派/边缘网关本地预处理 |
| 大数据 / ML 数据集中器 | 数字化转型、工业 4.0 | 中心库 + GPU 分析节点 |
部署形态覆盖:Windows Server 2019+(NSIS + NSSM)、RHEL 9 系、Ubuntu 24.04 LTS、Docker Compose、K8s、ARM64 边缘(树莓派 / Graviton / Apple Silicon),可水平扩展到 MongoDB 分片集群。
04 UltraLAB 硬件配置怎么选:四档落地方案
以下为 UltraLAB 图形工作站/服务器的典型配置档位(可按项目点数与预算定制),覆盖从边缘到中心集群。
| 档位 | 定位 | 建议配置 | 适用场景 |
|---|---|---|---|
| A 档 · 边缘采集型 | 现场采集节点 / 协议网关 | 8 核 CPU / 16GB 内存 / 512GB NVMe / 双千兆网口 / 无独显 / 宽温可选 | 单站 HMI、边缘网关、树莓派替代 |
| B 档 · 单节点全栈型 | 部门级一体部署 | 16 核 CPU / 64GB 内存 / 1TB NVMe + 4TB SSD / 入门专业显卡 4GB / 双网口 | 中小水厂、制造车间、1 万点内 |
| C 档 · 中心 Historian 型 | 控制中心 / 历史库服务器 | 32 核 CPU / 128GB 内存 / 2×2TB NVMe(RAID1)+ 16TB HDD 分层 / 8GB 显卡 / 万兆网卡 | 区域集控、10 万点级 historian |
| D 档 · 智能分析型 | 数据集中 + ML/AI 扩展 | 32 核 CPU / 256GB 内存 / 4TB NVMe / 高端 GPU(24GB+ 显存)/ 万兆 | 大数据、预测性维护、视觉分析 |
选型逻辑(给技术负责人的三条铁律)
- 先算点数:测点数 × 采样周期 ≈ 每秒写入量,决定 MongoDB 内存与磁盘 IOPS 下限;
- 内存给足 MongoDB:生产环境实测建议热数据集 ≤ 物理内存 50%;
- 显卡按需:纯采集存储不需要 GPU;上大屏、多屏 SVG、Grafana 轮播、ML 分析再上专业卡。
05 软件清单(全栈 BOM)
| 类别 | 软件 | 版本建议 | 作用 |
|---|---|---|---|
| 实时数据库 | MongoDB | 8.0+(Replica Set) | 实时核心 / 配置 / SOE |
| 时序数据库 | PostgreSQL + TimescaleDB | PG 18 + TimescaleDB 2.x | 历史趋势存储 |
| 可视化 | Grafana / Metabase | 最新稳定版 | 仪表盘 / 报表 |
| Web 服务 | Nginx | 稳定版 | HTTPS 网关 / 反代 |
| 采集服务 | JSON-SCADA Drivers | v0.64+ | 多协议驱动(OPC UA、IEC104、Modbus…) |
| 低代码编排 | Node-RED | 稳定版 | 规则引擎 / 二次开发 |
| 画面组态 | Inkscape + SVG Editor | 内置 | 工艺流程图组态 |
| 进程守护 | Supervisor / NSSM / Docker | — | 服务托管 |
| 消息总线 | MQTT Broker(Sparkplug B) | Mosquitto / EMQX | IIoT 数据接入 |
| 操作系统 | Windows Server 2019+ / Ubuntu 24.04 / RHEL 9 | — | 部署底座 |
06 常见问题:硬件配置深度答疑(FAQ)
| # | 问题 | 专业解答 |
|---|---|---|
| Q1 | 用消费级 PC 跑行不行? | 演示可以,生产不建议。7×24 长稳、ECC 内存纠错、RAID 冗余、双网隔离(IT/OT 网段分离)都是工业现场的硬要求,UltraLAB 工作站/服务器原生支持。 |
| Q2 | MongoDB 吃 CPU 还是吃内存? | 主要是内存。热数据集必须尽量常驻内存, Change Streams 的消费者数量随核数线性扩展,16~32 核即可吃满。 |
| Q3 | TimescaleDB 历史库要留多少盘? |
估算公式:测点数 × 采样率 × 单条字节数 × 保留天数 ÷ 压缩比(典型 8~20×)。10 万点、1 秒采样、存 1 年,建议裸容量 8TB 起,NVMe + HDD 分层。
|
| Q4 | 为什么推荐双网口甚至万兆? | 现场 OT 网(采集)与办公 IT 网(访问)必须物理/逻辑隔离;HMI 大屏与 historian 备份会打满千兆。中心节点上万兆是刚需。 |
| Q5 | GPU 到底要不要? | 只做采集存储:不要。多屏 4K SVG HMI、Grafana 大屏轮播、Metabase 报表:入门专业卡即可。跑 ML 预测性维护:24GB+ 显存。 |
| Q6 | ARM 边缘节点靠谱吗? | JSON-SCADA 官方支持 ARM64 一键脚本,树莓派级节点可承担单站采集上行,中心汇总仍在 x86 服务器,UltraLAB 双架构可选。 |
| Q7 | 双机热备怎么做? | MongoDB Replica Set 三节点天然实现自动故障转移;前端操作员工作站可两台冗余,配置 UltraLAB 同型号便于备件统一管理。 |
| Q8 | 时钟不同步导致 SOE 顺序错乱? | 全网络 NTP/PTP 统一授时,采集节点与服务器同源自愈,SOE 毫秒级排序才可信。 |
07 写在最后:软件开源了,硬件更要专业
JSON-SCADA 证明了 SCADA 可以不再被"点位授权"绑架,但它对长稳运行、内存容量、磁盘 I/O、网络隔离的要求一点没有降低——这些恰恰不是普通 PC 的强项,而是 UltraLAB 工作站与服务器的看家本领。
无论是单站 HMI 的一体化部署,还是十万点级的区域集控中心,选择合适的硬件档位,才能让开源软件栈真正扛起 7×24 的工业生产。
获取定制配置方案:提供测点数、采样率、保留周期与部署形态,即可输出专属 UltraLAB 选型清单与报价。
参考来源:公众号「物联网星球」《一个加拿大工程师,把垄断几十年的工业 SCADA 给开源了》;JSON-SCADA 官方仓库与部署文档。本文为行业应用分析,硬件配置为典型建议,最终以实际项目压测为准。
关键词:JSON-SCADA|开源 SCADA|UltraLAB 工作站|SCADA 服务器选型|工业数据采集|时序数据库|边缘计算


