






基于 Cadence SPB 26.1(OrCAD X / Allegro X)Release Notes 的深度技术解读,结合 EDA 负载特征,给出面向 PCB 设计、SI/PI 仿真与大模型本地部署的 UltraLAB 硬件配置选型方案。
一、核心软件分析:Cadence SPB 26.1 更新了什么
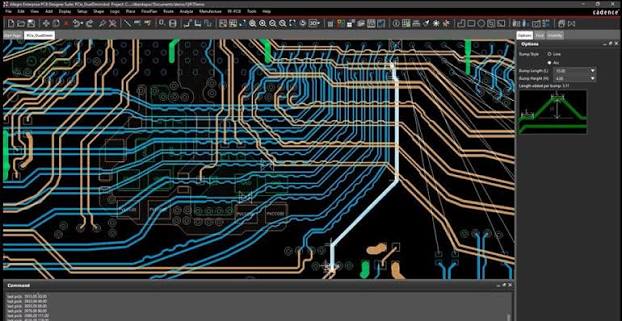
Cadence SPB 26.1 的核心变化集中在效率、可制造性与仿真精度三条主线。针对大板、高密板设计中"铜皮卡顿、封装繁琐、扇出难查"三大痛点,26.1 给出了实质性改进:
- 动态铜皮统一为 Dynamic 模式:原 Smooth / Fast 两模式合并,编辑时持续更新并实时预览最终形状;但遇到特殊 voiding 仍可能 out of date,出生产文件前需手动 "Update All"。
- 模板化封装生成器:Symbol Editor 新增 "Package symbol (template-based footprint)",内置数百个 IPC 标准模板,BGA 等复杂封装由数小时缩短为参数化生成。
- BGA 扇出 DFA 检查(5 项元件级装配规则):最小 Pitch 检查、焊盘全扇出检查、扇出方式一致性、扇出线宽一致性、过孔居中检查。
- Search 面板可编辑:搜索结果直接批量修改 Rotation / Width 等属性,替代手工 SKILL 脚本。
- Signal Explorer 退役:由 Topology Workbench 接管电气约束拓扑创建与拓扑仿真,新增 T-point 分支符号与 Mapping Tag 消歧机制。
- 高速参数化结构(Parameterized Structure):差分/单端过孔结构、回流过孔、keepout 全部参数化并可批量同步修改。
- PSpice 更新:太阳诱电、村田无源器件库入库(新增约 1 万+ 模型,总量超 48,000);电阻热噪声引入量子修正因子 x/(e^x−1),面向低温/量子计算读出电路场景。
二、主要核心算法及其计算特点
2.1 动态铜皮避让算法(Dynamic Shape Boolean Engine)
铜皮与走线/过孔/挖空之间的避让属于平面几何布尔运算 + 实时重铺铜,其特点是:
| 维度 | 特征描述 | 硬件敏感度 |
|---|---|---|
| 并行度 | 单线程为主(编辑期实时响应) | CPU 单核频率 |
| 数据规模 | 与铜皮数量、void 数量线性相关,大板可达数万 shape | 内存容量 / 内存延迟 |
| I/O 特征 | 数据库频繁读写,DBDoctor 批量校验 | NVMe 随机读写 |
结论:拉线卡顿不是显卡问题,是主频问题。
2.2 DRC / DFA 规则检查算法
26.1 新增 BGA 扇出 DFA 检查,本质是几何约束引擎的空间索引查询:
- 采用 R-Tree / 网格化空间索引加速海量对象(几十万 via + 几十万 pin)的邻近查询;
- DRC 全量检查支持多线程并行;
-
计算量随
(pin + via + cline + shape)数量近似平方增长,典型大板全量 DRC 内存占用 32~64GB。
2.3 布线搜索算法
Allegro 自动/交互式布线基于迷宫布线(Maze Routing)+ A* 启发式搜索 + 拓扑代价函数:
- 代价函数含线长、过孔数、层切换、阻抗连续性、串扰规避;
- 搜索空间随板面积与障碍物密度指数膨胀,属 CPU 密集型;
- 26.1 的 X AI 菜单(Advanced Substrate Router / Power-Ground Generator)引入 AI 辅助布线,对 GPU 无硬性要求,但 Tokens 授权与算力预留相关。
2.4 SI/PI 仿真算法:SPICE 引擎与 3D 全波求解
| 工具 | 算法内核 | 计算特点 | 硬件需求 |
|---|---|---|---|
| PSpice | 改进节点分析法(MNA),瞬态迭代求解 | 大规模电路瞬态仿真支持多线程;收敛性差时步长骤降 | 高主频 + 大内存 |
| Topology Workbench | 拓扑抽取 + 传输线方程(S 参数级联) | 单网络轻量,批量仿真吃多核 | 多核 CPU |
| Clarity 3D(Interconnect Model Extraction) | 3D 全波 FEM/FDTD 电磁场求解,输出 RLGC SPICE 模型 | 内存带宽密集型,并行规模化好 | 32~64 核 + 512GB 内存 |
| SystemPI | 频域阻抗分析 + 开关噪声 / 随机噪声源(26.1 新增 VRM 噪声模型) | 多端口 S 参数级联 | 多核 + 高速阵列 |
2.5 量子修正热噪声模型
经典热噪声 PSD = 4kTR,与频率无关。26.1 引入量子修正:
-
修正因子:
x / (e^x − 1),其中x = hf / kT; -
转折频率
f = kT/h:常温 300K 约 6.25 THz,液氦 4K 约 83 GHz,液氮 77K 约 1.60 THz; - 常温 100GHz 处修正量仅 0.8%——对常规板级电路"然并卵",但对低温量子计算读出电路是刚需。
三、UltraLAB 硬件配置怎么选
3.1 选型总原则
EDA 负载呈两极分化:交互设计(拉线、铜皮、Search)吃单核主频;批量任务(DRC、Artwork、PSpice 瞬态、Clarity 3D 求解)吃多核 + 内存容量/带宽。因此 UltraLAB 选型按角色分档:
| 档位 | 定位 | 典型用户 | 核心配置 | 参考内存 |
|---|---|---|---|---|
| U 系列 · 入门型 | 原理图 + 中小板 Layout | OrCAD Capture 用户、2~6 层板 | 8 核 5.0GHz+ / 专业显卡 8GB | 64GB |
| U 系列 · 主流型 | 高多层板 + 常规 SI | 16 层内服务器板、消费板 | 16 核 4.8GHz+ / RTX A2000 12GB | 128GB |
| H 系列 · 高端仿真型 | PSpice 大电路 + Sigrity | 高速背板、DDR5/LPDDR6 仿真 | 32 核 / 双路 48 核 + RTX 4000 Ada 20GB | 256~512GB |
| H 系列 · 旗舰场求解型 | Clarity 3D / SystemPI 系统级 | 封装基板、112G/PCIe7 信道 | 64 核双路 + 2× RTX 6000 Ada 48GB | 1TB |
| AI 扩展型 | 本地大模型 + AI 布线 | 研发团队私有化部署 | 旗舰 CPU + 4× 48GB GPU(或单卡 80GB) | 1TB+ |
3.2 关键部件选择逻辑
CPU:优先高主频(≥4.8GHz)保障交互流畅,核心数 ≥16 保障批量任务;Clarity 3D 建议 32 核起步,双路配置可近线性扩展。
内存:建议按"板子规模 × 4"估算——万 pin 级大板 Layout 128GB 起步;含 3D 求解直接 512GB;开启大内存盘(ramdisk)可显著加速 Artwork 与 DBDoctor。
显卡:Allegro 3DX Canvas 对 GPU 要求温和,RTX A2000(12GB)已够;若兼顾大模型推理或 AI 布线 Tokens,建议 RTX 6000 Ada(48GB)。
存储:系统盘 1TB NVMe + 项目盘 2×4TB NVMe RAID0(阵列有冗余风险需备份)+ 大容量 SATA 归档;临时交换分区放 NVMe。
四、软件清单
| 软件模块 | 版本 | 用途 | 授权要点(据 Release Notes) |
|---|---|---|---|
| OrCAD X Capture | 26.1 | 原理图设计 | SPB 基础包 |
| Allegro X PCB Layout | 26.1 | PCB Layout | 基础版即可 |
| Allegro X Venture | 26.1+ | 高级Layout(含 BGA DFA 检查) | ALGX400* 及以上 |
| Allegro X APD | 26.1+ | 封装/基板设计 | SIP4160*(Layout);Expert/Professional 免 Tokens,Layout 需加 X AI Tokens |
| PSpice | 26.1 | 模拟/混合信号仿真(含量子噪声修正) | 选项手动开启,常规行为不变 |
| Topology Workbench | 26.1 | 电气约束拓扑(替代 Signal Explorer) | Constraint Manager 内调用 |
| Sigrity / Clarity 3D | 26.1 | 3D 全波求解、RLGC/S 参数抽取 | Clarity 3D QS 引擎 |
| SystemPI | 26.1 | 电源完整性(新增 VRM 开关/随机噪声) | — |
| X AI(Advanced Substrate Router / PG Generator) | 26.1 | AI 辅助布线/电源地生成 | 需 X AI Tokens |
| SKILL API | 26.1 | 二次开发(新增 axlDBCheck、axlEventSetStartPopup) | 免费 |
五、应用场景与对应 UltraLAB 配置建议
| 应用场景 | 软件组合 | 负载特征 | 推荐 UltraLAB 配置 |
|---|---|---|---|
| 消费类板卡(手机/IoT) | OrCAD X + Allegro X | 单核交互为主 | U 系列:8C 5.0GHz / 64GB / RTX A2000 |
| 服务器/交换机主板(PCIe 7.0、112G) | Allegro X Venture + Topology Workbench | 单核 + 拓扑批量仿真 | U 高配:16C 5.0GHz / 128GB / RTX 4000 Ada |
| DDR5 / LPDDR6 / HBM4 存储仿真 | Sigrity 合规套件 + Topology Workbench(26.1 新增 LPDDR6/HBM4 报告) | 多核瞬态并行 | H 系列:32C / 256GB |
| 封装基板 / SiP | APD + X AI 路由器 | 网格布线 + Tokens | H 系列:32C / 512GB / GPU 48GB |
| 低温/量子计算读出电路 | PSpice(量子噪声修正开启) | 高精度瞬态 | H 系列:高主频 16C / 128GB |
| 软硬结合板(对齐 IDX V6) | Allegro X + Manage Bends | 常规 | U 系列即可 |
六、大模型本地部署:让 EDA 工作站一机两用
Cadence 26.1 已出现 X AI 菜单,EDA 与 AI 融合是明确方向。UltraLAB 工作站可通过加装 GPU 实现本地大模型私有化部署,服务三类场景:
- AI 辅助 Layout:脚本生成(SKILL/AXL 自动化)、约束规则问答、DFA 报告解读;
- 研发知识库:企业封装库、IBIS 模型库、设计规范的 RAG 检索;
- 代码/文档助手:嵌入式固件、Verilog 辅助编写。
| 模型规模 | 显存需求 | UltraLAB 推荐 GPU 方案 | 量化后可用性 |
|---|---|---|---|
| 7B~14B | 12~24GB | RTX 4070 Ti S 16GB / RTX A4500 20GB | 流畅 |
| 32B | 40~48GB | RTX 6000 Ada 48GB ×1 | 良好 |
| 70B | 80~160GB | RTX 6000 Ada ×2 / A100 80GB ×1 | 良好(Q4 量化) |
| DeepSeek-V3 / 671B 级 | 多卡集群 | H 系列 + 多节点扩展 | 建议蒸馏版 |
部署要点:vLLM / llama.cpp + Q4_K_M 量化;RAG 采用 bge-m3 向量模型;训练/微调另需考虑 NVLink 互联。
七、常见问题:硬件配置分析(FAQ)
| 问题 | 根因分析 | UltraLAB 建议 |
|---|---|---|
| Q1:拉大板每动一根线都卡? | 动态铜皮布尔运算为单线程负载 | 换 5.0GHz+ 高频 CPU,而非加显卡 |
| Q2:DRC 跑到一半爆内存? | 对象数平方级增长 + 空间索引 | 内存 128GB 起步,大板 256GB |
| Q3:PSpice 大电路仿真 overnight? | 瞬态迭代不收敛导致步长骤降 | 高主频 + 关闭冗余扫描,使用多核选项 |
| Q4:Clarity 3D 求解比预期慢 5 倍? | 内存不足触发 swap,带宽瓶颈 | 512GB 内存 + 关闭超线程以外的后台任务 |
| Q5:装了高端显卡还是卡? | Canvas 渲染非瓶颈,铜皮才是 | 预算向 CPU 主频与内存倾斜 |
| Q6:量子修正要不要开? | 常温板级差异 <1% | 常规设计关闭;低温/量子场景开启 |
| Q7:本地跑 70B 模型配一张 24GB 卡够吗? | Q4 量化后 70B 仍需 ~45GB | 单卡 48GB 或双卡 24GB(张量并行) |
| Q8:Signal Explorer 工程迁移后仿真变慢? | 拓扑需迁移至 Topology Workbench 重建 | 同步升级硬件至 16C 以上 |
结语
Cadence SPB 26.1 把"省时间"做到了铜皮、封装、扇出检查与批量编辑四个关键环节,而 Topology Workbench 与 Clarity 3D QS 引擎则把仿真精度推向系统级。软件算法决定负载形态,负载形态决定硬件选型——高频 CPU 保交互,大内存保规模,多核保仿真,GPU 保未来。UltraLAB 分档配置方案,让每一块复杂 PCB 从原理图到出光绘,都跑得顺、算得快、留有余量。


