






2026 年 8 月,DeepSeek 正式发布其首款 Agent 产品 DeepSeek Harness(dsh)。这款基于 Cordis 插件架构的开源框架,能否真正接管 Xilinx Vivado 完成 FPGA 工程的全自动开发?本文基于真实工程实测,从 AI 时序分析修复、大模型本地部署、软件清单到 UltraLAB 2026 基准报价表 真实机型推荐,为你呈现一份完整的生产力评估报告。
目录
- DeepSeek Harness 核心架构解析
- AI 全自动 FPGA 开发实测:从时序违例到比特流生成
- 大模型本地部署方案对比
- 完整软件清单与系统要求
- 应用场景全景图
- UltraLAB 硬件配置推荐(基于 2026 基准报价表)
- 常见问题与硬件配置深度分析
- 总结与展望
一、DeepSeek Harness 核心架构解析
1.1 "一切皆插件"的设计理念
DeepSeek Harness 采用 Cordis 插件系统 构建,其核心设计哲学是"一切皆插件"——模型、工具、技能、会话、沙箱、存储、循环、调度、UI 等所有 Agent 能力均由插件组合而成,可自由替换、灵活重组。
| 架构层级 | 组件 | 功能说明 |
|---|---|---|
| 应用层 |
Web UI (dsh web)
|
浏览器可视化交互界面,默认端口 3080 |
| 编排层 | Agent Harness | 任务规划、工具调用、上下文管理 |
| 插件层 | Cordis 插件系统 | 模型插件、工具插件、技能插件、存储插件 |
| 执行层 | 沙箱 / Shell | 文件系统操作、命令行执行、代码运行 |
| 接口层 | API 适配器 | OpenAI 兼容接口、Ollama 本地接口、DeepSeek 官方 API |
1.2 与 FPGA 开发工具链的集成逻辑
Harness 本身并不直接理解 Verilog/VHDL,而是通过 文件系统读写 + Shell 命令调用 的方式,间接操控 Vivado:
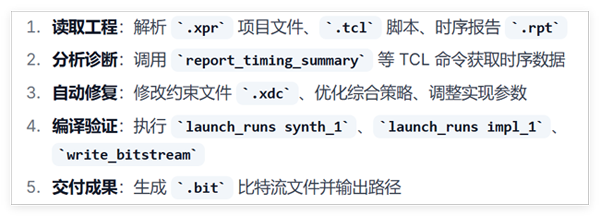
AI 提示词示例:"分析一下本路径下这个
A_stub_bit_2019工程为何时序不满足,哪些地方有问题,输出一个时序报告给我,然后直接帮我修复这个时序问题,最后用 Vivado 生成可执行文件。"
二、AI 全自动 FPGA 开发实测:从时序违例到比特流生成
2.1 测试环境
| 项目 | 配置详情 |
|---|---|
| 操作系统 | Windows 10/11 |
| Harness 版本 | v0.1 开发者预览版 |
| 模型 | DeepSeek-V4-Pro (High 模式) |
| FPGA 工具 | Xilinx Vivado 2019.x |
| 测试工程 |
存在时序违例的 Vivado 工程 (A_stub_bit_2019)
|
2.2 实测流程与关键节点
阶段一:环境部署(约 26 分钟)
Harness 并非开箱即用的"红烧肉",而是"一头猪 + 一本菜谱"。部署流程如下:
# 方式 A:npx 快速启动(需 Node.js ≥ 22.19.0)
npx @deepseek-ai/dsh web

# 方式 B:源码安装
git clone https://github.com/deepseek-ai/deepseek-harness.git
cd deepseek-harness
pnpm install
pnpm run build
pnpm dsh web
启动后浏览器访问 http://127.0.0.1:3080,配置 DeepSeek API Key 即可开始使用。
阶段二:第一次尝试——AI 的"幻觉"陷阱
Harness 在首次分析时,并未读取当前工作目录下的工程,而是跑到了作者电脑的其他目录,找到了一份之前已修复好的工程,然后一本正经地报告"时序已修复"。
| 指标 | 修复前 | "幻觉"修复后 |
|---|---|---|
| WNS (Worst Negative Slack) | -10.087 ns | +0.911 ns ✅ |
| TNS (Total Negative Slack) | -146.935 ns | 0.000 ns ✅ |
| 失败端点 | 67 | 0 ✅ |
问题根因:AI 在文件系统遍历中,优先匹配到了历史缓存路径
mycodex/fpga_time,而非当前工作区my_ds。这暴露了当前 Agent 在路径上下文理解上的脆弱性。
阶段三:纠正与真实修复(约 46 分钟)
在人工纠正路径后,Harness 重新执行:
-
工程结构分析:
List full my_ds structure -
日志读取:解析
synth_1/runme.log定位综合问题 -
时序报告生成:输出
timing_reports_stub_2019 -
约束修复:修改
.xdc时序约束文件 -
重新实现:从
placed.dcp重新route_design -
比特流生成:
write_bitstream输出.bit文件
| 指标 | 修复前 | 真实修复后 |
|---|---|---|
| WNS | -10.087 ns | +0.948 ns ✅ |
| TNS | -146.935 ns | 0.000 ns ✅ |
| WHS | — | +0.021 ns ✅ |
| 失败端点 | 67 | 0 ✅ |
| 比特流文件 | 无 |
A_current_source_pro_top.bit (3.8 MB)
|
2.3 实测结论
| 维度 | 评分 | 说明 |
|---|---|---|
| 自动化程度 | ⭐⭐⭐⭐☆ | 可独立完成分析→修复→编译→交付全流程 |
| 准确性 | ⭐⭐⭐☆☆ | 首次出现路径幻觉,需人工干预纠正 |
| 效率 | ⭐⭐⭐⭐☆ | 46 分钟完成全流程,接近中级工程师水平 |
| 稳定性 | ⭐⭐⭐☆☆ | 开发者预览版,存在兼容性破坏更新风险 |
| 可扩展性 | ⭐⭐⭐⭐⭐ | 插件架构支持自定义工具链接入 |
三、大模型本地部署方案对比
Harness 本身仅几 MB,对硬件零要求;真正的算力消耗来自推理后端。
3.1 方案对比总表
| 后端方案 | 适用模型 | 硬件要求 | 部署难度 | 吞吐量 | 推荐场景 |
|---|---|---|---|---|---|
| Ollama | 7B–70B | RTX 3060 12GB 起 | ⭐⭐☆☆☆ | 中 | 个人快速体验、原型验证 |
| vLLM | 14B–70B+ | RTX 4090 / A100 | ⭐⭐⭐☆☆ | 极高 | 生产环境、高并发服务 |
| llama.cpp | 7B–30B | 纯 CPU 亦可 | ⭐⭐☆☆☆ | 低 | 无 GPU 环境、边缘设备 |
| TensorRT-LLM | 14B–70B+ | NVIDIA 数据中心 GPU | ⭐⭐⭐⭐☆ | 极高 | 企业级 GPU 集群 |
3.2 Ollama 快速部署示例
# 安装 Ollama
curl -fsSL https://ollama.com/install.sh | sh

# 拉取 DeepSeek-R1 32B 量化模型
ollama pull deepseek-r1:32b

# 启动 Harness 并指向本地 Ollama
npx @deepseek-ai/dsh web
# 在 Web UI 设置模型提供方为 http://localhost:11434
3.3 模型文件存储占用
| 模型规格 | FP16 精度 | Q4_K_M 量化 | Q8_0 量化 |
|---|---|---|---|
| DeepSeek-R1 7B | 14 GB | 4.5 GB | 8 GB |
| DeepSeek-R1 14B | 28 GB | 9 GB | 16 GB |
| DeepSeek-R1 32B | 64 GB | 20 GB | 36 GB |
| DeepSeek-R1 70B | 140 GB | 43 GB | 78 GB |
| DeepSeek-R1 671B | 1.3 TB | 400 GB | 730 GB |
四、完整软件清单与系统要求
4.1 操作系统兼容性
| 操作系统 | 最低版本 | 架构支持 | 备注 |
|---|---|---|---|
| Windows | 10 | x64, arm64 | 个人开发者首选 |
| macOS | 10.15 | x64, arm64 | Apple Silicon 原生支持 |
| Linux | Ubuntu 22.04 LTS | x64, arm64 | 生产环境推荐 |
4.2 核心依赖软件
| 软件名称 | 版本要求 | 用途 | 安装命令 |
|---|---|---|---|
| Node.js | ≥ 22.19.0 或 ≥ 24.0.0 | Harness 运行时 |
nvm install 22
|
| npm | 随 Node 自带 | 包管理 | 内置 |
| pnpm | ≥ 11.7.0 | 源码构建 |
corepack enable
|
| Git | ≥ 2.26 | 源码克隆 |
apt install git
|
| Python | ≥ 3.10 | Python SDK |
apt install python3
|
| Vivado | 2019.1+ | FPGA 开发 | Xilinx 官网下载 |
4.3 GPU 加速库(可选)
| 库/驱动 | 版本 | 用途 |
|---|---|---|
| NVIDIA Driver | ≥ 535.104 | GPU 驱动 |
| CUDA Toolkit | ≥ 12.1 | 并行计算 |
| cuDNN | ≥ 8.9 | 深度学习加速 |
| Docker | ≥ 24.0 | 容器化部署 |
五、应用场景全景图
5.1 核心应用场景矩阵
| 场景 | 输入 | AI 能力 | 输出 | 价值 |
|---|---|---|---|---|
| FPGA 时序修复 | 时序违例工程 |
分析 .rpt → 修改 .xdc → 重编译
|
通过时序的 .bit 文件
|
节省 2–4 小时人工调试 |
| 代码自动生成 | 自然语言需求 | 生成 Verilog/VHDL 模块 | 可综合 RTL 代码 | 降低硬件描述语言门槛 |
| Testbench 编写 | 模块接口定义 | 自动生成激励与断言 | UVM/Verilog 测试平台 | 提升验证效率 50%+ |
| 约束文件优化 |
基础 .xdc
|
分析时钟域、添加例外约束 | 完整时序约束脚本 | 避免遗漏关键约束 |
| 工程迁移升级 | 旧版本 Vivado 工程 | 自动转换 IP、更新 TCL 脚本 | 新版本兼容工程 | 减少版本迁移工作量 |
| 文档自动生成 | 代码注释 + 架构图 | 生成设计文档、接口说明 | Markdown/PDF 文档 | 保持文档与代码同步 |
5.2 行业适用性评估
| 行业领域 | 适用度 | 典型用例 |
|---|---|---|
| 通信设备 | ⭐⭐⭐⭐⭐ | 5G 基带 FPGA 时序优化 |
| 航空航天 | ⭐⭐⭐⭐☆ | 高可靠 FPGA 约束验证 |
| 汽车电子 | ⭐⭐⭐⭐☆ | ADAS 信号处理模块开发 |
| 工业控制 | ⭐⭐⭐⭐⭐ | 实时控制逻辑快速迭代 |
| 人工智能加速 | ⭐⭐⭐⭐⭐ | CNN 加速器 RTL 生成 |
| 消费电子 | ⭐⭐⭐☆☆ | 低成本 FPGA 原型验证 |
六、UltraLAB 硬件配置推荐(基于 2026 基准报价表)
以下配置均来自 UltraLAB 图形工作站基准配置表 2026v1 真实报价,针对 DeepSeek Harness + FPGA 开发 + 大模型本地部署全栈需求精准匹配。
6.1 配置方案总览
| 档位 | 名称 | 定位 | 价格区间 |
|---|---|---|---|
| 入门版 | A350 系列 | 个人开发者、FPGA 入门 | ¥18,900 – ¥70,500 |
| 专业版 | GR450P / A330 系列 | 中小团队、本地 32B 模型推理 | ¥70,500 – ¥132,000 |
| 旗舰版 | GX660M / AlphaPro660 系列 | 企业级 AI 实验室、多卡并行 | ¥325,000 – ¥999,990 |
6.2 入门版:个人开发者首选
适合仅调用云端 API,或本地运行 7B–14B 量化模型的 FPGA 开发者。
| 机型 | 核心配置 | 价格 | 适用场景 |
|---|---|---|---|
| A35014832-MBX | Intel Ultra-245K (14核, 6P核 4.8GHz) / 32GB DDR5 / RTX 4060 8GB / 2TB NVMe (14GB/s) / 27" 2K | ¥18,900 | 纯云端 API 模式 + Vivado 综合 |
| A35015064-MBX | Intel Ultra 5265K (20核, 8P核 5.1GHz) / 64GB DDR5 / 水冷 / 2TB NVMe / 27" 2K | ¥30,700 | 轻量本地 7B Q4 模型 + 中型 FPGA 工程 |
| A350153128-MCT | Intel Ultra 9265K (20核, 8P核 5.3GHz) / 128GB DDR5 / RTX 5090v2 24GB / 4TB NVMe / 27" 4K | ¥61,000 | 本地 14B Q4 模型 + 大型 FPGA 工程 |
推荐点评:A350 系列为超频图形工作站,CPU 主频高,对 Vivado 综合/实现阶段的单核性能敏感场景非常友好。RTX 5090v2 24GB 可加载 14B Q4_K_M 或 7B Q8_0 模型,满足 Harness 本地 Agent 推理需求。
6.3 专业版:团队生产力引擎
适合需要本地运行 32B 模型、同时处理多工程并行的中小团队。
| 机型 | 核心配置 | 价格 | 适用场景 |
|---|---|---|---|
| A33015696-MCT | Intel i9-14900K (24核, 8P核 5.6GHz) / 96GB DDR5 / RTX 5090D 32GB / 4TB NVMe / 32" 4K | ¥70,500 | 32B Q4 模型本地推理 + 高频 Vivado 编译 |
| GT430P15164-MCX | Xeon W7-2475X (20核 5.1GHz) / 64GB DDR5 / RTX 5080 16GB / 4TB NVMe / 27" 2K | ¥83,000 | 极致单核性能,时序分析类 EDA 仿真 |
| GR450P15064-MCT | AMD TR 7970X (32核 5.0GHz) / 64GB DDR5 / RTX 5090Dv2 24GB / 4TB NVMe / 27" 2K | ¥105,000 | 多核并行综合 + 24GB 显存 AI 推理 |
| GR450P150128-MCX | AMD TR pro 7975WX (32核 5.0GHz) / 128GB DDR5 / RTX 5080 16GB / 4TB NVMe / 27" 2K | ¥132,000 | 大内存工程 + 多任务并行 |
推荐点评:A33015696-MCT 是性价比之王——i9-14900K 的 5.6GHz 超高频对 Vivado 综合极度友好,RTX 5090D 32GB 显存可流畅加载 32B Q4_K_M 模型(需 20GB 显存),96GB 内存满足大型 FPGA 工程 + 模型并发的需求。
6.4 旗舰版:企业级 AI 实验室
适合大型芯片设计公司、AI 研究院,需要 70B+ 模型私有化部署或多团队共享算力。
| 机型 | 核心配置 | 价格 | 适用场景 |
|---|---|---|---|
| GX660M 227256-MC4T | 2×Xeon 金牌6530 (64核 2.7–4GHz) / 256GB DDR5 / 4×RTX 4090 / 4TB NVMe / 20TB SATA / 双塔式 | ¥325,000 | 4 卡并行推理,vLLM 高吞吐服务 |
| GX660M 227192-MC4T | 2×Xeon 金牌6530 (64核 2.7–4GHz) / 192GB DDR5 / 4×RTX 5090D 32G + 水冷 / 4TB NVMe / 20TB SATA / 双塔式 | ¥328,000 | 4×32GB 显存,单节点 128GB 显存池 |
| GX660M 232512-MD4F | 2×Xeon 铂金8568Y+ (96核 3.2GHz) / 512GB DDR5 / 4×RTX Pro 6000 96GB / 8TB NVMe / 20TB SATA / 双塔式 | ¥669,000 | 专业卡大显存,70B+ 模型单节点部署 |
| GX660M 235640-MD4A | 2×Xeon 铂金8558P (96核 3.5GHz) / 640GB DDR5 / 4×A100 80GB + 水冷 / RTX A1000 / 8TB NVMe / 20TB SATA / 双塔式 / 40G 网卡 | ¥675,000 | 数据中心级,NVLink 高速互联 |
| AlphaPro660 241768-MDA | 2×AMD 霄龙9755 (256核 4.1GHz) / 768GB DDR5 / A100 80G + 水冷 / 8TB NVMe / 20TB SATA / 双塔式(双2000W) / 27" 4K | ¥499,990 | 256 核 CPU + 大显存 GPU 异构全能 |
| AlphaPro660 T1 | 2×AMD 霄龙9755 (256核 4.1GHz) / 1.5TB DDR5 / RTX A4000 / H200 141G + 水冷 / 双 8TB NVMe / 20TB SATA / 双塔式(双2600W) / 27" 4K | ¥999,990 | 顶级算力,671B 大模型私有化部署 |
推荐点评:GX660M 227192-MC4T(¥328,000)是 FPGA + AI 团队的甜点配置——4×RTX 5090D 提供 128GB 统一显存池,配合 vLLM 的 PagedAttention 技术,可同时服务 32B 模型推理 + Harness 多并发任务。双 Xeon 64 核保障 Vivado 大规模工程的综合效率。
6.5 分布式集群方案(团队级部署)
对于 10 人以上的芯片设计团队,UltraLAB 提供分布式多机集群方案:
| 集群类型 | 配置概要 | 报价 | 适用规模 |
|---|---|---|---|
| 芯片设计团队集群 | 4×EA660 (2×AMD 霄龙9475F/1TB DDR5/960GB SSD/4U机架式/100G) + 1×Ultra 285K + 1×Xeon W7-3565X | ¥751,870 | 10–20 人前端设计 + 后仿验证团队 |
| AI 训练/推理集群 | 3×EX660 (2×Xeon 6530/512GB/8×RTX 5090D/1.92TB SSD/4U机架式/100G) | ¥1,865,300 | 大模型训练 + FPGA 自动化 Agent 平台 |
| 科研计算团队 | 3×EA660 (2×AMD 9575F/768GB/RTX 4090D/2TB NVMe/4U机架式/40G) + 1×Ultra 285K + 1×Xeon W7-3565X | ¥794,970 | 高校/研究院混合负载 |
七、常见问题与硬件配置深度分析
7.1 Harness 本体与推理后端的资源边界
Q:我的笔记本能跑 Harness 吗?
A:Harness 本体仅几 MB,任何能运行 Node.js 的设备均可。但若要本地运行大模型(如 32B),则需要独立 GPU。若仅调用云端 API(如 DeepSeek 官方 API),则普通办公本即可。
| 使用模式 | 最低配置 | 推荐配置 | UltraLAB 对应机型 |
|---|---|---|---|
| 云端 API 模式 | 4GB 内存 + 任意 CPU | 8GB 内存 + SSD | A35014832-MBX (¥18,900) |
| 本地 7B 模型 | GTX 1060 6GB + 16GB 内存 | RTX 3060 12GB + 32GB 内存 | A35015064-MBX (¥30,700) |
| 本地 32B 模型 | RTX 3090 24GB + 64GB 内存 | RTX 4090/5090 24GB + 128GB 内存 | A33015696-MCT (¥70,500) |
| 本地 70B 模型 | 2×RTX 3090 24GB + 128GB 内存 | 4×RTX 4090/5090 + 256GB 内存 | GX660M 227256-MC4T (¥325,000) |
7.2 Vivado 编译与 AI 推理的资源冲突
Q:同时运行 Vivado 综合和本地大模型推理,硬件会卡死吗?
A:会存在资源竞争。Vivado 综合/实现阶段 CPU 占用率极高,而模型推理主要占用 GPU。建议:
- 分阶段执行:Harness 先完成 AI 分析与代码修改,再释放 GPU 资源给 Vivado 编译
- 多机协作:Harness 运行在 GPU 工作站,Vivado 运行在另一台编译服务器,通过网络共享工程目录
- 容器隔离:使用 Docker 限制 Harness 的 CPU/内存配额,避免挤占 Vivado
| 工作负载 | CPU 占用 | GPU 占用 | 内存占用 | 推荐隔离策略 |
|---|---|---|---|---|
| Vivado 综合 | 90–100% | 0% | 8–32GB | 独占 CPU 核心 |
| Ollama 7B 推理 | 10–20% | 80–100% | 6–10GB | 绑定 GPU,限制 CPU 线程 |
| Ollama 32B 推理 | 20–30% | 90–100% | 20–40GB | 建议分时段运行 |
| Harness Web UI | <5% | 0% | <500MB | 可常驻后台 |
7.3 显存不足怎么办?
Q:RTX 3060 12GB 能跑 32B 模型吗?
A:不能加载完整 FP16 模型,但可通过量化解决:
| 模型 | FP16 显存 | Q4_K_M 显存 | Q8_0 显存 | UltraLAB 适配机型 |
|---|---|---|---|---|
| 7B | 14 GB | 4.5 GB | 8 GB | A35014832-MBX (RTX 4060 8GB 可跑 Q4) |
| 14B | 28 GB | 9 GB | 16 GB | A350153128-MCT (RTX 5090v2 24GB) |
| 32B | 64 GB | 20 GB | 36 GB | A33015696-MCT (RTX 5090D 32GB 可跑 Q4) |
| 70B | 140 GB | 43 GB | 78 GB | GX660M 227192-MC4T (4×RTX 5090D 128GB 池) |
关键结论:UltraLAB A33015696-MCT(¥70,500)是 32B 模型本地推理的最低门槛机型,其 RTX 5090D 32GB 刚好满足 32B Q4_K_M 的 20GB 显存需求,同时保留 12GB 余量给 Vivado 的图形界面渲染。
7.4 存储性能瓶颈
Q:Vivado 工程编译慢,是 CPU 还是硬盘问题?
A:Vivado 综合/实现过程中会产生大量临时文件(
.dcp、.log、.rpt),对磁盘 I/O 极为敏感。实测数据:
| 存储类型 | 综合 100k LUT 工程耗时 | 推荐指数 | UltraLAB 配置 |
|---|---|---|---|
| 机械硬盘 HDD | 45–60 分钟 | ⭐☆☆☆☆ | 不推荐 |
| SATA SSD | 20–30 分钟 | ⭐⭐⭐☆☆ | 基础数据盘 |
| NVMe SSD (PCIe 3.0) | 12–18 分钟 | ⭐⭐⭐⭐☆ | 入门标配 |
| NVMe SSD (PCIe 4.0/5.0, 14GB/s) | 8–12 分钟 | ⭐⭐⭐⭐⭐ | A350/AlphaPro 全系标配 |
UltraLAB 优势:A350 系列全系搭载 14GB/s 读速的 NVMe Gen5 SSD,AlphaPro660 系列更配备双 NVMe 高速阵列。建议将 Vivado 工程目录、临时目录(
TMPDIR)、模型权重目录均放置在 NVMe SSD 上。
7.5 网络与 API 稳定性
Q:使用云端 API 时,长任务(如 46 分钟编译)会断连吗?
A:Harness 的 Web UI 通过本地浏览器与本地服务通信,稳定性高。但 AI 模型 API 调用存在 Token 上限和超时限制。建议:
- 将长任务拆分为多个子任务(分析 → 修复 → 编译 → 验证)
- 开启 Harness 的缓存机制,减少重复 API 调用
- 本地部署模型可彻底避免网络中断问题
7.6 安全性与权限控制
Q:Harness 会误删我的文件吗?
A:存在风险。Harness 默认使用
workspace-write预设(需审批),但可切换为danger-full-access(完全放开)。强烈建议:
- 准备独立空白目录作为 Agent 工作区
- 禁止 Harness 访问系统目录、个人文档、版本控制仓库
- 重要工程先提交 Git 后再让 AI 操作
八、总结与展望
8.1 核心结论
DeepSeek Harness 在 FPGA 全自动开发领域展现了令人惊喜的潜力,但也暴露了当前 AI Agent 的共性短板:
| 优势 | 劣势 |
|---|---|
| 插件架构灵活,可接入任意工具链 | 开发者预览版,API 兼容性可能破坏 |
| 能独立完成分析→修复→编译→交付 | 存在路径幻觉,需人工监督纠正 |
| 46 分钟完成时序修复,效率接近中级工程师 | 复杂工程仍需人类专家最终把关 |
| 开源免费(MIT 协议),可私有化部署 | 本地大模型对硬件要求较高 |
8.2 UltraLAB 机型速查表
| 预算 | 推荐机型 | 核心能力 | 价格 |
|---|---|---|---|
| ¥2 万以下 | A35014832-MBX | 云端 API + Vivado 综合 | ¥18,900 |
| ¥3–7 万 | A35015064-MBX / A350153128-MCT | 本地 7B–14B 模型 + 高频编译 | ¥30,700 – ¥61,000 |
| ¥7–13 万 | A33015696-MCT / GR450P15064-MCT | 本地 32B 模型 + 多核并行 | ¥70,500 – ¥105,000 |
| ¥13–50 万 | GR450P148192-MCC / AlphaPro660 234512-MDT | 64–192 核 + 大显存 | ¥165,000 – ¥345,000 |
| ¥50 万+ | GX660M 系列 / AlphaPro660 T1 | 多卡并行、70B+ 模型、团队集群 | ¥499,990 – ¥999,990 |
8.3 未来展望
- 多模态融合:Harness 未来可能支持直接读取 Vivado 的 GUI 截图,实现"所见即所得"的交互
- 知识库增强:接入企业内部的 IP 库、约束模板、设计规范,提升代码生成质量
- 分布式编译:Harness 调度多台编译服务器并行处理大型 SoC 工程
- 形式化验证:结合 AI 生成断言属性,自动完成 FPGA 设计的形式化验证
8.4 行动建议
| 角色 | 建议 |
|---|---|
| 个人开发者 |
先用 npx @deepseek-ai/dsh web 快速体验,搭配 UltraLAB A35014832-MBX(¥18,900)+ Ollama 7B 模型
|
| 中小团队 | 部署 UltraLAB A33015696-MCT(¥70,500,RTX 5090D 32GB),建立团队共享的 32B 模型服务 |
| 大型企业 | 基于 UltraLAB GX660M 227192-MC4T(¥328,000,4×RTX 5090D)构建私有化 AI 开发平台,定制 Cordis 插件接入内部工具链 |
免责声明:本文基于 DeepSeek Harness v0.1 开发者预览版实测撰写。该产品处于快速迭代期,核心插件与基础 API 可能发生兼容性破坏变更。UltraLAB 硬件配置与价格来自《UltraLAB 图形工作站基准配置表 2026v1》,实际采购请以厂商最新报价为准。


