






摘要:城市级微观交通仿真(百万车辆、24 小时)在 SUMO 等传统 CPU 工具上耗时过长,制约校准与优化闭环。2025 年发表的 ParSim 研究将微观仿真内核整体移植到 CUDA GPU,在博洛尼亚 100 万次出行场景上报告了相对 SUMO 最高约 5000 倍的加速。本文解析其并行机制与硬件含义。
适用读者:交通工程研究者、车路协同/自动驾驶仿真团队、城市交通规划机构。
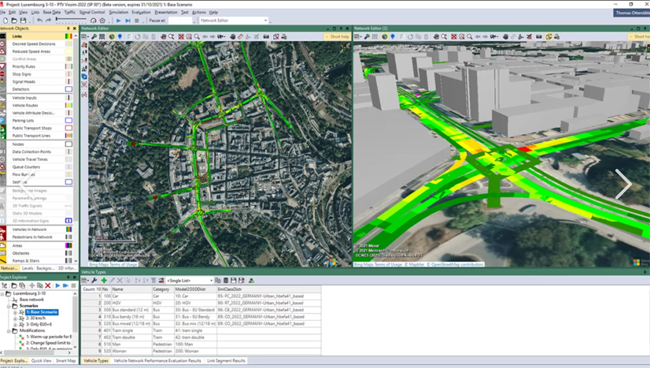
一、资料背景与核心观点
- 资料名称:An Efficient Parallelization of Microscopic Traffic Simulation,Applied Sciences(MDPI),2025。
- 原文链接:https://www.mdpi.com/2076-3417/15/13/6960;SUMO 官网:https://eclipse.dev/sumo/。
核心观点:作者开发 CUDA 版微观仿真器 ParSim,对内存布局与线程同步做专门设计。结果:博洛尼亚 24 小时、100 万次出行场景 GPU 上约 40 秒完成,相对单核 CPU 上 SUMO 提速 1800—5000 倍;旧金山湾区 24 小时、2800 万次出行场景 26 分钟完成。作者同时指出简化交叉口处理会高估通行能力,结果可比性须在同一路网与出行需求下评估——即加速比是针对其简化模型的报告值,不构成对 SUMO 的通用替代结论。
二、主要功能模块与核心算法
- 跟驰与换道模型:IDM/Gipps 类微观行为规则,逐车辆逐时间步更新。
- 路网数据结构:车道-连接关系图;GPU 化需将车辆状态组织为 SoA 连续数组以利用合并访存。
- 路径规划:动态路由(SUMO 中可多线程执行),GPU 路线中路由通常仍留在 CPU。
- 信号灯与交叉口逻辑:冲突消解是串行倾向最强的环节,也是 ParSim 相对 SUMO 简化最多之处。
- 并行路线谱系:文献综述显示微观仿真并行化有 MPI 域分解(TRANSIMS)、多线程(POLARIS)、GPU(本文及 MANTA/LPSim)等多条路线。
三、计算特点与性能瓶颈
3.1 CPU 路线(SUMO 主流用法)
- 单时间步内车辆更新有数据依赖,SUMO 本体并行能力有限(路由可多线程);大城市场景单核耗时长。
- 实用加速手段:多场景/多随机种子并发(标定与优化闭环天然批量)、子区域切分。
3.2 GPU 路线(ParSim 类研究代码)
- 车辆级更新规则统一、数据并行度高,适合 SIMT;瓶颈在分支发散(交叉口逻辑)与全局同步。
- 显存容纳千万级车辆状态绰绰有余(每车辆状态量小),消费级/专业级 GPU 均可胜任。
3.3 负载配比
仿真本体之外,需求生成、路网转换(netconvert)、结果聚合为 CPU+I/O 负载;批量标定场景的总吞吐取决于"单场景耗时 × 并发数"。
四、典型应用场景
- 城市级交通评估:信号配时方案、潮汐车道、施工影响分析。
- 自动驾驶/车路协同:大规模背景交通流生成。
- 需求模型校准:迭代调用仿真的参数寻优闭环(对仿真速度最敏感)。
- 应急疏散仿真:大范围路网高负荷场景。
五、UltraLAB 硬件配置建议
| 档位 | CPU 选型思路 | 内存 | GPU 与显存 | 系统盘/项目盘/数据盘 | 散热/电源/扩展 | 适用场景 |
|---|---|---|---|---|---|---|
| 入门级 | 16 核高主频 | 64 GB | 单卡 16 GB(SUMO 无需,GPU 研究向) | 1 TB NVMe + 2 TB NVMe | 风冷,850 W | 区县尺度 SUMO、教学 |
| 主流级 | 32 核 | 128 GB | 单卡 24—48 GB(GPU 仿真研究/多场景并发) | 2 TB NVMe + 4 TB NVMe | 高规格风冷,1200 W | 城市级 SUMO 批量标定、ParSim 类研究 |
| 高性能级 | 64 核 | 256—512 GB | 2—4 卡 48 GB | 2 TB NVMe + 8 TB NVMe + 归档 | 液冷可选,2000 W+ | 超大都市圈、多智能体耦合、校准优化大闭环 |
说明:ParSim 为研究原型而非开箱即用产品;若工作流基于 SUMO,硬件收益主要来自多核并发批量仿真,GPU 投资应与自研/合作开发的 GPU 仿真器计划绑定。
六、软件清单
| 类别 | 软件 | 必需性 |
|---|---|---|
| 微观仿真器 | Eclipse SUMO;ParSim/MANTA(GPU 研究原型) | 必需(按需) |
| 路网工具 | netconvert、OSM Web Wizard、JOSM | 必需 |
| 控制接口 | TraCI(Python) | 必需 |
| 校准优化 | 自研 Python 循环、Optuna 等 | 可选 |
| 可视化 | sumo-gui、Kepler.gl | 可选 |
| 运行环境 | CUDA(GPU 路线) | 按需 |
七、常见问题(FAQ)
Q1:SUMO 本身能多核并行吗?
仿真主循环基本单核(路由可多线程);实用做法是"多场景并发"而非单场景加速。32 核机器并发 20+ 场景,标定闭环吞吐近似线性提升。
Q2:GPU 千倍加速可信吗?
论文报告的 1800—5000 倍是在其简化交叉口模型的 GPU 原型上、相对单核 SUMO 的对比;SUMO 细节更丰富,两者并非同精度对比。方向可信(GPU 适合大规模微观仿真),数字不宜直接外推。
Q3:城市级 SUMO 场景内存要多少?
百万车辆 + 大城市路网通常 16—32 GB 内;批量并发按场景数乘算,128 GB 支撑 10—20 个并发场景较从容。
Q4:自动驾驶背景交通为什么需要快仿真?
RL/规划算法训练需要海量交互回合,仿真速度直接决定训练墙钟时间;这也是 GPU 交通仿真与 Isaac/Gym 生态结合的研究热点。
八、总结与选型建议
微观交通仿真的选型主线是"SUMO 路线堆 CPU 核数做并发,GPU 路线看研究代码成熟度"。工程落地以多核大内存 CPU 工作站为主;有自研 GPU 仿真器计划的团队再配 1—2 块高显存卡。采购前用目标路网规模实测单场景耗时,据此反推并发数需求。
边界声明:ParSim 加速数字为论文在特定场景与简化模型下的报告值;SUMO 的并行能力随版本演进,以官方文档为准。
参考来源
- An Efficient Parallelization of Microscopic Traffic Simulation. Applied Sciences, 2025. https://www.mdpi.com/2076-3417/15/13/6960
- Eclipse SUMO 官方网站. https://eclipse.dev/sumo/
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



